Google a annoncé le 15 octobre 2026 davantage de liens dans AI Mode et les Aperçus IA, placés plus haut dans les réponses, avec un ou deux liens mis en avant pour certaines requêtes.
Les carrousels d'articles d'actualité sont étendus à de nouvelles régions et langues, et Google affirme que l'usage de la fonction « Sources préférées » a été multiplié par plus de sept.
Selon Chartbeat, cité par Le Figaro, les sites d'information ont perdu 40 % de leur trafic venu de Google entre juillet 2025 et juillet 2026, une période marquée par l'essor des résumés IA.
Google ne fournit toujours pas de données de clics issues de ses réponses IA dans ses rapports, ce qui empêche les éditeurs et référenceurs de mesurer l'effet concret de ces nouveaux formats de liens.
Google remonte et multiplie les liens dans ses réponses IA
Pour rappel, les AI Overviews génèrent un résumé en tête des résultats classiques, tandis qu’AI Mode ouvre une interface conversationnelle séparée, avec une réponse plus développée. Lancés respectivement en mai 2024 et en mars 2025 aux États-Unis, ils sont arrivés en France sous les noms d’Aperçus IA et de Mode IA.
Premier changement : les liens contextuels, insérés directement dans le texte généré, deviennent plus nombreux. Google les placera aussi « plus fréquemment » dans la partie haute de la réponse, là où l’attention de l’internaute est la plus forte.
Deuxième changement : pour certaines requêtes, Google affichera un ou deux liens vers ce qu’il considère comme la « bonne page web ». Search Engine Roundtable précise que ce traitement est réservé aux requêtes qui le justifient, sans que Google ne détaille les critères de sélection.
Carrousels, articles connexes et profils : le détail des autres nouveautés
Des carrousels d’actualité dans plus de pays
Google étend ses carrousels d’articles liés à l’actualité. Il s’agit de vignettes affichées sous le résumé, avec le titre de l’article et une image d’illustration. Le Figaro évoque une extension « au monde entier », quand Search Engine Roundtable parle plus prudemment de nouvelles régions et langues.
Selon les informations partagées, ces carrousels privilégieront les articles publiés par des sources identifiées par l’internaute. Une variante reprendra des publications issues des réseaux sociaux ou de forums lorsque la requête porte sur des avis ou des points de vue.
La fonction « Sources préférées » en forte hausse
Google affirme que le nombre de personnes utilisant les « Sources préférées » a été multiplié par plus de sept. Pour rappel, cette fonction permet à l’internaute de désigner les médias qu’il souhaite voir apparaître en priorité. Il y a quelques jours, Google a d'ailleurs commencé à envoyer des informations sur ces sources préférées. Le chiffre est déclaratif : Google ne communique ni la période de référence, ni le volume de départ.
Des articles connexes plus visibles
Les liens affichés en fin de réponse, destinés aux internautes qui veulent approfondir, bénéficient d’un design plus visible, avec des vignettes, selon les captures publiées.
Des profils de créateurs qui renvoient d’abord vers Google
Dernier test en cours : sur les vidéos affichées dans AI Mode, le nom du créateur ou de l’éditeur est désormais cliquable. Mais comme le souligne Barry Schwartz, ce lien mène d’abord à une page de profil hébergée par Google, et non au site ou à la chaîne du créateur. Autrement dit, ce nouveau lien garde l’internaute dans l’écosystème de Google avant tout clic sortant.
Les données de clics restent absentes des rapports
C’est le principal angle de critique de Barry Schwartz. Google répète que ces évolutions visent un design « plus cliquable », mais ne fournit toujours aucune donnée de clics dans ses rapports de performance dédiés à l’IA.
Interrogé par le journaliste, Google a répondu qu’il continuait d’échanger avec les propriétaires de sites pour identifier les indicateurs les plus utiles, et qu’il ajouterait « des indicateurs supplémentaires au fil du temps ». Aucun calendrier, aucun engagement sur les clics.
Rappelons que le clic est la métrique que les éditeurs réclament en priorité, et qu’elle constitue aussi l’indicateur central de Google Ads. Le contraste est difficile à ignorer : Google mesure précisément les clics quand il les vend, mais ne les partage pas quand il s’agit d’évaluer le trafic qu’il renvoie gratuitement.
Barry Schwartz qualifie par ailleurs cette annonce de nouvelle itération parmi de nombreuses autres, avec le sentiment que les tentatives précédentes pour générer des clics depuis la recherche IA n’ont pas donné les résultats escomptés.
Un énième ajustement face à l’érosion du trafic des éditeurs
Le contexte chiffré éclaire la portée de l’annonce. Lors de la présentation des résultats du deuxième trimestre 2025, Sundar Pichai, PDG d’Alphabet, indiquait que les Aperçus IA comptaient plus de deux milliards d’utilisateurs mensuels dans plus de 200 pays, rappelle Le Figaro.
Dans le même temps, plusieurs études ont établi que les résumés IA réduisent nettement les clics vers les liens proposés. Le Figaro cite un rapport de Chartbeat selon lequel les sites d’information ont perdu 40 % de leur trafic venu de Google entre juillet 2025 et juillet 2026. D’autres estimations évoquent des baisses comprises entre 30 % et 60 % selon les sites.
En France, le sujet a pris une dimension juridique. En août, l’Alliance de la presse d’information générale (Apig), qui représente les quotidiens français, a saisi l’Autorité de la concurrence. Elle estime que les résumés IA contreviennent aux accords conclus en 2022 entre Google et les éditeurs, dans le cadre des droits voisins. Pour rappel, les droits voisins encadrent la rémunération due aux éditeurs de presse pour la réutilisation de leurs contenus par les plateformes.
Un geste qui sert d’abord l’intérêt de Google
Le timing de l’annonce n’est pas anodin. Face à des éditeurs qui dénoncent publiquement leurs pertes et à une procédure ouverte devant l’Autorité de la concurrence, rendre les liens plus visibles permet à Google d’afficher une bonne volonté, sans fournir la donnée qui permettrait de la vérifier.
Le discours n’est pas nouveau. À chaque vague de critiques depuis le lancement des AI Overviews, Google a répondu par des ajustements d’interface présentés comme favorables aux clics.
Il existe aussi un intérêt plus structurel. Les réponses générées par Google reposent sur les contenus publiés par les sites. Si les éditeurs perdent leur modèle économique fondé sur le trafic et la publicité, ils risquent de produire moins ou de bloquer les robots d’exploration. Sans contenus frais, l’IA de Google n’a plus de matière à synthétiser, en particulier sur l’actualité. Maintenir un minimum de trafic sortant revient donc à protéger la source d’approvisionnement de ses propres réponses.
D'après Nozzle, 8 % des SERP collectées depuis le 13 septembre 2026 sont « empoisonnées », contre 0,17 % entre le 20 août et le 9 septembre, avec un pic à un quart des pages du 27 au 29 septembre.
Ces pages s'affichent sans erreur ni captcha, mais leurs résultats organiques ne conservent que 20,7 % des sites habituels de la requête, au profit notamment de Reddit, Facebook et LinkedIn.
Un site suivi sort du top 10 sur 58,6 % des SERP empoisonnées, mais 77,9 % d'entre elles retrouvent leurs sites habituels dans les trois jours qui suivent.
Avant de signaler une chute de positions à un client, Rémy Blanchard (Foxglove) recommande de la confronter à la Search Console et à l'historique des sites habituels du mot-clé sur plusieurs semaines.
Nozzle mesure 8 % de SERP « empoisonnées » depuis septembre
L’étude a été publiée le 10 octobre 2026 par Nozzle, un outil de suivi de positions (ou rank tracker, qui relève régulièrement la place d’un site dans Google pour une liste de mots-clés). Elle s’appuie sur les données collectées jusqu’au 9 octobre dans 49 pays, sur desktop, iPhone et Android. Sur les 27,5 millions de pages de résultats collectées depuis le 13 septembre, 17,8 millions ont pu être analysées. Parmi elles, 8 % étaient « empoisonnées ». Sur la période de référence, du 20 août au 9 septembre, le taux n’était que de 0,17 %.
Nozzle décrit une chronologie :
13 septembre : les requêtes envoyées à Google commencent à échouer en masse, et moins de SERP parviennent aux outils pendant deux semaines.
20 septembre : les premières SERP empoisonnées apparaissent parmi les requêtes qui aboutissent.
27 au 29 septembre : le phénomène culmine, avec un quart des SERP touchées.
Depuis le 1er octobre : le taux oscille entre 5 et 11 % par jour.
Pour qualifier une page d’empoisonnée, Nozzle définit d’abord les « sites habituels » de chaque mot-clé : ceux présents dans son top 10 sur au moins 60 % des SERP de la période de référence. Une SERP est jugée empoisonnée quand moins de la moitié de ces sites y figurent, sur l’ensemble de ses pages, et qu’ils réapparaissent ensuite. Nozzle précise que les derniers jours de ses courbes sont encore incomplets, puisqu’une SERP n’est classée empoisonnée qu’une fois les sites habituels revenus.
Zone ombrée : période de référence, du 20 août au 9 septembre. Lignes en pointillés : le 13 septembre, date à laquelle les requêtes adressées à Google ont commencé à échouer et début de la période couverte par les graphiques, et le 20 septembre, date à laquelle les premières pages de résultats (SERP) « empoisonnées » sont apparues. Points vides : jours « creux » comptant moins de 198 646 SERP analysées (soit un cinquième du volume quotidien habituel) ; dans ces cas-là, quelques SERP suffisent à faire varier significativement la courbe. Une SERP est considérée comme « empoisonnée » dès lors que les sites qui y figurent habituellement réapparaissent ; par conséquent, les données relatives aux trois derniers jours sont encore en cours de consolidation. - Source : Nozzle
Des pages normales en apparence, mais des résultats remplacés
Ce qui rend le phénomène particulièrement gênant, c’est qu’il ne laisse aucune trace visible. La page renvoyée n’affiche ni message d’erreur ni captcha (le test qui demande de prouver qu’on n’est pas un robot). Elle reprend le même gabarit et, selon Nozzle, la même version du frontend de Google qu’une page normale. Rien dans le code HTML ne la signale.
Les résultats, eux, ont changé. Nozzle illustre le phénomène avec la requête « white label local seo », collectée aux États-Unis le 4 puis le 7 octobre. La première SERP listait des prestataires SEO en marque blanche. Trois jours plus tard, les 9 sites de la page 1 avaient tous disparu, remplacés entre autres par un outil de développement WordPress, un steakhouse de Jackson Hole, un annuaire des services de santé des comtés et USA.gov. D’après Nozzle, Google a pris le mot « local » au pied de la lettre, et la pagination est passée de 10 pages à 3.
À l’échelle de l’étude, la part des sites conservés d’une SERP à l’autre s’effondre dans plusieurs zones de la page :
Résultats organiques : 20,7 % des sites conservés sur une SERP empoisonnée, contre 88,5 % sur la période de référence.
« Autres questions posées » (People also ask) : 46,9 %, contre 87,4 %.
« Recherches associées » (People also search for) : 30,7 %, contre 87,9 %.
Sources citées dans les AI Overviews : 42,3 %, contre 68,8 %.
Pack local : 60,5 %, contre 85,8 %.
Seules les zones payantes résistent. Les résultats Shopping conservent 92,2 % de leurs éléments (contre 92,8 %) et les annonces en gardent même davantage qu’à l’ordinaire, 83,7 % contre 70,6 %. La composition des pages change aussi : l’AI Overview n’apparaît plus que sur 34,9 % des SERP empoisonnées, contre 54,2 % habituellement, tandis que les blocs d’images passent de 23,0 % à 44,2 %. Sur desktop, pour les mots-clés qui comptent d’ordinaire au moins 8 pages de résultats, 50,9 % des SERP empoisonnées s’arrêtent à la page 4 ou avant, contre 0,2 % en temps normal.
Les réseaux sociaux et les forums prennent la place
Nozzle a comparé la présence de certains sites dans le top 10 des SERP empoisonnées et des autres SERP des mêmes mots-clés :
Reddit : de 20,8 % à 28,8 %, la plus forte hausse.
Facebook : de 28,3 % à 33,8 %.
LinkedIn : de 6,2 % à 9,3 %.
Instagram : de 9,6 % à 12,1 %.
Quora : de 5,3 % à 6,7 %.
YouTube, Yelp et MapQuest : en recul, respectivement de 16,3 % à 13,9 %, de 12,9 % à 11,1 % et de 4,2 % à 3,5 %.
Sur les mots-clés américains, 14,2 % des SERP empoisonnées affichent dans leur top 10 un site sous extension nationale étrangère (un .ca ou un .co.uk, par exemple), contre 6,1 % des autres.
Le site suivi disparaît du top 10
Conséquence directe pour les reportings : sur les mots-clés où le site d’un projet fait partie des sites habituels, ce site est absent du top 10 sur 58,6 % des SERP empoisonnées. Ce taux était de 2,7 % sur la période de référence et de 10,2 % sur les autres SERP des mêmes mots-clés depuis le 13 septembre. Un rank tracker enregistre donc ces relevés comme une chute de positions.
L’épisode est généralement bref. Selon Nozzle, 80 % des « épisodes » d’empoisonnement ne concernent qu’une seule SERP, 15 % en touchent deux et 5 % trois ou plus. La SERP suivante retrouve ses sites habituels dans 55,9 % des cas, et 77,9 % des SERP empoisonnées sont rentrées dans l’ordre sous trois jours (deux jours en valeur médiane).
Pays, secteurs et types de requêtes ne sont pas touchés de la même façon
La France relativement épargnée, la Belgique et la Suisse nettement plus
Parmi les grands marchés, l’Australie (11,5 %), l’Inde (10,9 %) et le Canada (10,5 %) sont les plus touchés, devant les États-Unis (8,5 %). L’Allemagne, la France et l’Espagne se situent entre 3,4 et 4,3 %, et le Royaume-Uni ferme la marche à 3,0 %.
Les voisins francophones sont bien plus exposés. Nozzle relève 13,2 % de SERP empoisonnées en Belgique et 12,8 % en Suisse, ainsi que 18,8 % en Autriche. L’Afrique du Sud (18,4 %), les Émirats arabes unis (14,4 %), la Nouvelle-Zélande (13,8 %), la Norvège (13,1 %) et l’Arabie saoudite (12,9 %) dépassent eux aussi les 12 %. Le type d’appareil, en revanche, pèse peu : 7,7 % sur desktop, 8,3 % sur iPhone et 7,1 % sur Android.
Nozzle note aussi que le taux dépend du chemin emprunté par la requête pour atteindre Google. Entre le 30 septembre et le 9 octobre, l’une de ses voies de collecte renvoyait 1 à 7 % de SERP empoisonnées, une autre 9 à 30 %.
Le juridique et les services à domicile en tête aux États-Unis
Sur les SERP américaines, le secteur juridique est le plus touché depuis le 13 septembre (15,9 %), devant les services à domicile (12,7 %), les mariages (11,6 %) et le transport (11,0 %). L’animalerie (4,3 %) et l’automobile (5,3 %) sont les moins concernées. Tous les secteurs ont atteint leur pic entre le 27 et le 29 septembre, avec un maximum de 51,3 % pour les SERP juridiques le 27 septembre.
Les requêtes « près de oi » et la longue traîne plus exposées
Selon le type de recherche, les écarts sont les suivants :
Requêtes « near me » (près de moi) : 11,4 % empoisonnées, contre 7,8 % pour le reste.
Longue traîne : 9,4 % pour les expressions recherchées moins de 100 fois par mois, contre 6,1 à 7,1 % au-delà.
Requêtes de marque : 5,3 % pour les requêtes les plus navigationnelles, le taux le plus bas.
Ciblage local : aucun effet propre. Une même expression suivie à l’échelle nationale et locale, dans le même pays et sur le même appareil, affiche 7,5 % et 7,4 % sur 21 508 paires comparées.
Google vise les scrapers IA, les outils SEO sont pris dans les filets
Nozzle présente le phénomène comme une réponse de Google au scraping (l’extraction automatisée de données) et au grounding, c’est-à-dire la collecte massive de ses résultats pour alimenter les réponses d’IA. Les rank trackers, qui collectent les SERP de la même manière, en feraient les frais. L’étude insiste sur la logique de l’approche : une requête refusée pousse le robot à réessayer, alors qu’une page empoisonnée est enregistrée comme valide.
Derek Perkins a détaillé à Barry Schwartz ce qu’il décrit comme une stratégie de Google en trois volets :
Blocage d’adresses IP à très grande échelle, visant notamment les grands réseaux de proxys résidentiels (des adresses IP de particuliers utilisées pour masquer des requêtes automatisées).
Hausse nette de l’utilisation des captchas.
Injection de données erronées dans les SERP jugées suspectes.
Barry Schwartz replace ces mesures dans une série d’initiatives antérieures. En juillet, Google a commencé à tester des redirections « goto » dans ses résultats pour mieux identifier les scrapers. Il évoque aussi le conflit entre Google et SerpApi, un fournisseur d’API de collecte de SERP, ainsi que la fin du paramètre num=100 en 2025, qui permettait d’afficher 100 résultats sur une seule page. Comme Nozzle, il estime que Google ne cible pas directement les outils SEO, mais les robots IA et SerpApi. Cette lecture reste une interprétation : aucune des sources ne cite de déclaration de Google sur le sujet.
Monitorank date le phénomène à mai
Le 13 octobre, Monitorank a réagi sur X en affirmant que le phénomène a débuté le 15 mai 2026. L’outil français décrit des résultats YouTube envahissant les pages 4 et 5, des sites disparaissant du top 10, voire un top 10 entièrement différent. Selon Monitorank, Google détecte comme robot une requête venant d’une adresse IP étrangère (via un VPN, par exemple), en navigation privée, qui demande des résultats français avec le paramètre gl=fr. L’éditeur indique avoir corrigé le problème rapidement, et signale une mise à jour similaire de Google le 25 septembre.
Ce calendrier diffère de celui de Nozzle, qui ne relève que 0,17 % de SERP empoisonnées sur sa période de référence (20 août au 9 septembre). Les deux observations ne portent pas forcément sur le même mécanisme. Monitorank affirme par ailleurs que son API de scraping, SEMScraper, n’est pas affectée, et dit avoir développé une application interne comparant cinq API concurrentes à la sienne et à un navigateur Chrome connecté servant de référence. Ces affirmations sont déclaratives et n’ont pas été vérifiées de façon indépendante.
Les éditeurs d’outils réagissent en ordre dispersé
Barry Schwartz rapporte que plusieurs outils ont publié des avertissements sur leur site, leur blog ou dans leur interface : Sistrix, DataForSEO (sur sa page de statut), Advanced Web Rankings et Morningscore. SE Ranking a indiqué le 12 octobre que des positions manquaient pour certains mots-clés sur Google, tout en assurant que l’essentiel du problème était résolu.
Le journaliste relève toutefois que beaucoup d’éditeurs n’ont pas répondu à ses sollicitations, et que certains ont confondu les redirections « goto », qu’il juge faciles à gérer pour les outils, avec les problèmes apparus en septembre. C’est l’injection de fausses données qui l’inquiète le plus : il estime que la plupart des outils ne la détecteront pas rapidement et pourront croire que tout fonctionne alors que leurs relevés sont faussés.
Comment distinguer un empoisonnement d’une vraie chute de positions
Nozzle liste plusieurs indices pour séparer un problème de données d’une baisse réelle :
Comparer le résultat à l’historique du mot-clé, et pas seulement à la veille. La SERP de la veille peut elle-même avoir été empoisonnée. La référence la plus fiable reste l’ensemble des sites habituels de page 1 sur les semaines précédentes.
Attendre quelques jours. Quatre épisodes sur cinq ne concernent qu’une SERP, et la plupart se résorbent sous trois jours. Une vraie perte de positions, elle, persiste.
Observer la structure de la page. Les SERP empoisonnées affichent en moyenne moins souvent un AI Overview et des recherches associées, davantage de blocs d’images et de réseaux sociaux, et une pagination plus courte. Nozzle prévient qu’aucun de ces signaux n’est fiable isolément.
Croiser avec la Search Console. Si un site « disparaît » alors que la Search Console continue d’enregistrer impressions et clics, il n’a rien perdu.
Rémy Blanchard en tire une règle de travail pour les agences : une chute d’un jour dans un reporting ne constitue pas un diagnostic. Avant de la signaler au client, il la compare à la Search Console et à l’historique des sites habituels du mot-clé sur plusieurs semaines. Si les impressions n’ont pas bougé, il considère qu’il ne s’est rien passé. Il conseille aussi, aux agences dont un client a paniqué fin septembre après une disparition de 24 h du top 10, de vérifier cette piste avant de lancer un audit.
La Search Console a toutefois ses limites : elle ne fournit ni données de clics ni données de requêtes pour la recherche générative, comme les AI Overviews et l’AI Mode. Sur ces surfaces, les professionnels restent dépendants d’outils tiers dont les relevés sont précisément ceux que Google cherche désormais à perturber.
Notre livre blanc fait le point sur 17 sujets GEO de l'année, avec dix enseignements tirés des études et sept questions qui divisent encore.
Il s'appuie sur 47 études et 26 prises de parole d'experts publiées entre janvier et octobre 2026, chacune relue sur sa source.
Les fondamentaux du SEO comptent plus que jamais, alors que la discipline n'a jamais évolué aussi vite.
Le GEO est-il un nouveau métier ? Ou du SEO rebaptisé ?
Réponse : la question divise
Google a indiqué sa position le 15 mai 2026 : optimiser pour la recherche IA, "c'est toujours du SEO" . La réponse nous étonne très peu mais les mesures lui donnent en partie raison : plus une page est haut placée, plus l'AI Overview la cite. Une page en position 1 est citée dans 24,9 % des cas, contre 10,2 % en position 10, selon Conductor.
Une partie des experts conteste pourtant.
Pour Mike King (iPullRank), "Dire que c'est juste du SEO est naïf", et cette formule apporte aux équipes "plus de périmètre, le même budget, aucune autorité supplémentaire". David Groult (Noiise) le résume ainsi : "GEO = le SEO x la communication". Entre les deux, Ethan Smith (Graphite) estime qu' "il y a des différences, mais leur ampleur a été exagérée".
ChatGPT lit-il vraiment les pages qu'il cite ?
Réponse : presque jamais en entier
Sur plus de 1 200 réponses de ChatGPT analysées par Resoneo, à peine plus d'une page récupérée sur 80 est réellement ouverte, et seulement en mode thinking. Le reste du temps, ChatGPT s'appuie sur un extrait de 202 caractères fourni par son index, qui contient le H1 dans 83,6 % des pages citées qui en ont un.
Quand le texte de la page est utilisé, c'est surtout son début : sur 18 012 citations de ChatGPT retrouvées dans leur page, Kevin Indig établit que 44,2 % viennent des 30 premiers pour cent du texte.
10 enseignements & 7 questions non tranchées
Abondance.com a condensé 47 études et 26 prises de parole d'experts. L'objectif : faire le point des infos sûres et des sujets qui font encore débat.
La mesure de la visibilité dans les IA est-elle fiable ?
Réponse : la question divise
Le constat de départ, lui, est partagé : les réponses changent sans cesse. Pour un même prompt, les sources citées ne se recoupent d'un jour à l'autre qu'à 34 à 42 % en moyenne, selon l'université de Saint-Gall. Et selon SparkToro, il y a moins d'une chance sur 100 d'obtenir deux fois la même liste de marques en interrogeant 100 fois ChatGPT ou l'IA de Google.
Pour Rand Fishkin (SparkToro), on peut pourtant suivre la fréquence à laquelle une marque apparaît "avec rigueur statistique", à condition de répéter les prompts assez de fois. Mais "le suivi de positions, en revanche, c'est du grand n'importe quoi".
D'autres jugent les outils pas encore prêts : "Soyons clairs : aucun outil GEO du marché n'est actuellement suffisamment fiable pour être employé seul", tranche Michael Beresin (Cosmo5). Kevin Indig, lui, résume : "Je pense que le suivi de prompts tient plus du sondage que du suivi de positions".
Les bots IA vont-ils là où vous le souhaitez ?
Réponse : pas toujours
Quand ils visitent une page à la demande d'un utilisateur, les robots de ChatGPT, Claude et Gemini n'exécutent pas le JavaScript : ce qu'une page n'affiche que par script leur échappe, selon les tests de Resoneo.
Le fichier llms.txt, proposé pour guider les IA, n'est pas lu non plus : sur les journaux de six sites analysés par Daniel Roch (SeoMix), aucun des 33 092 passages de robots des IA relevés en avril et mai ne l'a appelé.
Et certains sites bloquent les IA sans le savoir. Sur 2 096 grands sites testés par HasData, 5,5 % bloquent GPTBot, le robot d'entraînement d'OpenAI, au niveau du CDN ou du pare-feu, alors que leur robots.txt l'autorise.
Vaut-il mieux un backlink ou une mention ?
Réponse : la question divise et aucune étude ne tranche
Plusieurs experts misent sur la mention :
"Le lien garde sa valeur pour Google, mais c'est la mention, la marque contextualisée dans un site ou média tiers, qui fait basculer la mention IA en volume", estime Julien Bismuth (Getfluence).
"Au bout du compte, ce sont les mentions, idéalement dans le bon contexte", abonde Kevin Indig.
Olivier de Segonzac (Resoneo) reconnaît de son côté l'impact (indirect) du netlinking sur les citations des moteurs conversationnels.
Aucune étude publiée en 2026 ne mesure les deux sur un même corpus.
Celles qui en mesurent un seul ne tranchent pas : sur 479 pages de finance citées par ChatGPT, dix fois plus de backlinks vont de pair avec environ 10 % de citations en plus, une simple corrélation selon Greenflag Digital. Sur environ 5 millions d'URL citées par quatre moteurs, l'autorité de domaine ne prédit rien, selon Surfer.
Combien de temps reste-t-on cité ?
Réponse : peu de temps
Profound a suivi 883 000 pages pendant un an sur sept moteurs : une page citée perd en médiane la moitié de sa part de citation 11 jours après son pic.
Sur quatre moteurs chinois, des chercheurs mesurent une demi-vie d'environ 39 jours pour les mots-clés très liés à l'actualité, et de 68 jours pour les autres. Une date de mise à jour récente aide une page à être citée en premier, selon une expérience de Sprinklr.
17 sujets phares de 2026 rassemblés dans un livre blanc inédit
Notre livre blanc "GEO : ce que 2026 nous a appris" rassemble les sujets qui ont fait 2026 :
L'IA fait-elle baisser le trafic des sites ?
Une marque inconnue des modèles peut-elle être citée ?
Faut-il découper ses contenus en petits blocs ?
Peut-on faire citer n'importe quoi à une IA ?
Et 13 autres sujets chauds !
A lire ici :
10 enseignements & 7 questions non tranchées
Abondance.com a condensé 47 études et 26 prises de parole d'experts. L'objectif : faire le point des infos sûres et des sujets qui font encore débat.
Pierre Sauvé distingue la « présence » d'une marque dans les poids d'un modèle, mesurée par log-probabilités sur des modèles ouverts, de sa « citabilité », qui dépend de la recherche web effectuée au moment de répondre.
Sur son panel, l'accord entre le classement des marques connues des modèles ouverts et celui des marques citées par ChatGPT et Gemini n'est que de 0,1, sur une échelle allant de 0 à 1.
À notoriété web égale, avoir une page Wikipédia ou une forte présence sur Reddit ne produit pas d'avantage mesurable sur la présence : les paires comparées se répartissent quasiment à parts égales.
Le consultant recommande des audits GEO avec passages répétés, appels dans l'interface plutôt que par l'API, socle daté et deux indicateurs distincts, présence et citation, plutôt qu'un score unique.
Trois passages dans ChatGPT donnent trois listes de marques différentes
L’étude est née d’une remarque d'un client. Pierre Sauvé raconte avoir travaillé pour une plateforme de sondage dont l’équipe, plutôt rigoureuse, constatait que les taux de visibilité IA variaient d’un outil à l’autre. Il a donc lancé trois fois la même requête dans ChatGPT (« quelle plateforme de sondage propose des quotas et redressement ? »), dans des conditions d’utilisation classiques, le même jour et à quelques heures d’intervalle. Résultat : trois listes différentes. Une seule marque, Symbial, apparaît dans deux réponses, et aucune n’apparaît dans les trois. Le consultant parle de « roulette russe ».
Il a ensuite sollicité Qwairy, outil de suivi de la visibilité dans les LLM, qui lui a fourni gracieusement des données sur un panel plus large. Les marques y sont détectées par leur nom mais aussi par leur domaine. Les résultats confirment l’instabilité :
Sur ChatGPT : 42 % des marques ne sont vues qu’une seule fois sur trois passages, et seulement 37 % apparaissent aux trois.
Sur Gemini : 55 % des marques ne sont vues qu’une seule fois sur trois passages.
Pour Pierre Sauvé, un audit GEO fondé sur un passage unique contient donc une part d’aléa importante. Il précise que ces passages ont été réalisés sur une période courte et qu’il prévoit de les renouveler dans un mois ou deux.
Présence et citabilité relèvent de deux couches distinctes
Le consultant distingue deux raisons pour lesquelles un LLM cite une marque :
La présence : ce que le modèle a en mémoire, ancré dans ses données d’entraînement. Elle est apprise à un instant donné, bouge lentement et se mesure de façon reproductible.
La citabilité : ce que l’étape de recherche (le live retrieval) place sous les yeux du modèle au moment de répondre. Elle est volatile et actionnable à court terme.
Il illustre la différence par deux cas extrêmes. Pour savoir qui présidait la France en 2003, ChatGPT n’a pas besoin de chercher sur le web : l’information est solidement ancrée dans ses données d’entraînement. Pour connaître le résultat du dernier match de l’OM, il doit effectuer une recherche. La plupart des prompts, notamment en e-commerce, se situent entre les deux : le moteur puise une partie de l’information dans sa mémoire, puis la recherche la complète, la valide ou parfois la contredit.
Ces deux axes forment une matrice à quatre cases : présente et citée (position idéale), présente mais jamais citée (problème de récupération), absente mais citée (position portée par la recherche, donc fragile), absente et silencieuse (tout est à faire). Pierre Sauvé présente cette grille comme une proposition de complément méthodologique, et non comme une vérité établie.
Le robots.txt recoupe en partie cette distinction. Chez OpenAI, GPTBot collecte pour l’entraînement (la présence), tandis qu’OAI-SearchBot alimente l’index de recherche (la citabilité). Le consultant cite plusieurs cas observés en septembre 2026, avec des taux de citation calculés sur le jeu de prompts de chaque secteur :
Moosend : GPTBot et ChatGPT-User bloqués, OAI-SearchBot autorisé. Marque citée par ChatGPT dans moins de 3 % des réponses.
Dealabs : tous les robots bloqués par défaut, sauf sur le répertoire des codes promos. Marque citée par ChatGPT dans 36 % des réponses.
Ouest-France : stratégie sélective selon les rubriques.
Pour Pierre, bloquer GPTBot n’empêche pas une marque d’apparaître dans les données d’entraînement, puisque d’autres sites parlent d’elle. Ce choix revient surtout à laisser à des tiers la manière dont la marque y est décrite, et à dépendre de la recherche pour corriger ou valider ces informations. Dealabs illustre l’inverse : selon lui, son ancrage est si fort que le blocage ne l’empêche pas d’être bien présente et bien citée. De la même façon, les LLM connaissent Ouest-France ou Le Figaro malgré la posture restrictive des médias.
La log-probabilité sert d’instrument pour mesurer la présence
Pierre Sauvé limite volontairement son étude à la présence, qu’il juge la plus mal connue et la moins vérifiée dans les audits. Il laisse la citabilité (balisage, format des réponses, fraîcheur) aux outils SaaS spécialisés, et estime que sa conférence ne couvre qu’environ la moitié du sujet. Il précise aussi qu’il mesure si le modèle connaît une marque, pas ce qu’il en pense, un second volet étant annoncé pour une « V2 ».
Son instrument est la log-probabilité (logprob). Pour rappel, un modèle de langage attribue une probabilité à chaque mot susceptible d’en suivre un autre. Dans la phrase « Paris est la capitale de la… », « France » obtient environ 90 % et « soupe » environ 0,01 %. Le consultant exprime ces valeurs en nats, une unité logarithmique : 0 nat correspond à une probabilité de 100 %, et chaque nat en moins divise la probabilité par 2,7 environ. Une marge de +0,78 nat signifie ainsi que la bonne réponse est 2,2 fois plus probable que la meilleure des mauvaises.
Le protocole repose sur quatre briques :
Le panel : 148 marques réparties sur 11 secteurs, avec une majorité de marques anglophones, un sous-groupe français et 38 marques inventées servant de témoins. Le consultant dit avoir mélangé des secteurs très présents sur le web (CRM, plugins SEO pour WordPress) et d’autres qui communiquent moins.
La notoriété : le nombre de mentions par milliard de mots dans cinq corpus ouverts de pré-entraînement (C4, DCLM-baseline, Dolma v1.7, RedPajama et The Pile), compté via l’API infini-gram de l’Allen Institute for AI.
La présence : dix modèles ouverts issus de trois familles (Qwen, Llama, Gemma), en deux tailles de 1 à 9 milliards de paramètres, complétés par des tests sur des modèles de 70 milliards.
L’appariement : plutôt que de comparer Nike à un petit fabricant local, le consultant compare des marques de notoriété équivalente.
Les vrais corpus de Qwen, Llama, Gemma et des modèles fermés ne sont pas publiés. Pierre Sauvé s’appuie sur le fait que Common Crawl est au cœur de l’entraînement de tous ces modèles, en rappelant que la seule composition publiée par OpenAI date de GPT-3 (60 % des tokens). Il raisonne aussi par différence entre corpus de composition connue, Dolma contenant Reddit et RedPajama non. Le tout a été réalisé avec des GPU loués, pour un coût global d’environ 50 dollars.
La mesure centrale est la « marge de catégorie ». Le modèle évalue la phrase associant la marque à sa vraie catégorie, puis la compare à quatre fausses catégories (café italien, poisson, village du sud, danse folklorique). La marge est l’écart, en nats, entre la bonne catégorie et la meilleure des fausses. Elle est ensuite comparée à un « plancher » : la marge obtenue par des noms inventés, générés puis vérifiés un par un sur Google pour s’assurer qu’ils n’existaient pas. Selon le consultant, une log-probabilité brute mesure la plausibilité d’une chaîne de caractères, pas la connaissance : en démonstration, la marque inventée « Mailzephor » passait devant une vraie marque avant cette correction.
Le premier enseignement concerne le nom lui-même. Un nom inventé mais « parlant », qui contient par exemple « mail » pour l’emailing, obtient une marge positive sans aucune connaissance derrière. Selon les modèles, ce bonus atteint +0,75 à +1,05 nat sur les petits modèles et +0,99 à +1,23 nat sur ceux de 7 à 9 milliards de paramètres. La part de marques réelles qui dépassent la meilleure marque inventée varie de 30 % (Qwen, petite taille) à 71 % (Gemma, grande taille). Sur les petits modèles, sept marques sur dix ne battent donc pas un nom qui n’existe pas. Les gros modèles connaissent davantage de marques, mais accordent aussi un bonus plus élevé aux noms parlants.
Mentions, Reddit, Wikipédia : trois croyances passées au crible
« Spammons de mentions, tant pis pour les liens »
Pierre Sauvé rappelle d’abord que le balisage HTML est supprimé lors de l’extraction du texte d’entraînement. Dans les corpus, « https:// » apparaît 525,7 fois par million, « href= » 16,6 fois et « rel="nofollow" » 3,7 fois. D’un lien, il ne reste que l’ancre, c’est-à-dire une mention. Le lien garde pourtant un rôle à deux niveaux. En amont, Common Crawl découvre et revisite les pages en suivant les liens, et les filtres qualité favorisent les pages connectées. En aval, ChatGPT et Gemini s’appuient sur des index où le graphe de liens sélectionne les pages proposées au modèle.
Il vise ici les plateformes qui vendent des mentions pour le GEO. Selon lui, aucune n’a démontré d’effet sur les données d’entraînement : elles partent du principe que leurs contenus seront à la fois récupérés par la recherche et intégrés aux corpus.
Ses mesures montrent un rendement décroissant. En classant les 148 marques en quatre groupes de taille égale, la part de marques réellement reconnues passe de 11 % (Botify, Oncrawl, Bricorama…) à 30 % avec six fois plus de mentions, puis à 46 % avec 33 fois plus. Elle redescend à 35 % pour les marques omniprésentes (HubSpot, IKEA, Sephora), avec 110 fois plus de mentions.
Sur Qwen 1,5B, la marge moyenne passe de +0,28 à +0,97 nat entre le premier et le deuxième quartile de mentions, puis ne gagne que +0,24 nat jusqu’au quatrième, malgré dix-neuf fois plus de mentions. Sur Qwen 7B et Llama 8B, le deuxième quartile dépasse même les suivants. Le consultant en conclut que sortir de l’invisibilité vaut l’effort, mais que saturer une marque déjà présente rapporte beaucoup moins. Pour une marque jeune ou très peu présente, il recommande au contraire de « taper un peu fort », puisqu’elle part de zéro.
« La présence Reddit pèse lourd »
Les corpus n’indiquent pas d’où vient une occurrence. Pierre Sauvé compare donc Dolma (avec Reddit) et RedPajama (sans Reddit), construits selon la même méthode. Rank Math y est 9,1 fois plus mentionné dans Dolma, Semrush 4,9 fois, Bioderma 3,3 fois, Oncrawl seulement 1,3 fois. Au-delà d’un rapport de 3,3, il considère qu’une marque doit notablement sa présence à Reddit.
Une lecture naïve semble confirmer la croyance : les 16 marques « Reddit-friendly » affichent une marge médiane de +1,39 nat contre +1,06 pour les 132 autres, avec cinq fois moins de présence web. Mais à notoriété web égale, sur 16 paires, le résultat tombe à 8 contre 8, pour un écart médian de −0,05 nat. Deux exemples l’illustrent :
AccuRanker contre Sistrix : à notoriété comparable (16 et 18 mentions par milliard), l’outil plus présent sur Reddit l’emporte de 1,67 nat.
Bioderma contre Fenty Beauty : à 351 et 344 mentions par milliard, c’est la marque peu visible sur Reddit qui l’emporte, avec 1,12 nat d’écart.
Pierre Sauvé en conclut que Reddit signale une présence sans en déterminer la valeur. Il rapporte le cas d’un client accompagné par une agence spécialisée dans Reddit : aucune différence observée, un compte signalé par la plateforme, et des critiques formulées uniquement sur Reddit qui sont ensuite remontées dans les réponses des IA. Il ajoute que les LLM cherchent souvent à présenter les points positifs et négatifs d’une marque. Interrogé sur la rentabilité de Reddit, il répond qu’elle n’est pas supérieure à celle d’un média quelconque, et conseille plutôt de travailler sur des espaces où la marque maîtrise son discours.
« Être sur Wikipédia change tout »
Même démarche pour Wikipédia, dont le statut a été vérifié via l’API de l’encyclopédie. Les 75 marques avec une page devancent les 73 autres de 0,42 nat. Elles sont aussi 11,9 fois plus mentionnées. Pour le consultant, avoir une page Wikipédia est d’abord un symptôme de notoriété.
À notoriété égale, sur 36 paires, 17 vont dans le sens de la croyance et 19 dans le sens inverse, avec un écart médian de −0,29 nat. SendGrid (avec page) devance AWeber (sans page) de 1,79 nat à notoriété quasi identique. À l’inverse, Rank Math (sans page) devance Yoast (avec page) de 1,27 nat. Pierre Sauvé avance deux explications possibles : un nom qui contient « Rank » est plus facilement associé au SEO, et Rank Math, arrivé plus tard, a suscité de nombreux contenus comparatifs.
Il reconnaît à Wikipédia un contexte encyclopédique plus informatif et plus neutre que Reddit, sans y voir pour autant de levier décisif. Il rappelle aussi qu’une page créée par un prestataire rémunéré est souvent signalée par un bandeau ou une mention de contribution rémunérée, ce qui ne sert pas l’image de la marque. Interrogé sur Wikidata, il précise ne pas l’avoir mesuré. Son hypothèse : il s’agit d’une base de données qui fournit des relations entre entités plutôt que du texte d’entraînement.
Être connu du modèle ne prédit pas la citation
Pierre Sauvé a ensuite croisé ses mesures de présence avec les données de citation fournies par Qwairy, relevées dans l’interface et non par l’API. Environ 20 prompts génériques par secteur, en français et sans nom de marque, ont été soumis trois fois à ChatGPT et Gemini, soit 1 100 réponses selon les slides. Une marque est considérée comme « citée » si elle apparaît dans au moins 5 % des réponses de son secteur, et « présente » si sa marge dépasse le plancher des noms inventés.
Les accords entre classements (de 0 pour aucun rapport à 1 pour un ordre identique) sont parlants :
ChatGPT et Gemini, sur les marques qu’ils citent : 0,89.
Les modèles ouverts, sur les marques qu’ils connaissent : 0,85.
Présence et citation entre elles : 0,1.
Chaque couche est cohérente avec elle-même, mais les deux ne se recouvrent pas, sauf pour les marques les mieux placées, comme IKEA ou HubSpot. Trois cas l’illustrent :
Adobe Marketo : marge de +1,37 nat et 2 131 occurrences par milliard de mots, mais une seule réponse ChatGPT sur 60 dans le secteur de l’emailing. Le consultant rappelle que la marque réalisait 400 millions de dollars de chiffre d’affaires en 2021.
Brevo : marge de −0,15 nat, inférieure à celle d’une marque inventée, mais citée dans 83 % des réponses ChatGPT du secteur.
Google Optimize : service arrêté en 2023, marge de +2,1 nat, 0 % de citation, comme Universal Analytics ou Klout. Selon Pierre Sauvé, les mises à jour des données d’entraînement ne font pas baisser ses occurrences, car les modèles continuent d’absorber des articles anciens. Sa formule : « Les données d’entraînement n’oublient pas, mais la recherche, oui. »
Le cas Brevo s’explique par le rebranding de Sendinblue en mai 2023. Sur les trois petits modèles, Sendinblue obtient entre +1,56 et +1,73 nat mais n’est jamais cité, tandis que Brevo oscille entre −0,44 et +1,07 nat. La mémoire retient l’ancien nom, la recherche cite le nouveau. Pour le consultant, c’est la recherche web qui corrige le tir : elle signale au modèle que Sendinblue est devenu Brevo. Il note aussi que le changement n’a pas aidé la marque côté présence, « Send » étant plus proche de l’emailing qu’un nom neutre comme Brevo. Même schéma pour Piwik devenu Matomo, cité dans 65 % des réponses alors que Piwik domine les données d’entraînement.
Sur la matrice finale, Pierre Sauvé classe 61 marques présentes et citées (HubSpot, Ahrefs, Semrush), 65 présentes mais jamais citées (Marketo, Hiscox, FullStory), 13 absentes mais citées (Brevo, MAIF, Weldom) et 17 absentes et silencieuses (Sistrix, Matmut).
Le consultant indique avoir tenté de contredire ce résultat, secteur par secteur, puis sur les articles de type « meilleurs outils de », sans changer la conclusion. Sur Llama 3.1 70B, cinquante fois plus gros, l’accord reste nul. La langue joue en partie : sur des modèles mieux entraînés en français et interrogés en français, l’ordre change. En anglais, tous les modèles placent Home Depot devant Leroy Merlin, alors qu’une sonde française sur un modèle français rétablit l’ordre. Il dit n’avoir trouvé aucun modèle majoritairement entraîné en français : Mistral, qu’il pensait plus francophone, présentait davantage de marqueurs anglais que les modèles américains.
Il insiste enfin sur un point : la présence n’est pas inutile. Elle explique environ 10 % du classement, et les marques les plus citées figurent parmi celles qui se détachent sur la présence. Selon lui, être dans les données d’entraînement permet aussi de rattacher la marque à son contexte : si le modèle ne sait pas que Brevo fait de l’emailing, le lien doit être reconstruit à chaque recherche. Pour une petite marque, il recommande d’acquérir des mentions et de s’insérer dans des comparatifs, même si le gain reste modeste.
Un standard d’audit, un kit et une méthode discutée
Ce que Pierre Sauvé demande à un audit GEO
À sa connaissance, aucun outil commercialisé ne mesure la présence dans les données d’entraînement. Il en fait la première exigence d’un audit, avant de détailler celles qui portent sur la citation :
Des passages répétés, avec une variance visible. Un passage unique relève du bruit : un client qui teste lui-même ses prompts favoris obtiendra un résultat différent.
Des appels dans le produit plutôt que par l’API, dont la couche de recherche diffère et dont les réponses sont, selon lui, moins riches.
Un socle stable (modèle, date, prompts), en ne changeant de modèle que lorsque le modèle par défaut du grand public change.
Deux indicateurs distincts, présence et citation, parce qu’ils ne bougent pas ensemble.
Il met aussi en garde contre l’usage des log-probabilités exposées par l’API d’OpenAI. On n’y choisit pas la phrase évaluée, il n’y a ni corpus ni appariement, et le modèle comme la recherche évoluent sans cesse. Selon lui, on y mesure une conversation, pas une mémoire.
Ses recommandations suivent la matrice. Pour les marques présentes mais jamais citées : « Arrêtez de payer pour entrer dans les LLM », puisque le blocage se situe dans la récupération. Pour les marques présentes et citées, il conseille d’exiger la variance des prompts et de reprendre la main sur le discours de marque. Pour les marques absentes mais citées, comme Brevo, il recommande de ne rien relâcher et de s’imposer aussi dans les données d’entraînement. Pour les marques absentes et silencieuses, il prévient que le chantier sera long et qu’il faut annoncer délai et budget dès le départ.
Un kit pour tester sa propre marque
Le 2 octobre 2026, Pierre Sauvé a publié sur GitHub un kit sous licence MIT, baptisé brand_probe, qui applique la méthode à une marque à la fois. Il fonctionne en ligne de commande, dans un notebook Colab ou via une petite interface. Le modèle par défaut, Qwen 2.5 1.5B, se télécharge (3 Go) sans compte. Llama et Gemma nécessitent un compte Hugging Face et l’acceptation de leur licence. À l’oral, le consultant a mis en garde contre une possible hausse des coûts de Hugging Face, qu’il présentait comme récemment racheté par NVIDIA.
Le kit fournit :
La présence dans chaque modèle : marge de catégorie, plancher des noms inventés et verdict (présente si la marge dépasse le plancher de plus de 0,10 nat).
Le nom parlant : la marge d’un nom inventé qui annonce la catégorie (« Rankzuri » pour le SEO, « Assurvex » pour l’assurance). Sur Qwen 1.5B en français, Assurvex obtient +0,62 nat contre +0,42 pour Groupama.
Les termes associés : les mots que le modèle rattache à la marque, corrigés de ce qu’il dirait d’un nom inventé.
La fréquence dans les corpus C4, DCLM et Dolma, et les mots qui accompagnent la marque.
Le README avertit que le kit ne mesure pas la citation. Il résume la position de l’auteur : être dans les poids est une condition d’entrée, pas une cause de citation. Une marque absente des poids n’est jamais citée sans recherche web, mais une marque présente ne l’est pas pour autant. Le document détaille aussi plusieurs pièges :
Le collage de tokens : infini-gram apparie des séquences de tokens. « Brevo » compte 3 421 occurrences dans C4, dont 98 % correspondent à « Brevoort » (un éditeur de Marvel) ou « Brevoortia » (un poisson). En mot entier, Brevo n’en compte que 53.
Les homonymes : dans les corpus anglophones, « MAIF » désigne surtout le Maryland Automobile Insurance Fund. Une requête combinée (par exemple « Orange » avec « téléphonie », cité en démonstration) déplace l’équilibre sans tout corriger.
Les corpus datés : C4 date d’avril 2019, DCLM de 2023 et Dolma de début 2024.
La taille des modèles : une marque absente à 1,5 milliard de paramètres peut être présente à 9 milliards.
Le script fixe la révision exacte de chaque modèle et refuse la quantification, qui modifierait les log-probabilités. Deux personnes doivent ainsi obtenir la même marge à la décimale près.
Une méthode discutée sur LinkedIn
Notons qu'après la publication de Pierre Sauvé sur LinkedIn, Antony Luvera, CTO chez Maples Labs a contesté le passage entre ce qui est mesuré et ce qui est conclu. Selon lui, comparer des corpus et apparier des volumes de mentions n’isole pas explicitement l’effet de Reddit ou de Wikipédia. Une association marque-catégorie n’explique pas une recommandation. Et une marque connue mais non citée a pu être trouvée, comparée puis écartée, sans qu’il s’agisse d’un problème de récupération. Il estime que la méthode ignore les sources réellement présentes dans la fenêtre de contexte, les informations reprises dans le raisonnement du modèle et les critères de comparaison activés.
Pierre Sauvé reconnaît la justesse du troisième point : sa méthode regroupe les marques « jamais récupérées » et « récupérées puis écartées ». Il précise établir seulement que le blocage ne vient pas de la présence dans les données d’entraînement. Sur Wikipédia et Reddit, il dit conclure à une absence d’effet mesurable à notoriété égale, et non à une absence totale d’effet. Il ajoute qu’observer Reddit dans la fenêtre d’une réponse citant une marque ne prouve pas que Reddit a causé la citation : pour mesurer une contribution, il faudrait retirer la source et rejouer la requête, ce qui est impossible.
Précisons que durant sa présentation au TEKnSEO, Pierre Sauvé avait présenté sa matrice comme une proposition et reconnu à plusieurs reprises les limites de ses mesures statistiques. Antony Luvera soutient par ailleurs que l’analyse fine peut être instrumentée : les modèles exposent le contenu des sources qui entrent dans la fenêtre de contexte, ce qui permet selon lui de relier les données reprises aux choix observés, une fois pondérés par les récurrences entre conversations. Il renvoie vers le livre blanc méthodologique de Maple Labs (maplelabs.fr/technologie). La question de savoir si l’on peut attribuer une citation à une source précise reste donc ouverte entre les deux approches.
Article réalisé en partenariat avec l'Afnic, qui a compilé les données de registre utilisées dans les graphiques. Ces chiffres sont publics : chaque registre les déclare à l'ICANN, qui les publie avec environ trois mois de décalage.
Ce qu'il faut retenir :
Les quatre extensions régionales françaises (.paris, .bzh, .alsace et .corsica) réunissent plus de 38 000 noms de domaine.
Les extensions liées à une région ou à une langue ont toutes gagné des noms depuis leur première année complète. Celles des grandes villes ont démarré plus vite, puis ont légèrement reculé après leur pic de lancement.
Le .bzh et le .corsica ont plus que doublé depuis leur première année complète.
Google traite ces extensions comme n'importe quelle autre : leur intérêt se joue sur l'image et l'ancrage local.
Les extensions françaises sont gérées par des collectivités ou des associations, et opérées techniquement en France par l'Afnic.
Une adresse web aux couleurs de sa région
L'extension est la fin d'une adresse web, ce qui vient après le dernier point. Tout le monde connaît le .fr ou le .com. Depuis 2014, de nouvelles extensions portent le nom d'une ville ou d'une région : .paris, .bzh pour la Bretagne, .alsace, .corsica. À l'étranger, on trouve par exemple .berlin, .london, .nyc pour New York, .scot pour l'Écosse, .eus pour le Pays basque ou .wales pour le pays de Galles.
Pour obtenir une adresse de ce type, on passe par un bureau d'enregistrement, c'est-à-dire le prestataire auprès duquel on achète son nom de domaine, comme pour un .fr. Le prix est un peu plus élevé : le registre du .alsace indique par exemple 30 à 40 euros HT par an.
Chaque extension géographique a ses propres règles. Le .bzh est ouvert à toute personne ou organisation qui manifeste un attachement à la Bretagne, qu'il soit géographique (une adresse dans l'un des cinq départements bretons, Loire-Atlantique comprise) ou immatériel (un intérêt pour la Bretagne, sa culture ou sa langue). Aucun justificatif n'est demandé à l'achat, mais l'association qui gère l'extension effectue des contrôles a posteriori. Le .corsica est ouvert aux organisations et aux résidents corses, mais aussi à la diaspora et à toute personne qui a un lien culturel, familial ou identitaire avec l'île. Pour comparer ces adresses au .fr et au .com, vous pouvez lire notre guide pour choisir l'extension de votre nom de domaine.
Les extensions régionales françaises en chiffres
Le .paris a été ouvert au public le 2 décembre 2014, suivi deux jours plus tard par le .bzh. Le .alsace est arrivé en avril 2015 et le .corsica en janvier 2016. En juin 2026, elles comptaient ensemble 38 191 noms de domaine.
Le .paris reste l'extension la plus utilisée, avec 19 376 noms. Elle a démarré très vite : 12 000 noms réservés dans les jours qui ont suivi son ouverture, dont près de 6 000 le premier jour. Ce lancement avait été préparé, avec une centaine d'ambassadeurs pionniers, une campagne d'affichage dans Paris et une phase de réservation prioritaire avant l'ouverture générale. Après avoir doucement décru à partir de 2019, comme les autres extensions de grande ville que nous avons étudiées, le .paris connaît un nouveau dynamisme de ses enregistrements depuis 2025 : il est passé de 18 800 noms fin 2025 à 19 376 en juin 2026.
Le .bzh a suivi une autre trajectoire. Parti plus bas, il progresse chaque année depuis son ouverture, et il est passé de 5 661 noms fin 2015 à 14 018 en juin 2026. Pour les dix ans de l'extension, fin 2024, une collectivité bretonne sur cinq avait un site en .bzh, et deux sur cinq dans le Finistère. Quimper, Lorient, Saint-Brieuc, le Stade Brestois ou le Festival interceltique de Lorient ont adopté l'extension.
Le .corsica a lui aussi plus que doublé, de 1 033 noms fin 2017 à 2 454 en juin 2026, avec une hausse chaque année. Le site officiel de la Collectivité de Corse est en .corsica (isula.corsica). Le .alsace est resté plus stable, entre 2 000 et 2 600 noms depuis 2016.
Ces adresses servent d'abord les organisations. D'après les informations déclarées par les titulaires, 72 % des noms en .paris, .bzh, .alsace et .corsica appartiendraient, au 1er septembre 2026, à des entreprises, des associations ou des collectivités, et 28 % à des particuliers. La part des organisations irait de 71 % pour le .paris et le .bzh à 82 % pour le .alsace.
Dix extensions de territoire comparées en Europe et à New York
Pour comparer des extensions nées à des dates différentes, nous les avons alignées sur leur date d'ouverture : l'année 0 est celle du lancement, l'année 1 la première année complète, et ainsi de suite. Chaque graphique a sa propre échelle : on y lit la forme des courbes, et les volumes sont donnés dans le texte.
Deux familles se dessinent. Les extensions de région ou de langue (.bzh, .eus, .scot, .wales, .alsace, .corsica) montent régulièrement ou se stabilisent. Celles des grandes villes (.paris, .berlin, .london, .nyc) atteignent vite un sommet, puis reculent lentement.
Ces évolutions de volume ne constituent pas, à elles seules, une mesure de la réussite des extensions : chacune poursuit des objectifs propres, avec des publics, des conditions d'accès et des stratégies de développement différents.
Les pics de certaines villes s'expliquent en partie par des promotions de lancement. En juin 2014, pour fêter ses 50 000 noms, le .berlin a lancé une semaine d'offres, et l'un des bureaux d'enregistrement a offert les noms pendant la première année. Ce bureau est passé de 7 800 à 78 500 noms en un mois. Un an plus tard, faute de renouvellement, il en a perdu près de 69 000. Le .london a connu un mouvement comparable en 2017 : une vague d'enregistrements concentrée chez un seul bureau d'enregistrement, qui ne les a pas renouvelés l'année suivante.
Ces épisodes rappellent qu'un nom réservé sans projet derrière finit souvent par être abandonné. Une étude du CENTR, l'association des registres européens, l'a mesuré sur les extensions nationales : 90 % des noms qui portent un vrai site sont renouvelés, contre 70 % de ceux qui n'affichent aucun contenu (CENTR, 2024). Les extensions de territoire s'en sortent bien sur ce point. L'Afnic mesure que les extensions géographiques gardent en moyenne 74 % de leurs noms d'une année sur l'autre, contre 39 % pour les nouvelles extensions génériques (étude Afnic sur le marché des noms de domaine dans le monde en 2024).
Le .cat, l'extension catalane qui a inspiré le .bzh
Le .cat, dédié à la langue et à la culture catalanes, a ouvert en avril 2006, huit ans avant les autres. Le .bzh s'en est d'ailleurs inspiré dès sa candidature. Son parcours donne une idée de ce qui peut se passer sur le long terme.
Le .cat a grandi pendant dix ans, jusqu'à 111 621 noms fin 2016. Depuis, il s'est toujours maintenu au-dessus de 108 000 noms, sans jamais connaître de chute brutale, et il en compte 118 275 en juin 2026. Il semble avoir trouvé sa place auprès de la communauté catalane.
Pourquoi certaines extensions progressent plus vite
Nous n'avons trouvé aucune étude qui compare les extensions de ville à celles de région ou de langue. Ce qui suit relève donc de l'observation, sur dix extensions.
La langue semble jouer un rôle important. Le .eus et le .bzh, les deux croissances les plus régulières, sont liés à une langue autant qu'à un territoire. Selon son registre, 74 % des sites en .eus ont du contenu en basque, contre 20 % de l'ensemble des sites du Pays basque. Choisir une de ces extensions revient à afficher une appartenance, ce qui donne une raison durable de la garder.
Les acteurs locaux comptent aussi. Quand une collectivité, un club de sport ou un festival connu adopte l'extension, il la rend visible pour tous les autres. En Bretagne, des villes, des entreprises, des clubs et des associations l'utilisent au quotidien.
Les registres développent aussi des services pour accompagner les usages de leur extension. Celui du .eus propose par exemple une messagerie gratuite en basque et un programme d'aide à la numérisation des commerces de proximité, ce qui donne à l'extension une utilité concrète.
Pour les grandes villes, l'appartenance est peut-être plus diffuse. Une ville attire beaucoup d'entreprises au moment du lancement, mais l'attachement à une ville se transmet sans doute moins facilement qu'une langue ou une culture régionale. Ces extensions restent pour autant parmi les plus importantes : le .nyc compte plus de 60 000 noms et le .paris plus de 19 000.
L'animation de la communauté dans la durée pourrait aussi jouer un rôle. Au-delà du lancement, valoriser les titulaires et les accompagner entretient l'envie de choisir l'extension, puis de la conserver. Le nouveau site bienvenue.paris va dans ce sens, avec des témoignages d'entrepreneurs, des guides pratiques et une newsletter. Selon l'Afnic, le .paris est d'ailleurs reparti à la hausse depuis plusieurs mois.
Un enjeu de souveraineté numérique
Chaque extension est gérée par un registre, qui fixe les règles d'attribution et perçoit une partie du prix de chaque nom vendu.
Les quatre extensions françaises sont gérées par des acteurs publics ou associatifs. Le .paris appartient à la Ville de Paris, le .corsica à la Collectivité de Corse et le .alsace à la Région Grand Est, qui l'a obtenu en 2014. Le .bzh est porté par l'association www.bzh, à but non lucratif, qui s'est fixé pour objectif de réinvestir ses bénéfices dans les usages numériques en Bretagne. L'Afnic, l'association qui gère le .fr, en est l'opérateur technique : elle assure chaque jour leur fonctionnement, leur stabilité et leur sécurité.
Leurs règles sont donc décidées localement, par des acteurs qui rendent des comptes aux habitants ou à leurs adhérents, et la part du prix qui revient au registre reste en France, au service d'une collectivité ou d'une association.
Le .com fonctionne autrement. Son registre, Verisign, est une entreprise privée américaine cotée en Bourse : les recettes de chaque nom vendu reviennent à ses actionnaires. Le .com relève ainsi d'un enjeu capitalistique, les extensions françaises d'un enjeu de souveraineté. Pour une entreprise française, choisir une extension régionale revient à confier son adresse sur internet à des organisations françaises plutôt qu'à une société étrangère.
Une extension régionale aide-t-elle le référencement ?
Beaucoup se demandent si un .paris aide à remonter sur Google pour des recherches parisiennes. Google a répondu dès 2015 : « Même si elles semblent propres à une région, nous les traiterons comme des gTLD », c'est-à-dire comme des extensions génériques, au même titre que le .com (Google Search Central, juillet 2015). Sa documentation actuelle suit la même règle : seules les extensions nationales comme le .fr sont associées à un pays. Nous l'avions d'ailleurs relayé à l'époque.
Une extension régionale n'est donc pas un levier de classement en soi. Elle peut en revanche devenir un atout indirect. Dans une page de résultats, une adresse en .bzh ou en .paris signale tout de suite un acteur local, ce qui peut inciter les internautes de la région à cliquer davantage sur ce résultat. Un site clairement ancré dans son territoire obtient aussi plus facilement des liens de la presse, des collectivités et des associations locales. Pour le reste, votre référencement local dépendra de votre contenu, de votre fiche d'établissement Google et de vos liens, comme avec n'importe quelle autre adresse.
Leur intérêt tient à ce que voit la personne qui lit l'adresse. Une adresse en .bzh ou en .corsica dit immédiatement d'où vient l'entreprise. Elle se retient facilement, et un nom court a beaucoup plus de chances d'y être disponible que dans une extension où des millions de noms sont déjà pris.
Qui a intérêt à choisir une extension régionale ?
Une extension de territoire a tout son sens si vous êtes dans l'une de ces situations :
Votre activité est ancrée localement. Un artisan, un commerce, un restaurant ou un cabinet qui travaille avec une clientèle de proximité affiche son origine dès l'adresse.
Votre identité régionale fait partie de votre marque. Un producteur, une marque de vêtements ou une brasserie qui revendique son territoire le prolonge sur le web.
Vous lancez un projet local. Un festival, un club, une association ou une campagne municipale trouve plus facilement un nom court et parlant.
Vous êtes une collectivité. Une commune ou une intercommunalité montre son attachement au territoire et donne l'exemple aux acteurs locaux.
Les bonnes pratiques pour se lancer
Vérifiez les conditions d'accès. Chaque extension a ses règles, publiées sur le site de son registre (par exemple pik.bzh pour le .bzh ou puntu.corsica pour le .corsica).
Gardez votre .fr ou votre .com. Conserver l'ancienne adresse évite qu'un tiers la récupère et permet de rediriger vers la nouvelle.
Traitez un changement d'adresse comme une migration. Si votre site existe déjà, redirigez chaque page vers son équivalent (redirections 301), utilisez l'outil de changement d'adresse de la Search Console, mettez à jour vos liens et votre fiche Google, puis surveillez votre trafic pendant les semaines suivantes. Sur un nouveau projet, la question ne se pose pas.
Donnez vie à l'adresse. Un nom réservé sans site finit souvent par être abandonné, comme le montrent les courbes plus haut. Un site actif, même simple, justifie la dépense année après année.
Quinze extensions géographiques demandées à l'ICANN
L'ICANN, l'organisme qui coordonne les extensions d'internet, a ouvert en 2026 un nouvel appel à candidatures, le premier depuis 2012. Le 7 octobre 2026, elle a publié la liste des 1 615 candidatures reçues (ICANN, 7 octobre 2026). Quinze se déclarent géographiques. On y trouve des villes et des régions européennes, comme le .roma, le .vienna, le .budapest, le .bremen, le .salzburg ou le .campania pour la région italienne de Campanie, ainsi que le .québec, avec son accent, demandé par le registre du .quebec.
Aucune ne porte le nom d'une ville ou d'une région française. La liste n'est pas encore définitive : les candidats peuvent modifier l'extension demandée jusqu'au 21 octobre, et l'ICANN publiera la liste arrêtée le 17 novembre 2026.
En début d'année, un internaute a changé le nom et le domaine de son site web. Après avoir configuré les redirections et la fonction « Changement d'adresse » (Change of Address) dans la Google Search Console (GSC), le trafic avait rapidement récupéré autour d'avril.
Quatre mois plus tard (fin juillet), Google a brusquement réindexé l'ancien domaine, tandis que plus de 5 000 pages du nouveau domaine sont passées au statut « Explorée, actuellement non indexée » et que le nouveau domaine a perdu presque tout son trafic direct. Les internautes trouvent les contenus sur Google via l'ancien domaine, puis sont redirigés vers le nouveau, mais absolument rien de ce qui a été publié en 2026 sous le nouveau domaine n'est indexé.
Dans la discussion, John Mueller rappelle que, de manière générale, certains processus de migration et de traitement par Google peuvent prendre un temps particulièrement long. Il souligne un point important découvert et ajusté dans la documentation officielle de Google : pour qu'une migration de domaine se déroule et se finalise correctement via l'outil « Changement d'adresse » de la Search Console, il est nécessaire de bien configurer la procédure pour les deux variantes (avec www et sans www).
Le brevet US 12,717,798 B2, déposé par Microsoft le 28 février 2025 et accordé le 25 août 2026, décrit la génération d'une réponse IA de type AI Overview au sein des résultats de recherche.
Le système calcule un score de complexité pour chaque requête : une recherche simple comme « youtube » ne déclenche pas de document génératif, réservé aux questions qui demandent une synthèse de plusieurs sources.
La requête est déclinée en recherches alternatives (query fan-out), dont les résultats sont notés par un petit modèle d'IA qui ne conserve que les liens les mieux classés pour rédiger la réponse.
Pour les professionnels, la sélection se joue au niveau du lien et des sous-requêtes, et une réponse déjà générée peut être réutilisée tant que les résultats web ne changent pas au-delà d'un certain seuil.
Un brevet Microsoft accordé fin août et repéré par Ian Sorin
Le 12 octobre 2026, Ian Sorin a attiré l’attention sur LinkedIn sur un brevet publié cet été par Microsoft, qui explique selon lui le fonctionnement de « l’AI Overview » de Bing. Il estime que, dans les grandes lignes, le système diffère peu de celui décrit dans le brevet équivalent de Google, mais relève plusieurs points notables.
Le document en question porte le numéro US 12,717,798 B2. Il s’intitule « Generative search results documents based on enhanced search results using generative artificial intelligence (AI) models » et a été attribué à Microsoft Technology Licensing. Quelques repères chronologiques :
Demande provisoire : déposée le 31 décembre 2024.
Dépôt de la demande : 28 février 2025.
Publication de la demande : 2 juillet 2026 (US 2026/0187080 A1).
Délivrance du brevet : 25 août 2026, avec 20 revendications et 13 planches de dessins.
Le brevet ne parle jamais d’« AI Overview », qui est le nom du dispositif de Google. Il décrit un « generative search results document », un document généré par IA qui combine une réponse directe, des sections thématiques et des citations vers les pages sources. Les maquettes d’interface jointes montrent un bouton « Deep search » à côté du champ de recherche, sur l’exemple de la requête « How long do elephants live ».
Pour rappel, Microsoft déploie depuis plusieurs années des fonctions de recherche générative dans Bing. Comme tout brevet, ce texte décrit un système possible : il ne prouve pas que chaque mécanisme est utilisé tel quel dans le moteur.
Bing ne génère pas de réponse IA pour toutes les requêtes
Premier point relevé par Ian Sorin : Bing évalue la complexité de la requête avant de décider si une réponse générative en vaut la peine. Le brevet confirme ce filtre, présenté comme un « seuil de document génératif ».
Concrètement, le système calcule un score de complexité à partir de la requête, des premiers résultats et de l’intention de recherche détectée. Ce score mesure la difficulté à fournir une réponse satisfaisante, ce que le brevet appelle l’« answerability ». Les exemples donnés sont explicites :
Score faible : « solve 2+2 » ou « youtube », qui peuvent recevoir une réponse directe.
Score élevé : « analyze the impact of climate change on global agriculture », qui suppose de croiser plusieurs sources.
Si le score atteint le seuil, le document génératif est créé. Sinon, l’utilisateur reçoit des résultats classiques, éventuellement enrichis, ou une réponse directe. Le brevet mentionne deux façons de calculer ce score : un modèle de machine learning dédié ou un cadre heuristique, c’est-à-dire un ensemble de règles fixes.
Microsoft justifie ce filtre par l’économie de ressources : inutile de mobiliser plusieurs modèles d’IA pour une requête de navigation.
Illustration du principe général, réponse générée vs. réponse directe - Source : Microsoft Bing
Query fan-out et petits modèles : la chaîne qui produit la réponse
Le cœur du brevet repose sur des « small generative AI models », de petits modèles d’IA spécialisés chacun dans une tâche. Le texte cite l’exemple d’un modèle de 1,5 milliard de paramètres, contre 7 milliards pour un « grand » modèle. Ces petits modèles seraient obtenus par transfert d’apprentissage à partir d’un modèle plus grand, puis affinés sur une tâche précise.
L’intention de recherche identifiée en premier
Une fois la requête reçue, le système interroge l’index web pour obtenir une première série de liens. Un modèle dédié à l’intention analyse ensuite la requête et ces résultats pour dégager une ou plusieurs intentions, classées par ordre de probabilité. Selon le brevet, les premiers résultats et l’intention sont obtenus en 1,5 seconde environ.
Des sous-requêtes pour élargir le corpus
Comme l’a noté Ian Sorin, le query fan-out (c'est-à-dire la décomposition d’une requête en plusieurs recherches connexes) fait partie du processus. Un modèle spécialisé génère des requêtes alternatives à partir de la requête initiale, de l’intention et des premiers liens. Le brevet prend l’exemple de « best time to visit Hawaii », qui donne lieu à des recherches sur la période la moins chère, celle où la météo est la plus favorable ou celle des principaux événements. Ces sous-requêtes sont produites en 1,8 seconde environ.
Google a lui aussi décrit publiquement ce mécanisme pour son AI Mode en 2025, ce qui conforte le constat sur la proximité des deux approches.
Un tri par un modèle de classement
Les sous-requêtes sont envoyées à l’index, souvent en parallèle. Dans l’exemple du brevet, 5 requêtes alternatives renvoient chacune 50 liens, soit 250 résultats supplémentaires (300 avec les 50 résultats initiaux). Un modèle de classement note ensuite chaque lien selon sa correspondance avec la requête et l’intention, puis ne retient que les 5, 10 ou n meilleurs. Ce sont ces « enhanced search link results » qui servent de base à la rédaction. Cette étape prend environ 6 secondes.
Une réponse courte produite en parallèle
Pendant ce temps, un autre petit modèle rédige la « directed answer », une réponse d’une ou deux phrases à partir de la requête, de l’intention et des premiers résultats. Elle est générée en moins de 3 secondes. Dans la maquette du brevet, elle apparaît en titre : « Up to 70 years in the wild and 88 years in captivity ».
Le parallélisme est central dans la démonstration de Microsoft. Selon le brevet, enchaîner ces opérations l’une après l’autre prendrait plus d’une minute, alors que le document complet doit être livré en moins de 10 secondes. Cette limite figure d’ailleurs dans la revendication 19.
Des sections générées puis filtrées par des modèles de contrôle
À partir des liens retenus, le système détermine les thèmes à couvrir, puis un modèle rédige chaque section. Plusieurs instances de ce modèle peuvent tourner simultanément, une par section. Chaque section comprend un titre, une phrase d’accroche et un développement, avec des citations liées aux pages sources. Le modèle choisit le format le plus adapté : paragraphe, liste à puces, tableau, image ou vidéo.
Ces sections passent ensuite par des « lightweight quality check models », des modèles légers de contrôle qualité. Le brevet en cite quatre rôles :
Déduplication : suppression des contenus répétés d’une section à l’autre.
IA responsable : application des règles de sécurité et des politiques internes.
Contenus inexacts : un modèle de détection des hallucinations repère et retire les passages erronés.
Liens d’images défectueux : suppression des images cassées.
Le brevet décrit une exclusion des contenus inexacts que leur réécriture.
La revendication 12 précise aussi que la déduplication s’appuie sur les liens cités dans les sections. Autrement dit, la source attribuée à un passage sert de repère pour identifier les doublons.
Un modèle d’interface assemble texte, tableaux et cartes de réponse
Dernière étape : la mise en forme. Un modèle de correspondance associe à chaque section des « answer cards », des cartes qui donnent une réponse rapide à une question ou à une sous-question. Ces cartes peuvent contenir du texte, des images, de l’audio, de la vidéo ou des animations, et embarquent des métadonnées pour que le modèle comprenne leur contexte.
Un « generative UI layout model » détermine ensuite la disposition de l’ensemble : ordre des sections, emplacement des éléments, styles. Selon les revendications, ce modèle fonctionne sur une base heuristique, à partir des caractéristiques du contenu.
Les maquettes du brevet donnent une idée du rendu final :
Une table des matières : à gauche, avec les sections du document.
La réponse directe en titre : suivie d’un texte, d’une image et d’un tableau.
Une mention des sources : « Based on 2 sources », avec les liens correspondants.
Un panneau « Deep Search » : il affiche l’intention retenue, les thèmes connexes et les liens consultés.
Pendant la génération, un indicateur montre les étapes en cours (« Understanding query », « Searching selected items », « Ranking by understanding ») et annonce une attente d’environ 10 secondes.
Des réponses mises en cache tant que les résultats ne bougent pas trop
Le dernier point relevé par Ian Sorin concerne la réutilisation des réponses. Le brevet indique que, lorsqu’une requête identique ou proche produit le même ensemble de liens, le système peut resservir le document génératif déjà créé sans rappeler les modèles d’IA. Le document n’est mis à jour que lorsque l’ensemble des résultats diffère au-delà d’un seuil.
Pour les professionnels, ce mécanisme a une conséquence concrète : une page qui entre dans les résultats sélectionnés ne serait pas forcément prise en compte immédiatement, tant que la liste globale des liens reste proche de la précédente. À l’inverse, une réponse déjà en cache peut continuer à citer une source pendant un certain temps.
Ce passage figure toutefois dans la description du brevet et non dans ses revendications, qui définissent ce que Microsoft protège juridiquement. Le texte ne précise pas non plus la valeur du seuil de changement, ni la durée de conservation des réponses en cache. Reste donc à savoir dans quelle mesure Bing applique réellement cette logique de réutilisation, et à quel rythme ses réponses génératives sont recalculées.
Google recrute un « Principal, UX, Search Discover » de niveau directeur, basé à Mountain View ou New York, pour transformer Discover en flux proactif et hyper-personnalisé, selon une offre repérée par Damien Andell.
L'offre décrit Discover comme un assistant personnel qui aide les utilisateurs à progresser vers leurs objectifs et à passer de l'inspiration à l'action, grâce à des formats générés par l'IA déployés à grande échelle.
Le poste implique YouTube, Shopping, Chrome et Android, et le profil recherché doit savoir unifier les cadres de personnalisation de plusieurs produits et définir une stratégie pour les jeunes publics.
Google affirme vouloir centrer le flux sur les voix et sources humaines et cherche quelqu'un capable de construire un échange de valeur avec les créateurs et éditeurs, sans préciser sa forme.
Google recrute un directeur UX pour réinventer Discover
Pour rappel, Google Discover est le flux de contenus recommandés affiché dans l’application Google et sur la page d’accueil mobile de Google. Il propose des articles et des vidéos selon les centres d’intérêt de l’utilisateur, sans qu’aucune requête soit tapée.
Selon l’offre, la personne recrutée pilotera la stratégie et l’exécution UX (expérience utilisateur) pour faire de Discover un flux proactif et hyper-personnalisé. Elle dirigera les projets de design destinés à redéfinir les interactions du flux, les formats de contenus et les expériences d’exploration fondées sur l’IA. Le poste est rémunéré entre 275 000 et 382 000 dollars par an aux États-Unis, auxquels s’ajoutent un bonus cible de 30 % et des actions. Le profil exigé est expérimenté : 15 ans de management d’équipes UX dans des groupes technologiques mondiaux, et une expérience de la conception de flux grand public.
Discover pourrait devenir un assistant hyper-personnalisé
La première responsabilité listée résume l’ambition. Le futur responsable devra porter la vision qui doit faire de Discover une expérience de « concierge » proactive et hyper-personnalisée. Le terme est à prendre au sens hôtelier : un service qui anticipe les besoins et agit pour l’utilisateur, proche d’un assistant personnel. Cet assistant doit aider les utilisateurs à progresser dans leurs objectifs.
Une autre responsabilité prolonge cette idée. Discover doit servir une base d’utilisateurs très large tout en permettant aux utilisateurs existants d’aller plus loin, en passant sans rupture de l’inspiration à l’action. Jusqu’ici, Discover servait surtout à proposer des lectures. L’offre décrit désormais un outil qui accompagne l’utilisateur jusqu’à un résultat concret. Elle ne précise pas quelles « actions » sont visées.
Les formats IA vont s’étendre, avec une place revendiquée pour les « voix humaines »
Pour les formats, l’offre fixe une feuille de route claire : déployer à grande échelle les formats générés par l’IA, concevoir de nouveaux mécanismes d’engagement et donner plus de place aux voix et aux points de vue humains dans le flux. Une phrase précise l’équilibre recherché : tirer parti des capacités de l’IA tout en plaçant au centre les voix et les sources humaines.
Le recrutement lui-même reflète cette orientation IA. Parmi les qualifications souhaitées figure l’expérience de la promotion d’outils de design « nativement IA » et de prototypage rapide. L’offre cite AI Studio (la plateforme de Google pour prototyper avec ses modèles Gemini) et le « vibe coding », c’est-à-dire le fait de produire du code en décrivant ce qu’on veut à une IA plutôt qu’en l’écrivant ligne à ligne. Google y décrit Discover comme un espace de design « AI-native » complexe.
YouTube, Shopping, Chrome et Android associés à une expérience unifiée
Le poste implique une collaboration étroite avec les directions Produit, Ingénierie, Data Science et Recherche UX, mais aussi avec plusieurs autres entités de Google : YouTube, Shopping, Chrome et Android. Objectif affiché : proposer une expérience unifiée.
Les qualifications souhaitées vont dans le même sens. Google recherche quelqu’un qui a déjà mené des projets transverses à plusieurs produits et unifié des cadres de personnalisation. Les signaux d’intérêt collectés sur YouTube, Chrome ou Android pourraient doncpeser davantage dans les recommandations de Discover. La présence de Shopping, associée à l’idée de passer « de l’inspiration à l’action », suggère aussi qu’une partie de ces actions pourrait être commerciale. L’offre ne donne toutefois aucun exemple qui permette de le confirmer.
Jeunes publics et éditeurs : deux cibles citées sans précision
Deux autres qualifications souhaitées en disent long sur les priorités de Google. La première porte sur la capacité à définir une stratégie produit pour les jeunes publics et à trouver l’adéquation entre produit et marché (le « product-market fit ») dans des environnements de contenus concurrentiels. L’offre ne nomme aucun concurrent, mais les flux de recommandation qui captent l’attention des plus jeunes sont aujourd’hui ceux de TikTok ou d’Instagram.
La seconde concerne directement les éditeurs : Google cherche un profil ayant déjà construit des « échanges de valeur » avec les créateurs et les éditeurs. C’est la seule mention, dans l’offre, de la contrepartie que pourraient obtenir ceux qui alimentent le flux. Sa nature reste inconnue : trafic, visibilité de marque ou autre forme de rétribution. L’offre ne dit pas non plus si ce futur Discover sera déployé hors des États-Unis, ni à quelle échéance.
Le parasite SEO (malin pour les uns, black hat pour les autres) consiste à publier un contenu sur un site tiers qui a la confiance de Google, pour profiter de son autorité. On s'en sert pour faire ranker la page elle-même sur des requêtes que son propre site n'atteindrait jamais, ou pour obtenir un backlink depuis un domaine prestigieux. Les supports habituels sont les grands médias qui vendent des articles sponsorisés, les plateformes de publication ouvertes à tous, les forums et les pages de profil.
Comment Outlook India a vécu du parasite SEO
Le cas le plus connu reste celui d'Outlook India, un magazine d'actualité indien. En septembre 2023, un fil très partagé sur X montrait comment sa rubrique d'articles sponsorisés dominait Google sur les rencontres, les compléments alimentaires ou les casinos. Les affiliés y achetaient un article pour 150 à 175 dollars, et la rubrique comptait plus de 18 000 pages. Le fil en déduisait près de 2,7 millions de dollars de revenus pour le média. Google a depuis visé ce genre de pratique avec sa règle sur l'abus de réputation de site, appliquée depuis mai 2024 et durcie en novembre 2024.
Comment fonctionnait l'astuce des Bases de l'ANCT ?
Les Bases du numérique d'intérêt général est une plateforme de l'Agence nationale de la cohésion des territoires (ANCT), où médiateurs, associations et collectivités partagent des ressources pour accompagner le public dans ses usages du numérique. Il suffit d'une adresse e-mail pour y créer un compte et publier.
L'astuce était simple : on publiait une ressource avec un lien vers son site, et on obtenait un backlink dofollow gratuit sur un domaine en .gouv.fr. D'après l'équipe de la plateforme, la page était indexée en moins de 24 heures. Le spot circulait depuis un moment chez les SEO, et les ressources du type « les meilleurs consultants SEO en France » ou « simulateur PEA gratuit » s'y multipliaient.
Le 30 septembre, une vidéo publiée sur X (près de 10 000 vues) le présentait comme un « backlink DF puissant ». Le 4 octobre, une capture partagée dans la discussion montrait une ressource des Bases, « Les 7 meilleures banques en ligne en 2026 », en premier résultat naturel sur « meilleure banque en ligne », deux jours après sa publication. « C'est le parasite le plus puissant que je connaisse », commentait un SEO.
Tous les liens des utilisateurs passent en nofollow ugc
Le lendemain, le 5 octobre, l'équipe a intégré un correctif, documenté publiquement dans le code source de la plateforme. Tous les liens saisis par les utilisateurs portent désormais l'attribut rel="nofollow ugc", y compris dans les ressources publiées avant. Les outils de backlinks peuvent encore les afficher en dofollow tant qu'ils n'ont pas réexploré les pages.
Un spot refermé en quelques jours
La modération a suivi. Plusieurs ressources consacrées au SEO renvoient désormais une erreur 404 : un audit SEO gratuit, une présentation des trois types de SEO, un comparatif des meilleurs outils SEO de 2026. Le 6 octobre, un SEO racontait sur X que sa ressource, publiée sans lien ni promotion, avait été supprimée tout de suite.
Google, lui, n'a pas encore fait le ménage. Le 10 octobre, la ressource « Meilleur outil SEO 2026 », publiée une semaine plus tôt et passée depuis en 404, était toujours 3e sur « meilleur outil seo ». Elle arrivait juste sous notre sélection d'outils SEO, toujours en ligne pour ceux qui cherchaient un comparatif
Recherche « meilleur outil seo » sur Google, le 10 octobre 2026. La page des Bases renvoie une erreur 404 mais reste indexée en troisième position.
Un petit mot pour l'équipe des Bases, si vous passez par ici Au moment où nous écrivons ces lignes, votre fichier robots.txt affiche Disallow: /. C'est peut-être voulu, mais en attendant, Google ne peut plus explorer aucune page du site, les bonnes ressources comprises. Ce serait dommage de les priver de lecteurs
Faut-il se lancer dans le parasite SEO ?
Des spots comme celui des Bases, il en existe des centaines, et le parasite SEO fonctionne plutôt bien. Ces liens ont de la puissance, les pages se positionnent vite sur presque n'importe quel mot-clé et apportent de la visibilité à des sites ou à des marques. Pour ranker vite sur une courte durée, la méthode est simple et efficace, et il faut une bonne dose de créativité pour dénicher ces spots.
Pour un site qui veut durer, nous y voyons quatre problèmes :
Des règles enfreintes : Google range ces pratiques dans le spam de liens et l'abus de réputation de site, et la plupart des plateformes les interdisent dans leur charte.
Un résultat qui dépend des autres : la page vit sur le site d'un tiers, qui peut la supprimer ou passer ses liens en nofollow du jour au lendemain, comme ici.
Un risque pour le site qui reçoit les liens : une accumulation de liens artificiels peut valoir une action manuelle de Google.
Un risque d'image pour les marques installées : les captures d'écran circulent vite, et une marque connue n'a rien à gagner à être citée dans une discussion sur le spam d'une plateforme publique.
Nous ne recommandons donc pas cette pratique, aussi maline soit-elle. Sur Les Bases, il y avait pourtant mieux à faire : un guide pour repérer une arnaque ou vérifier la fiabilité d'un site aurait eu sa place sur la plateforme, et il y serait sans doute encore.
Google a publié le 8 octobre 2026 sur Search Central l'UGC Fresh Data Program, un pipeline dédié qui permet aux plateformes acceptées d'envoyer leurs contenus UGC et leurs signaux d'interaction à Google Search.
Ce canal est indépendant de l'Indexing API et du crawl organique, il est réservé aux contenus UGC tendance et Google précise qu'il ne garantit pas l'apparition des contenus dans les résultats.
Les plateformes doivent héberger majoritairement de l'UGC public, attribué à un créateur doté d'un profil public, avec un fort volume, une modération active et un envoi des contenus idéalement en quelques minutes.
La candidature passe par un formulaire, avec une réponse sous 6 à 8 semaines ; elle suppose de maîtriser OAuth 2.0, les payloads JSON-LD et le balisage schema.org SocialMediaPosting ou DiscussionForumPosting.
Google lance un pipeline dédié aux contenus générés par les utilisateurs
Google a mis en ligne le 8 octobre 2026, sur son site Search Central, une page consacrée à l’UGC Fresh Data Program. L’objectif affiché : aider les plateformes à afficher des contenus UGC « frais », de qualité et authentiques dans plusieurs fonctionnalités de Google Search. Pour rappel, l’UGC (user-generated content) désigne, selon la définition donnée par Google, tout contenu hébergé et diffusé par une plateforme; mais créé entièrement par des utilisateurs indépendants, et non par la plateforme elle-même.
Le principe repose sur un pipeline d’ingestion de données dédié. Les plateformes acceptées l’utilisent pour envoyer à Google leurs contenus ainsi que des signaux d’interaction. Google qualifie cette approche de « proactive » : la plateforme pousse l’information vers le moteur au lieu d’attendre le passage de son robot. Le but est que les contenus récents soient traités et mis à jour rapidement dans Search, afin que les internautes trouvent des « perspectives de première main ».
Toutefois, la documentation ne précise pas quelles fonctionnalités de Search sont concernées.
Un canal distinct de l’Indexing API et du crawl organique
Google insiste sur la nature spécifique du dispositif. Il s’agit d’un pipeline conçu exclusivement pour les contenus UGC tendance, indépendant de l’Indexing API et du crawl organique traditionnel utilisé pour le reste du Web.
Pour rappel, l’Indexing API permet déjà de notifier Google de la publication ou de la mise à jour d’une page, mais son usage officiel reste limité aux offres d’emploi (balisage JobPosting) et aux diffusions en direct (BroadcastEvent). Le nouveau programme ne s’y substitue donc pas et ne l’élargit pas : il ouvre un troisième canal, réservé à une catégorie de contenus et à des plateformes sélectionnées.
Google précise aussi que la participation ne garantit pas que les contenus apparaîtront dans Search. Autrement dit, le programme accélère la prise en compte des contenus par le moteur, sans rien promettre sur leur visibilité.
Six critères d’éligibilité, dont l’attribution à un profil public
La participation est limitée aux plateformes qui respectent des critères de qualité et de volume.
Google en liste six :
Nature du contenu : la plateforme doit héberger principalement de l’UGC, des publications sociales ou des discussions de forum. Les contenus doivent figurer sur des pages dédiées aux URL stables, et non sur des pages de profil ou des fils d’actualité.
Volume et audience : un volume élevé de contenus UGC et une base d’utilisateurs significative. Google ne donne aucun seuil chiffré.
Accessibilité : les contenus doivent être publics et accessibles à Googlebot (le robot d’exploration de Google) comme aux internautes. Les contenus derrière une connexion ou un paywall sont exclus.
Préparation technique : capacité à implémenter une authentification OAuth 2.0, à produire des payloads JSON-LD validés et à baliser les pages en données structurées schema.org.
Santé du contenu et modération : aucun contenu illégal, une modération active et un mécanisme de signalement par les utilisateurs.
Fraîcheur : les contenus doivent être envoyés le plus vite possible, idéalement dans les minutes qui suivent leur publication, avec des mises à jour régulières des compteurs d’engagement.
OAuth 2.0, JSON-LD et schema.org : une barrière technique assumée
Google reconnaît que la limitation de l’accès tient aussi aux exigences techniques de l’intégration.
Trois briques sont attendues.
La première est l’authentification OAuth 2.0, un protocole standard qui sécurise l’accès à une API sans exposer d’identifiants.
La deuxième est la construction de payloads JSON-LD « strictement validés ». Pour rappel, le JSON-LD est le format de données structurées recommandé par Google ; ici, il sert à décrire les contenus envoyés via le pipeline, et pas seulement à baliser les pages.
La troisième brique concerne les pages elles-mêmes. La plateforme doit déjà utiliser, ou être prête à déployer, un balisage schema.org valide sur ses URL. Google cite les types SocialMediaPosting (publication sur un réseau social) et DiscussionForumPosting (message de forum), accompagnés de sous-champs interactionStatistic. Ces derniers servent à décrire les compteurs d’interaction d’un contenu, par exemple le nombre de réponses ou de mentions « j’aime ».
Ces compteurs ont leur importance: Google demande que leurs mises à jour soient envoyées régulièrement dans les 72 heures suivant la création du contenu. La documentation technique détaillée ne sera transmise qu’aux plateformes acceptées.
Candidature sur formulaire et réponse sous 6 à 8 semaines
Les plateformes qui pensent remplir les critères doivent manifester leur intérêt via un formulaire de candidature. Google prévient que l’envoi d’une candidature ne garantit pas l’admission au programme.
La réponse est annoncée sous 6 à 8 semaines. En cas d’acceptation, Google fournit la documentation d’intégration technique et des instructions d’onboarding. Aucun calendrier de déploiement ni aucune liste de premiers participants n’ont été communiqués.
Sur un panel de 40 marques d'information analysé par The Media Leader, les visites totales passent de 2,14 milliards en septembre 2025 à 1,70 milliard en septembre 2026, soit un recul de 20,8 %.
Les sites perdent 22,9 % de leurs visites, alors que les applications, alimentées par une audience directe sans passer par un moteur de recherche, ne reculent que de 9,4 % à périmètre comparable.
Les écarts sont spectaculaires chez Le Parisien (-43,5 % sur le site, -19,3 % sur les applis) et ici, ex-France Bleu (-55,8 % sur le site, +21,8 % sur l'appli), même si ce dernier a aussi changé de nom de domaine.
La causalité reste discutée : base de comparaison très haute en septembre 2025, mise à jour anti-spam et fluctuations de Discover brouillent l'analyse, mais l'écart sites/applis était déjà visible en août.
Les sites d’information perdent 22,9 % de visites sur un an
Le 8 octobre 2026, François Quairel a publié sur The Media Leader une comparaison entre le classement des marques numériques de l’ACPM (Alliance pour les chiffres de la presse et des médias, l’organisme qui certifie les audiences des médias en France) de septembre 2026 et celui de septembre 2025. Le panel retenu compte 40 marques d’actualité et d’information générale, nationales et régionales. La marque sportive L’Équipe n’en fait pas partie.
Point important : ce panel et les moyennes qui en découlent ont été établis par The Media Leader, à partir des données certifiées de l’ACPM. Le chiffre de 23 % n’est donc pas un indicateur publié tel quel par l’ACPM.
Sur ce périmètre, les visites totales (sites et applications) atteignent 1,70 milliard en septembre 2026, contre 2,14 milliards un an plus tôt. Le recul global est de 20,8 %. Le détail par support fait apparaître une nette différence :
Sites : -22,9 % de visites sur un an.
Applications : -9,4 % à périmètre comparable, hors applications d’Europe 1, de L’Opinion et d’Actu.fr, qui n’étaient pas mesurées en septembre 2025.
Pour rappel, les AI Overviews ont été lancés en France le 22 juillet 2026. L’internaute obtient une réponse directement dans la page de résultats, ce qui réduit ses raisons de cliquer vers les sites des éditeurs. The Media Leader relève que c’est précisément le trafic des sites, plus dépendant de la recherche, qui décroche en septembre.
Franceinfo, Le Parisien et ici illustrent l’écart entre sites et applis
Les chiffres par marque rendent le décalage très concret. Chez Franceinfo, le site perd 32,9 % de ses visites, les applications seulement 9,9 %. Chez Le Parisien, l’écart est encore plus large : -43,5 % pour le site, -19,3 % pour les applis.
Le cas d’ici (ex-France Bleu), le réseau local de Radio France, est le plus marqué. Les visites du site sont divisées par plus de deux (-55,8 %), alors que l’application progresse de 21,8 %. La direction d’ici met toutefois en avant une autre cause : la migration du nom de domaine de francebleu.fr vers ici.fr, qui a pesé sur le référencement. Ce cas ne peut donc pas être attribué aux seuls AI Overviews.
D’autres marques suivent la même tendance. RFI, France 24 et L’Obs voient leurs applications progresser, alors que leurs sites reculent de 18 à 29 % :
RFI : -18,0 % sur le site, -8,5 % au total.
France 24 : -26,0 % sur le site, -21,1 % au total.
L’Obs : -29,4 % sur le site, -28,1 % au total.
Newsmagazines et presse régionale parmi les plus touchés
Aucun des leaders de l’information n’échappe à la baisse. Ouest-France limite le recul à 9,6 %, avec 191,9 millions de visites, et monte à la 3e place du classement général de l’ACPM. Selon The Media Leader, la marque profite de l’agrégation de services qui ne relèvent pas de l’information (annonces, shopping, TV, podcasts). Suivent Le Figaro, avec 167,2 millions de visites (-21,8 %), et Le Monde, avec 151,9 millions (-19,6 %).
Plus bas dans le classement, les baisses s’accentuent :
Franceinfo : 149 millions de visites (-29,1 %), de la 6e à la 8e place.
BFMTV : 121,3 millions (-28,2 %).
Actu.fr et 20 Minutes : juste au-dessus des 100 millions, respectivement -10,7 % et -12 %.
Le Parisien : 61,2 millions (-40,9 %).
Hors panel, L’Équipe, 3e du classement en septembre 2025, recule de 28 % à 168,7 millions de visites, dont 57 % réalisées sur ses applications.
Les newsmagazines figurent parmi les marques les plus affectées. Marianne (-51,7 %), Le Point (-51,6 %) et L’Express (-43,8 %) perdent environ la moitié de leurs visites. Sur son seul site, Le Point recule même de 57,5 %. En région, La Provence (-40,1 %), Midi Libre (-35,8 %) et L’Indépendant (-28,8 %) décrochent aussi fortement. Libération (-32,6 %) et Le HuffPost (-30,5 %) dépassent également les 30 % de baisse.
Les rares hausses tiennent surtout à des changements de périmètre
Quelques marques progressent, mais la plupart de ces hausses s’expliquent par la méthodologie. Nice-Matin gagne 46,1 % et passe de la 47e à la 33e place. Le groupe regroupe désormais sous cette marque les données de Var-Matin et Monaco-Matin, ce qui rend la comparaison non pertinente.
L’Opinion (+47,5 %) et Europe 1 (+41,4 %) affichent elles aussi de fortes hausses, dues à leurs applications, non mesurées en septembre 2025. Sur leurs seuls sites, L’Opinion recule de 24,3 % et Europe 1 reste stable (+0,1 %).
Les vraies progressions sont plus modestes :
La Nouvelle République : +8 % au total, +8,1 % sur le site.
Paris Match : +2,2 % au total, +3 % sur le site.
La Croix et Radio France : stables (+2,1 % et +1,4 %) grâce à leurs applications, alors que leurs sites reculent de 6,3 % et 14,9 %.
Les Echos : recul limité à 2,8 %.
The Media Leader souligne que ces variations reflètent aussi le poids de Google Discover (le fil de recommandation de contenus de Google sur mobile), dont les fluctuations de trafic pèsent lourdement sur les sites d’information.
Un effet de base en septembre 2025 qui n’explique pas l’écart
La comparaison doit être lue avec prudence. Septembre 2025 avait été un mois exceptionnel pour l’information en ligne : chute du gouvernement Bayrou, nomination de Sébastien Lecornu à Matignon, mobilisation du 10 septembre. Ce jour-là, d’après l’ACPM, les sites et applications d’information avaient battu leur record annuel avec plus de 104 millions de visites.
Cette base élevée explique une partie des baisses, surtout pour les chaînes d’info et les titres politiques. Elle n’explique pas, en revanche, la différence entre sites et applications, qui avaient profité du même pic d’actualité.
Les chiffres d’août 2026 permettent de vérifier ce point, puisque l’été 2025 n’avait pas connu d’événement comparable. Sur le même panel, les visites baissaient déjà de 16,5 % sur un an selon l’ACPM, dont 18,8 % pour les sites, alors que les applications comparables ne perdaient que 2,5 %. Le Point (-46,6 %), Midi Libre (-46,7 %), La Provence (-41,5 %) et ici (-38 %) décrochaient déjà. The Media Leader avait d’ailleurs signalé début septembre une baisse de 17 % de la fréquentation du top 50 des médias certifiés en août, et de 19 % pour les seuls sites d’information.
Le constat recoupe aussi des observations américaines. Aux États-Unis, l’association d’éditeurs Digital Content Next avait mesuré en 2025 un recul du trafic référent de ses membres après le déploiement de la fonctionnalité.
Source : The Media Leader Applications non mesurées par l’ACPM en septembre 2025 : l’évolution totale n’est pas comparable, se référer à l’évolution des sites. ** Evolution non comparable : Nice-Matin regroupe désormais les données des autres titres du groupe, Var-Matin et Monaco-Matin. *** : francebleu.fr a changé de nom de domain en ici.fr
Ce que ces chiffres disent aux éditeurs et aux SEO
Une limite méthodologique s’impose : le classement ACPM mesure des visites totales par support, pas l’origine du trafic. Il ne permet donc pas d’isoler la part de visites perdues sur Google Search, ni de distinguer l’effet des AI Overviews de celui de Discover. L’écart entre sites et applications reste l’indice le plus solide, puisque les applis captent une audience directe, peu exposée aux moteurs.
Autrement dit, les marques qui avaient déjà bâti une audience fidèle sur leurs applications amortissent mieux le choc. Ouest-France illustre une autre stratégie : diversifier l’offre au-delà de l’actualité pour élargir les points d’entrée.
Pour les équipes SEO des médias, ces données invitent à vérifier dans leurs propres outils analytiques la répartition des pertes entre Search, Discover et les autres canaux depuis le 22 juillet. Le cas d’ici rappelle aussi qu’une migration de domaine menée pendant une période de turbulences rend tout diagnostic beaucoup plus difficile.
Une causalité contestée, et un dossier devant l’Autorité de la concurrence
Les professionnels du secteur doivent rester prudents sur l’attribution des baisses. Selon certains experts cités par The Media Leader, les AI Overviews toucheraient d’abord les recherches « froides » (requêtes informationnelles intemporelles), moins l’actualité chaude. Une mise à jour anti-spam déployée par Google au même moment compliquerait aussi l’analyse. De son côté, Google assure qu’aucune baisse significative n’a été engendrée par la fonctionnalité.
Le sujet a déjà pris une dimension réglementaire. Le 11 août, l’Apig (Alliance de la presse d’information générale) a saisi l’Autorité de la concurrence. Elle estime que Google aurait dû négocier avec les éditeurs avant de lancer les AI Overviews, au titre des engagements pris par le moteur en 2022 dans le cadre des droits voisins. L’Autorité ne s’est pas encore prononcée publiquement sur cette saisine.
Google Search Console envoie des e-mails indiquant aux propriétaires de sites le nombre de « sélections en source préférée », avec des données arrêtées au 5 octobre 2026.
Le changement a été signalé le 6 octobre 2026 par Alexis Rylko sur X, puis détaillé le même jour par Barry Schwartz sur Search Engine Roundtable, captures d'écran à l'appui.
Selon Google, les sites choisis comme sources préférées peuvent apparaître plus souvent dans À la une, les Aperçus IA (AI Overviews) et le Mode IA (AI Mode).
L'e-mail recommande d'installer un bouton JavaScript permettant aux lecteurs d'ajouter un site en moins d'étapes, et renvoie vers un questionnaire sur le futur reporting dans la Search Console.
La Search Console donne un premier chiffre sur les sources préférées
Google Search Console, l'outil gratuit de Google qui permet de suivre la présence d'un site dans les résultats de recherche, envoie désormais des e-mails consacrés aux « sources préférées ». Ils indiquent au propriétaire d'une propriété combien d'internautes ont choisi son site comme source préférée sur Google.
Pour rappel, les sources préférées permettent aux utilisateurs de Google Search de choisir les publications qu'ils veulent voir en priorité. D'après le texte de l'e-mail, quand des lecteurs sélectionnent un site, ses contenus peuvent apparaître plus souvent dans plusieurs fonctionnalités :
À la une (Top Stories) : le carrousel d'articles d'actualité affiché dans les résultats de recherche.
Aperçus IA (AI Overviews) : les réponses générées par IA en haut de certaines pages de résultats.
Mode IA (AI Mode) : l'interface de recherche conversationnelle de Google.
Google ne précise pas dans quelle mesure la visibilité augmente. Le message emploie d'ailleurs le conditionnel : les contenus « peuvent » s'afficher plus souvent.
Plusieurs experts ont repéré les premiers envois le 6 octobre
Le 6 octobre 2026, Alexis Rylko a signalé le changement dans une publication sur X. Il y indique que la Search Console communique désormais le nombre de fois où un site a été ajouté aux sources préférées. Il cite la version française du message, qui reprend l'argument de visibilité dans À la une, les Aperçus IA et le Mode IA. Des propriétaires de sites francophones reçoivent donc bien ces e-mails en français.
La Search Console communique désormais combien de fois on a été ajouté dans sources préférées
"Lorsque les lecteurs sélectionnent votre site, vos contenus peuvent s'afficher plus souvent dans des fonctionnalités comme À la une, Aperçus IA et Mode IA." https://t.co/IYMCqHwvEg
Le même jour, Barry Schwartz a publié un article accompagné d'une capture de l'e-mail reçu pour une propriété Search Console à laquelle il a accès. Le message porte l'objet « People are choosing [domaine] as a preferred source » et contient deux informations :
Date des données : les chiffres sont arrêtés au 5 octobre 2026.
Indicateur : le nombre de « Preferred source selections » (sélections en source préférée) pour la propriété concernée.
Barry Schwartz a masqué le chiffre de son exemple. Aucune des deux sources ne donne d'ordre de grandeur sur le nombre de sélections qu'un site peut obtenir. Il n'est pas précisé non plus si l'envoi concerne tous les sites ou seulement ceux ayant atteint un certain seuil de sélections.
Google pousse son bouton JavaScript pour faciliter l'ajout
L'e-mail ne se limite pas à un chiffre. Une rubrique « Actions recommandées » invite les éditeurs à aider leur audience à les ajouter comme source préférée grâce à un bouton interactif. Deux cas sont prévus :
Installer le bouton JavaScript : ajouter deux lignes de HTML aux pages du site pour intégrer le bouton interactif.
Mettre à jour les boutons existants : les sites qui utilisent encore le bouton sous forme d'image statique sont invités à passer à la version JavaScript, qui permet aux utilisateurs d'ajouter le site en moins d'étapes.
Google cherche donc visiblement à multiplier les points d'entrée vers la fonctionnalité depuis les sites eux-mêmes. L'e-mail ne détaille pas le nombre d'étapes économisées par rapport au bouton statique.
Un questionnaire préfigure le futur reporting dans la Search Console
L'e-mail se termine par un lien vers un questionnaire de deux minutes destiné à « façonner » le reporting des sources préférées dans la Search Console. Il comporte sept questions :
Le répondant connaissait-il les sources préférées avant ce rapport ?
L'e-mail explique-t-il clairement ce que représente le nombre d'utilisateurs ?
Est-il utile de savoir combien d'utilisateurs ont choisi le site comme source préférée ?
Sous quelle forme le répondant préférerait-il recevoir ce reporting ?
À quelle fréquence souhaiterait-il recevoir ces chiffres par e-mail ?
Quelles métriques seraient les plus utiles si ce reporting était intégré à la Search Console (classement de 1 à 4) ?
D'autres métriques liées aux sources préférées seraient-elles utiles ?
Ces questions indiquent que Google n'a pas encore arrêté le format définitif. Un rapport dédié dans l'interface de la Search Console fait partie des options étudiées, sans aucune date ni engagement de la part de Google. Ce questionnaire devrait logiquement permettre à Google de construise les outils attendus par les éditeurs.
Une fonctionnalité restée jusqu'ici sans aucune mesure
Les sources préférées ne sont pas nouvelles. Google les a testées dans Search Labs puis lancées en 2025 dans À la une, d'abord aux États-Unis et en Inde, avant de les étendre à d'autres marchés. Depuis, les éditeurs pouvaient encourager leurs lecteurs à les sélectionner, mais sans aucun moyen d'en mesurer le résultat.
Cet e-mail est donc la première donnée chiffrée fournie par Google sur cette fonctionnalité. Elle reste toutefois limitée : un total de sélections à une date donnée, sans historique, sans évolution et sans lien avec le trafic. Le message mentionne aussi les Aperçus IA et le Mode IA, alors que la fonctionnalité concernait initialement À la une.
Ce que les éditeurs peuvent faire dès maintenant
Pour les médias et les sites qui publient de l'actualité, l'enjeu est concret. Les sources préférées sont l'un des rares leviers où l'audience influence directement la visibilité d'un site dans Google, y compris dans les réponses générées par IA. Les e-mails reçus permettent d'agir de plusieurs façons :
Vérifier la réception : contrôler les boîtes associées aux propriétaires des propriétés Search Console, car l'e-mail est adressé au propriétaire du domaine.
Noter le chiffre : en l'absence d'historique, conserver chaque valeur reçue est le seul moyen de suivre l'évolution dans le temps.
Déployer le bouton JavaScript : l'ajouter aux pages ou remplacer le bouton statique déjà en place, comme le recommande Google.
Répondre au questionnaire : indiquer les métriques souhaitées, par exemple l'évolution des sélections ou leur effet sur les clics.
Une question reste ouverte : le lien entre le nombre de sélections et le gain de visibilité. Ni l'e-mail ni le questionnaire n'indiquent si Google prévoit de mesurer, dans la Search Console, le trafic issu des sources préférées dans À la une ou dans les AI Overviews.
OpenAI ajoutera dans les prochaines semaines un filigrane invisible, textGrain, aux textes générés par ChatGPT et Codex dans l'Union européenne uniquement, pour tous les forfaits, afin de répondre aux exigences de l'AI Act.
Dans l'API, le filigrane reste désactivé par défaut : les clients du monde entier peuvent l'activer volontairement sur certains modèles depuis le 5 octobre 2026.
Selon les tests d'OpenAI, remplacer 25 % des mots d'un passage de 400 tokens par des synonymes fait chuter le taux de détection du filigrane à 17 %, contre environ 92 % pour un texte non modifié.
Le détecteur ne sera pas public au lancement : seuls des chercheurs et organisations experts approuvés y auront accès, ce qui empêche pour l'instant éditeurs, clients ou plateformes de vérifier eux-mêmes un texte.
OpenAI filigrane ChatGPT et Codex dans l'Union européenne
L'annonce a été publiée le 5 octobre 2026 sur le blog d'OpenAI, dans un billet intitulé « Our approach to EU text provenance rules ». OpenAI y détaille sa réponse à l'AI Act (le règlement européen sur l'intelligence artificielle), qui exige des fournisseurs d'IA générative qu'ils rendent les textes générés identifiables de manière lisible par une machine.
Le déploiement se fait en trois volets, tous lancés ou annoncés le même jour :
ChatGPT et Codex : un filigrane invisible sera ajouté « dans les prochaines semaines » aux réponses textuelles éligibles, pour les utilisateurs de tous les forfaits, mais dans l'Union européenne uniquement.
API : depuis le 5 octobre, les clients du monde entier peuvent activer le filigrane sur certains modèles. Il reste désactivé par défaut. OpenAI indique aussi travailler avec ses partenaires cloud pour proposer l'option sur les modèles OpenAI accessibles via leurs services.
Détecteur : les candidatures sont ouvertes, mais l'accès sera réservé dans un premier temps à des chercheurs et organisations experts approuvés au cas par cas.
OpenAI précise qu'il ne fait pas du filigrane un réglage par défaut au niveau mondial. L'approche régionale doit lui permettre, selon l'entreprise, de tirer des enseignements de l'usage réel avant d'aller plus loin. Le billet ne précise pas quelles réponses sont « éligibles », ni si le critère retenu est la localisation de l'utilisateur ou le pays de son compte.
textGrain modifie le choix des mots du modèle
Pour rappel, un filigrane textuel (ou watermark) ne se voit pas à la lecture. Dans le cas de textGrain, OpenAI explique ajouter un signal statistique invisible dans les choix de mots du modèle. Le détecteur recherche ensuite ce signal pour estimer si un passage contient un filigrane OpenAI.
Un rapport technique décrit le fonctionnement de textGrain. OpenAI annonce qu'il sera enrichi dans les prochaines semaines et que la technologie sera publiée en open source. Toujours selon l'entreprise, textGrain a égalé ou dépassé les autres approches testées, dont SynthID pour le texte (la technologie de filigrane développée par Google DeepMind). Il s'agit d'une évaluation menée par OpenAI elle-même, sans comparaison indépendante citée à ce stade.
Côté qualité, OpenAI affirme ne pas observer d'écart significatif entre textes filigranés et non filigranés sur les benchmarks de son dernier modèle, Astra. Quelques exemples tirés du tableau publié :
Artificial Analysis Intelligence Index : 49,57 points sans filigrane, 49,76 avec.
DeepSWE v1.1 : 72,80 % sans filigrane, 71,68 % avec.
Terminal-Bench 4.0 : 53,90 % sans filigrane, 56,06 % avec.
GPQA Diamond : 94,44 % sans filigrane, 93,94 % avec.
Les écarts vont dans les deux sens et restent faibles. Autrement dit, la contrainte posée sur le choix des mots ne dégraderait pas les performances mesurées par ces tests.
Textes courts et retouchés échappent largement à la détection
OpenAI publie aussi des chiffres sur les limites de son détecteur, mesurés pour un taux cible de faux positifs de 1 % (un texte signalé comme filigrané à tort). Les tests portent sur des réponses en anglais à des questions du jeu de données ELI5. Le volume est exprimé en tokens, l'unité de découpage du texte par les modèles, qui correspond à un mot ou à un fragment de mot.
Longueur du texte : le filigrane est détecté dans environ 80 % des passages de 200 tokens, contre environ 95 % des passages de 400 tokens, sur des contenus de type psychologie.
Type de contenu : la détection est nettement plus faible sur des contenus mathématiques, où le choix des mots est plus contraint.
Retouches : sur des passages de 400 tokens, remplacer 10 % des mots par des synonymes fait passer la détection d'environ 92 % à 66 %. Avec 25 % de mots remplacés, elle tombe à 17 %.
Le billet évoque aussi la traduction comme facteur qui peut empêcher une détection fiable, sans chiffre associé. OpenAI justifie explicitement par ces limites sa décision de réserver le détecteur à des chercheurs et organisations experts.
Un filigrane détecté ne prouve presque rien sur l'auteur
OpenAI consacre une section entière à ce qu'un filigrane ne permet pas de conclure. La liste est précise et mérite d'être lue par quiconque envisage d'utiliser ce type de signal :
Contribution humaine : le filigrane peut indiquer qu'un système OpenAI a généré ou traité une partie du texte, mais pas la part de travail humain (édition, jugement, créativité).
Propriété et responsabilité : il ne dit pas qui possède le texte, si son usage était licite, si une mention de l'IA était obligatoire, ni qui en est responsable.
Identité : il n'associe le texte à aucune personne, organisation, compte, prompt ou conversation.
Exactitude : il n'indique pas si le texte est vrai, trompeur ou sorti de son contexte.
Absence de filigrane : elle ne prouve pas qu'un humain a écrit le texte. Celui-ci peut être trop court, retouché, traduit, antérieur au filigrane, issu d'un modèle non couvert ou d'un autre fournisseur.
Ce dernier point limite fortement l'usage du filigrane comme outil de contrôle : un résultat négatif n'a quasiment aucune valeur probante.
Le texte s'ajoute aux filigranes déjà posés sur l'image et l'audio
Le texte est le dernier format concerné par la stratégie de provenance d'OpenAI. Pour les images, l'entreprise ajoute déjà des Content Credentials (des métadonnées décrivant l'origine et l'historique d'un fichier, selon le standard C2PA). Elle intègre aussi des filigranes SynthID invisibles dans les images et l'audio pris en charge.
Contrairement au texte, la vérification des images et de l'audio reste accessible publiquement, via l'outil web openai.com/verify et la Content Provenance API. OpenAI explique que ces techniques se complètent : les métadonnées retracent l'historique d'un fichier, tandis que le filigrane invisible survit lorsque ces métadonnées sont supprimées.
L'entreprise indique avoir déjà abordé les limites de la provenance textuelle en juin. Elle mentionne aussi s'appuyer sur un code de bonnes pratiques pour encadrer l'accès au détecteur.
L'impact du filigrane pour les équipes contenu et SEO
Concrètement, un rédacteur ou une agence qui produit des textes avec ChatGPT depuis l'Union européenne générera, d'ici quelques semaines, des contenus porteurs d'un signal statistique OpenAI. Ce signal ne se voit pas, n'identifie pas l'utilisateur et ne peut pas être vérifié librement à ce stade, puisque le détecteur n'est pas public.
Plusieurs nuances découlent directement des informations publiées :
Outils basés sur l'API : de nombreux outils de rédaction SEO s'appuient sur l'API d'OpenAI. Le filigrane y étant désactivé par défaut, leurs textes ne seront filigranés que si l'éditeur de l'outil active l'option.
Relecture et réécriture : d'après les tests d'OpenAI, un texte sensiblement retravaillé perd l'essentiel de son signal. Un contenu édité en profondeur a peu de chances d'être détecté.
Contenus courts : titres, balises meta, descriptions produits ou FAQ sont précisément les formats où la détection fonctionne le moins bien.
Reste la question des moteurs de recherche. Le billet d'OpenAI ne mentionne aucun accès accordé à Google, Bing ou d'autres plateformes au détecteur textGrain. Pour rappel, et en dehors des annonces d'OpenAI, Google a toujours indiqué juger les contenus sur leur qualité et sanctionner les abus de contenus produits à grande échelle, quelle que soit leur méthode de production. Récemment, la firme de Mountain View a également insisté sur le caractère critique de la relecture humaine des contenus IA. OpenAI annonce de son côté qu'il réexaminera chaque volet de son approche et élargira l'accès au détecteur quand il estimera que ses résultats peuvent être interprétés de façon responsable, sans donner de calendrier.
Mistral a ouvert le 6 octobre 2026 la préversion de Mistral Large 4 (ML4), un modèle multimodal de 1 000 milliards de paramètres, accessible dès maintenant par API sur Mistral Studio.
Selon Mistral, ML4 rivalise avec les meilleurs modèles open source mondiaux et dépasse tous les modèles ouverts développés aux États-Unis ou en Europe, notamment en code, en agents et en cybersécurité.
Le modèle a été entraîné sur 3 800 GPU NVIDIA dans les datacenters européens de Mistral, et ses données d'entraînement couvrent plus de 160 langues, dont toutes les langues officielles de l'Union européenne.
Les poids du modèle seront publiés fin octobre, ce qui permettra aux entreprises de l'héberger elles-mêmes et de l'utiliser sans dépendre d'un fournisseur américain.
Mistral lance la préversion publique de Large 4, surnommé « le Chonk »
L'annonce a été publiée le 6 octobre 2026 sur le blog officiel de Mistral AI. La start-up présente Mistral Large 4, abrégé ML4 en interne et rebaptisé « le Chonk » sur un ton volontairement décalé. Il s'agit pour l'instant d'une préversion publique : le modèle est disponible via l'API de Mistral Studio, la plateforme de l'entreprise.
ML4 compte 1 000 milliards de paramètres au total, dont 49 milliards « actifs ». Pour rappel, un modèle qui n'active qu'une partie de ses paramètres à chaque requête gagne en rapidité et en coût d'exécution, tout en conservant une grande capacité. Mistral promet de détailler l'architecture au moment de la publication des poids.
Le modèle est nativement multimodal : il traite le texte et les images, qu'il s'agisse de documents, de graphiques ou de photos. Mistral le décrit comme son modèle le plus grand et le plus performant à ce jour, et précise qu'il continue de progresser à mesure que l'entraînement se poursuit.
Des performances revendiquées face aux meilleurs modèles ouverts
Mistral affirme que ML4 se situe au niveau des modèles open source les plus performants au monde et qu'il surpasse nettement tout modèle ouvert conçu aux États-Unis ou en Europe. Sur certains usages professionnels (cybersécurité, finance, droit), l'entreprise le présente comme l'état de l'art parmi les modèles ouverts.
Quelques résultats mis en avant par Mistral :
Code : 61,7 % sur DeepSWE v1.1 et 28,3 % sur Terminal-Bench 4, deux tests de résolution de tâches de développement réelles. Mistral le place devant DeepSeek V4 Pro et Qwen3.8 Max sur son indice combiné.
Évaluation humaine en aveugle : dans un test mené avec Surge AI, ML4 arrive deuxième sur cinq modèles pour la qualité du code (3,74 sur 5), derrière Claude Opus 5 (4,22) et devant Kimi K3 et GLM-5.3.
Agents : 59,9 % sur AutomationBench, qui regroupe 657 tâches métier dans des outils comme Gmail, Google Sheets, Slack ou Salesforce.
Vision : sur la localisation d'éléments dans des images denses (test Dense 200), ML4 obtient 42 %, contre 41 % pour GPT-6 Astra d'OpenAI.
Droit et finance : selon des évaluations menées par le tiers vals.ai, ML4 dépasse GPT-6 Astra sur des tâches juridiques et financières représentatives.
Ces chiffres proviennent tous de la communication de Mistral. La plupart des tests sont réalisés en interne ou commandés par l'entreprise, et aucune évaluation indépendante complète n'a encore été publiée sur cette préversion.
La cybersécurité, argument central de l'annonce
Mistral consacre une large part de son annonce à la sécurité informatique. Selon l'entreprise, ML4 figure parmi les cinq meilleurs modèles mondiaux sur l'Artificial Analysis Cyber Index, une évaluation indépendante de la capacité des IA à trouver et corriger des failles dans du code réel. Sur l'un des tests de cet indice, qui consiste à reproduire une vulnérabilité existante puis à la corriger, ML4 atteint 82 %, le meilleur score tous modèles confondus.
Mistral explique cet écart par une différence de comportement. D'après l'entreprise, plusieurs modèles fermés, dont Claude Opus 5.5 et GPT-6 Astra, obtiennent un score proche de zéro sur ce test parce qu'ils refusent d'effectuer la tâche. L'argument avancé : prouver qu'une faille existe est souvent la première étape pour s'en protéger, et des filtres trop stricts peuvent bloquer un travail défensif légitime.
Mistral assure en parallèle que ML4 refuse davantage les demandes malveillantes que les autres modèles open source testés. Avant la publication des poids, le modèle est soumis à des tests offensifs (« red-teaming ») avec des acteurs de la cybersécurité, des partenaires sélectionnés et des autorités publiques, qui accèdent à une version moins modérée.
Un modèle entraîné et hébergé en Europe
ML4 a été entraîné de zéro sur 3 800 GPU NVIDIA Grace Blackwell, dans les datacenters européens de Mistral. La préversion publique tourne sur cette même infrastructure. Le modèle sera déployé dans plusieurs régions du monde, dont une offre européenne que Mistral opère de bout en bout, indépendamment d'autres fournisseurs de services numériques et sous droit européen.
L'entreprise insiste sur le volet multilingue : une part importante des données d'entraînement couvre plus de 160 langues, dont l'ensemble des langues officielles de l'Union européenne. Mistral indique aussi avoir travaillé avec de grandes entreprises de secteurs variés (finance, industrie, logistique, pharmacie, secteur public) pour entraîner le modèle.
Côté financement, Mistral présente ML4 comme la première étape d'une feuille de route financée par sa série D de 3 milliards d'euros, qu'elle décrit comme la plus grande levée de fonds en capital jamais réalisée par une entreprise technologique européenne. Une partie de ces fonds sert à augmenter la capacité de calcul de ses datacenters européens.
Ce que ML4 peut changer pour les équipes SEO et contenu
Pour les professionnels du référencement et du contenu, l'intérêt principal tient à la publication des poids. Un modèle « open weight » peut être téléchargé et exécuté sur ses propres serveurs ou dans un cloud privé. Autrement dit, une agence ou une équipe marketing pourra, à terme, faire tourner un modèle de ce niveau sans envoyer ses données à un prestataire tiers.
Plusieurs capacités annoncées concernent directement les métiers du contenu :
Multilinguisme : l'entraînement sur plus de 160 langues intéresse les équipes qui produisent ou localisent des contenus pour plusieurs marchés européens.
Compréhension de documents : Mistral met en avant la lecture de PDF, de graphiques et de documents complexes, utile pour exploiter des études, des rapports ou des audits.
Automatisation : les résultats sur AutomationBench (tâches dans Google Sheets, Gmail ou Slack) concernent les flux de travail répétitifs, comme le reporting ou la consolidation de données.
Production de livrables : Mistral affirme que ML4 sait créer et corriger des tableurs, des présentations et des PDF.
L'argument de souveraineté pèse aussi pour les clients soumis à des contraintes de confidentialité ou de conformité, dans la santé, la finance ou le secteur public. Mistral annonce par ailleurs que ML4 servira de base à une nouvelle génération de modèles spécialisés et optimisés.
Des poids attendus fin octobre et encore plusieurs inconnues
Mistral annonce la publication des poids d'ici la fin octobre 2026, accompagnée de détails sur l'architecture, de benchmarks supplémentaires et de sa méthode de post-entraînement. L'entreprise précise que l'entraînement par renforcement du modèle est toujours en cours et ne montre « aucun signe de saturation ». Elle s'attend donc à des améliorations rapides dans les semaines à venir, ce qui signifie que les performances de la préversion ne sont pas définitives.
Plusieurs points restent en suspens. Mistral ne précise pas sous quelle licence les poids seront publiés, ce qui conditionnera les usages commerciaux possibles. Les tarifs de l'API ne figurent pas non plus dans l'annonce. Enfin, faire tourner un modèle de 1 000 milliards de paramètres demande une infrastructure conséquente : l'auto-hébergement restera, dans un premier temps, réservé aux organisations qui disposent des moyens techniques nécessaires.
Pourquoi Google peut bouder les agrégateurs de contenus ?
Un site web de type grand agrégateur de produits fait face à une anomalie d'indexation. Googlebot a exploré le site 1,17 million de fois en quelques semaines. Seules 4 pages sont indexées sur un total de 180 000, et la page d'accueil elle-même n'est pas indexée. Les captures de la Search Console montrent un pic d'exploration très net à côté d'une indexation presque nulle.
John Mueller identifie deux problèmes majeurs :
Tout d’abord, plusieurs URL indexées redirigent directement vers la page d'accueil, ce qui indique des dysfonctionnements techniques importants à corriger.
Par ailleurs, le site génère un volume massif de pages via du contenu automatisé. Google n'est généralement pas favorable aux pratiques d'agrégation et de SEO programmatique.
Outre les problèmes techniques identifiés, ce cas nous rappelle que Google n’est pas particulièrement fan de SEO programmatique qui rime souvent avec un nombre important de pages sans grande valeur ajoutée.
Le 1er octobre 2026, Google a réécrit sa documentation sur les contenus générés par IA : leur vérification humaine avant publication devient « critique », y compris pour les balises title, les meta descriptions, les données structurées et les attributs alt.
Le guide de Google sur les contenus utiles liste désormais quatre critères de qualité (effort, originalité, talent ou savoir-faire, exactitude) et qualifie de tromperie les profils d'auteurs inventés ou illustrés par des photos générées par IA.
Google a lancé quatre spam updates en 2026, contre une seule en 2025, et l'écart entre deux mises à jour est passé de 92 à 37 jours. Lily Ray, Glenn Gabe et Marie Haynes anticipent une mise à jour majeure.
Selon Lily Ray, les sites qui publient des contenus IA à grande échelle, des pages programmatiques, des listicles autopromotionnels ou des mentions payées ont intérêt à auditer ces pratiques avant la prochaine mise à jour.
Google réécrit ses consignes sur les contenus générés par IA
Le principal signal relevé par Lily Ray tient en quelques lignes de documentation. Le 1er octobre 2026, Google a mis à jour sa page consacrée à l'utilisation de contenus produits par IA générative. On y lit désormais qu'il est « critique » de vérifier manuellement tous les contenus générés par IA, et de s'assurer de leur exactitude et de leur fiabilité avant publication.
Une relecture humaine qui s'étend aux métadonnées
Cette exigence ne concerne pas seulement le corps du texte. Elle couvre aussi les balises title, les meta descriptions, les données structurées et les textes alternatifs des images. A noter que Google emploie rarement le mot « critique » dans sa documentation. La page renvoie aussi vers deux sections des consignes destinées aux quality raters (les évaluateurs humains qui notent la qualité des résultats pour Google) : l'abus de contenu à grande échelle et les contenus produits avec peu ou pas d'effort.
Lily Ray y voit l'avertissement le plus important, parce que les contenus IA produits en masse sont, selon elle, la première cause des pénalités et des baisses algorithmiques qu'elle a observées cette année. Ces contenus contiennent souvent des hallucinations. D'après elle, ces erreurs dégradent l'expérience des internautes et peuvent aussi être reprises comme des faits par les AI Overviews et l'AI Mode de Google.
Effort, originalité, talent et exactitude
La même semaine, Google a ajouté une section à son guide « Creating helpful, reliable, people-first content ». Ce document définit le « contenu principal » d'une page et en fait l'un des facteurs les plus « critiques » pour évaluer sa qualité. Il liste quatre éléments que les évaluateurs sont formés à repérer :
Effort : le travail réellement investi dans le contenu.
Originalité : ce que la page apporte de nouveau.
Talent ou savoir-faire : la compétence visible dans la réalisation.
Exactitude : la fiabilité des informations publiées.
Le passage sur l'effort vise directement la production automatisée. Google y précise que l'usage de l'IA générative pour produire de grandes quantités de texte, sans supervision ni sélection humaine, correspond à peu ou pas d'effort. Pour les sujets YMYL (« Your Money or Your Life », c'est-à-dire santé, finance, sécurité), le texte exige un contenu très exact et conforme au consensus des experts.
Lily Ray met en garde les entreprises qui pensent que leurs contenus IA sont de meilleure qualité que ceux visés. Presque toutes celles qui l'ont consultée après une chute de trafic pensaient la même chose de leurs propres pages, écrit-elle.
Les faux auteurs officiellement qualifiés de tromperie
Le guide contient aussi un nouveau paragraphe sur les profils d'auteurs. Google y écrit que fabriquer des profils de créateurs, avec des photos générées par IA, des noms inventés ou de fausses qualifications, est une forme de tromperie. Toute tromperie rend la page peu fiable aux yeux des utilisateurs comme des systèmes automatisés de qualité, et constitue un signal de page de faible qualité.
Les consignes des quality raters traitaient déjà les faux profils d'auteurs comme une tromperie. La nouveauté, selon Lily Ray, est que Google s'adresse désormais directement aux éditeurs et relie cette pratique à ses systèmes automatisés. Cyrus Shepard a par ailleurs repéré une nouvelle section sur la manière dont le contenu a été créé, dans laquelle Google semble inviter les sites à signaler l'usage d'automatisation par IA.
Gary Illyes place les contenus à grande échelle devant le spam de liens
Les représentants de Google tiennent le même discours sur scène. Lors du Search Central Live de Barcelone, organisé la semaine de la publication de l'article, plusieurs déclarations sont allées dans ce sens, d'après le compte rendu de John Campbell cité par Lily Ray :
Gary Illyes : le contenu produit à grande échelle devient un problème plus important que le spam de liens.
Duy Nguyen : les spam updates se multiplient parce que le volume de nouveaux contenus explose, et l'équipe utilise désormais l'IA pour en détecter davantage. Duy Nguyen a aussi recommandé de lire les consignes des quality raters, en définissant la qualité avec les quatre critères de la nouvelle documentation.
Google a expliqué avoir mis à jour sa documentation sur les contenus IA pour l'aligner sur les présentations faites lors de ses événements pour développeurs. Autrement dit, le message transmis jusqu'ici à l'oral figure maintenant par écrit. Lily Ray y voit une manière pour Google de pouvoir renvoyer à sa documentation lorsqu'une mise à jour touchera des sites pris au dépourvu.
Quatre spam updates en 2026, à un rythme qui s'accélère
Pour rappel, une spam update est une mise à jour des systèmes de Google chargés de détecter les pratiques contraires à ses règles anti-spam, à la différence des core updates qui modifient l'algorithme de classement dans son ensemble. Google en a déployé quatre en 2026, contre une seule sur toute l'année 2025 :
L'intervalle se réduit à chaque fois : 92 jours entre mars et juin, 55 entre juin et août, 37 entre août et septembre. La mise à jour de septembre se distingue aussi par sa durée annoncée. Les trois précédentes devaient prendre « quelques jours » et se sont toutes terminées en trois jours au maximum. Google a donné à celle de septembre une fenêtre allant jusqu'à deux semaines, comme pour une core update.
Search Engine Roundtable a observé de fortes variations du 25 au 27 septembre. Les premiers signaux relevés par Lily Ray montraient des sites touchés pour des pages très standardisées, programmatiques et probablement générées par IA, par exemple une page pour chaque numéro de téléphone ou indicatif régional. Au 4 octobre, Google n'avait pas encore déclaré cette mise à jour terminée.
Google a aussi durci ses règles tout au long de l'année :
14 avril : Google indique qu'il peut désormais s'appuyer sur les signalements de spam pour prononcer des actions manuelles (des sanctions appliquées par une équipe humaine).
15 mai : Google précise que ses règles anti-spam s'appliquent aussi aux réponses générées par IA dans la recherche, donc aux AI Overviews et à l'AI Mode.
Enfin, Search Engine Journal a présenté en septembre un article de recherche de Google décrivant SAFE, un système conçu pour détecter le spam généré par IA. D'après ce document, il serait déjà en déploiement précoce, mais il semble pour l'instant concentré sur la vidéo.
Listicles, Reddit et mentions payées : les tactiques GEO dans le viseur
Pour Lily Ray, une bonne partie des tactiques GEO à la mode reprennent d'anciennes techniques de spam SEO. Elle cite la production de masse de contenus IA, les listicles (articles en forme de classement) dans lesquels une marque se place elle-même en tête, les faux avis, les mentions achetées et la publication automatisée sur Reddit.
Les AI Overviews citent moins les classements autopromotionnels
Lily Ray a mis à jour son étude sur les listicles autopromotionnels cités dans les AI Overviews, à partir de 100 requêtes du type « meilleur logiciel B2B ». Ses résultats de septembre 2026, comparés à ceux de juin :
Citations : les AI Overviews citent 38 % de listicles autopromotionnels en moins.
Marque éditrice écartée : la marque qui se classe première est absente de la recommandation finale dans 83 % des cas, contre 69 % en juin.
Effet inverse : dans 70 % des cas, le listicle aide surtout des concurrents à être recommandés.
Il s'agit de données issues de sa propre analyse, sur un périmètre limité à des requêtes B2B.
Reddit agit aussi de son côté. En mars, la plateforme a commencé à identifier les comptes de bots légitimes et à demander à certains comptes suspects de prouver qu'ils sont humains. En juillet, elle indiquait que ses systèmes automatisés bloquaient 25 000 publications et commentaires de spam par jour, dans le but d'empêcher les marques de placer des messages destinés à être recommandés par ChatGPT et Gemini. Reddit a aussi récemment banni quatre subreddits utilisés pour une expérience GEO qui s'appuyait sur des bots pour générer votes et commentaires.
Les mentions payées, nouvelle version des liens achetés
Lily Ray consacre un passage spécifique aux mentions de marque payantes, qu'elle décrit comme l'équivalent 2026 de l'achat de liens. Plusieurs entreprises vendent ouvertement des placements sur des sites tiers pour être recommandées par ChatGPT, Perplexity ou les AI Overviews. Parmi les offres qu'elle a relevées :
Placements dans des listicles « meilleurs X » ou « top X », vendus à l'unité et tarifés selon le Domain Rating ou le Domain Authority du site, souvent à partir de 135 à 250 dollars.
Packs de « mentions IA » ajoutées à des listicles, avis ou guides d'achat existants, par exemple cinq mentions pour 1 500 dollars.
Placements avec lien dofollow garanti, c'est-à-dire un lien qui transmet de la popularité.
Guides d'agences expliquant que, si la prospection échoue, de nombreux sites acceptent un paiement unique de 100 ou 200 dollars.
Services clés en main proposés par des plateformes de visibilité IA, qui gèrent prospection, rédaction, négociation et paiement.
Lorsque ces placements contiennent des liens qui transmettent du crédit de classement, il s'agit d'achat de liens, rappelle Lily Ray. La politique de Google sur le spam de liens interdit l'échange d'argent contre des liens. Les liens payants ne sont autorisés qu'avec un attribut rel="sponsored" ou rel="nofollow". Aux États-Unis, la FTC (Federal Trade Commission) exige en général que les partenariats rémunérés soient clairement signalés, ce que ces offres mentionnent rarement.
Google a aussi abordé le sujet directement. Son guide sur les fonctionnalités d'IA générative indique que rechercher des mentions non authentiques sur le web n'est pas aussi utile qu'on pourrait le croire, et ses règles anti-spam couvrent désormais les tentatives de manipulation des réponses générées par IA dans la recherche. Lors d'un Search Central Live organisé en mai, Gary Illyes aurait comparé l'achat de mentions à l'achat de liens.
Des précédents qui plaident pour une mise à jour majeure
L'argument central de Lily Ray repose sur un schéma qu'elle appelle le « cycle du SEO » : les référenceurs trouvent une faille, la tactique se diffuse, puis Google construit des systèmes pour la neutraliser. Elle rappelle que Google a souvent modifié sa documentation ou ses consignes d'évaluation juste avant une grande mise à jour :
Janvier 2011 : Matt Cutts évoque la montée du spam et les fermes de contenus. Panda suit en février 2011.
Mars 2012 : Matt Cutts annonce au SXSW une pénalité contre les sites « suroptimisés ». Penguin suit en avril 2012.
20 juillet 2018 : les consignes des quality raters insistent sur la réputation des sites et des auteurs. La core update dite « Medic » arrive le 1er août, 12 jours plus tard.
Septembre à novembre 2023 : Google retire la mention « written by people » de ses consignes et Danny Sullivan, alors Search Liaison, invite à « s'accrocher ». La Helpful Content Update de septembre 2023 précède la core update de mars 2024 et trois nouvelles règles anti-spam.
23 janvier 2025 : les consignes des quality raters intègrent l'abus de contenu à grande échelle et les contenus IA publiés sans relecture humaine. La core update de mars 2025 démarre le 13 mars, sept semaines plus tard.
15 mai 2026 : Google étend ses règles anti-spam aux AI Overviews et à l'AI Mode. La core update de mai démarre le 21 mai, six jours plus tard, suivie de la spam update de juin.
La core update de mars 2024 sert de référence à Lily Ray. Elle reste l'une des plus importantes de l'histoire de Google et, avec 45 jours, son déploiement le plus long jamais enregistré. Google l'avait accompagnée de trois nouvelles règles anti-spam (abus de réputation de site, abus de contenu à grande échelle, abus de domaines expirés) et affirmait avoir réduit de 45 % les contenus de faible qualité et non originaux dans ses résultats.
D'autres ex font la même lecture
D'autres spécialistes des mises à jour d'algorithme partagent ce diagnostic. Glenn Gabe a écrit, après les modifications de documentation, que Google cherche clairement à faire passer un message à ceux qui veulent encore produire à grande échelle via l'IA ou des contenus programmatiques. Le lendemain, il a dit s'attendre à une très grosse mise à jour. Il en a aussi discuté avec Barry Schwartz lors d'un webinaire caritatif.
Marie Haynes, qui étudie les algorithmes de Google depuis 2008, relie le calendrier au nouveau modèle Gemini 4 Argon : selon elle, les sauts de capacité des modèles de Google ont souvent précédé de grands changements de classement. Elle prédit une core update importante à court terme.
Cyrus Shepard a qualifié ces mises à jour de documentation de « significatives ». Il vient aussi de publier une enquête menée auprès de plus de 130 experts SEO, dans laquelle la qualité du contenu (originalité, exactitude, fraîcheur) figure parmi les trois premiers facteurs de classement, avec en tête les recherches originales et les données propriétaires. Interrogé par Marie Haynes sur la possibilité que Google prépare le terrain pour une future mise à jour, il a répondu en citant Hamlet : « telle est la question ».
Wowsers, SEO peeps. Google made a bunch of new updates to its "Creating helpful, reliable, people-first content" document, and they are *significant*
Marie Haynes spotted this section targeting websites that create fake authors
Lily Ray dit avoir passé une grande partie de 2026 à accompagner des entreprises déjà touchées, par des baisses algorithmiques ou des actions manuelles, et à analyser des centaines d'autres sites pénalisés. Elle retrouve les mêmes caractéristiques :
Volume de publication : des centaines ou des milliers de pages ajoutées en peu de temps, souvent sur des sujets éloignés de l'expertise du site.
Pages programmatiques : une page par ville, par numéro de téléphone ou par comparatif, avec seulement quelques mots qui changent. C'est une variante des doorway pages (pages satellites), un motif récurrent depuis au moins 15 ans.
Relecture humaine insuffisante : plusieurs sites affirmaient faire relire leurs brouillons IA et ont tout de même été déclassés, car le problème portait sur l'ensemble de la production plutôt que sur la qualité de chaque phrase.
Auteurs fictifs : des noms inventés et des photos générées par IA, y compris sur des sujets YMYL.
Contenus autopromotionnels pour l'IA : listicles et pages comparatives conçus pour être cités par ChatGPT et les AI Overviews. Beaucoup de sites touchés par la mise à jour non confirmée de janvier 2026 en avaient publié des centaines, voire des milliers.
Effet sur la visibilité IA : quand ces sites ont perdu leur trafic organique, leurs citations dans les AI Overviews, l'AI Mode et souvent ChatGPT ont aussi chuté.
Elle propose six mesures à prendre avant la prochaine mise à jour :
Passer en revue les contenus produits à grande échelle et se demander si chaque page apporte quelque chose d'introuvable ailleurs. L'option la plus radicale consiste à supprimer une part importante des pages peu performantes, sinon à les retravailler ou à les fusionner.
Auditer les pages auteurs : chaque auteur doit être une personne réelle, avec une vraie photo et des qualifications exactes. Un nom générique d'entreprise doit être accompagné d'une présentation de la politique éditoriale.
Envisager d'indiquer si et comment l'IA est utilisée. Ce n'est pas obligatoire, mais Google le suggère lorsque les lecteurs peuvent raisonnablement s'y attendre.
Faire vérifier par un humain tout contenu produit avec l'IA, y compris les balises title, meta descriptions, données structurées et attributs alt.
Reconsidérer les tactiques destinées à manipuler les réponses des IA, surtout à grande échelle : listicles autopromotionnels, mentions payées, publication automatisée sur Reddit.
Lire directement les sources : le guide sur les contenus utiles, la documentation sur les contenus IA, les règles anti-spam et les consignes des quality raters.
Lily Ray présente elle-même son analyse comme une opinion fondée sur l'observation, sans calendrier précis. Dans les précédents qu'elle recense, l'écart entre les premiers avertissements de Google et la mise à jour a varié de quelques jours à plusieurs mois.
Google a ajouté un paragraphe à sa page sur le contenu « people-first », datée du 1er octobre 2026, qui qualifie de tromperie les profils d'auteurs fabriqués.
Les exemples cités sont les portraits générés par IA, les noms inventés et les fausses qualifications utilisés pour faire croire qu'un contenu a été écrit par des experts humains.
Selon Google, toute tromperie rend une page non fiable pour ses systèmes de qualité automatisés et constitue un signal de page de faible qualité, sans préciser comment ces profils sont détectés.
Les éditeurs qui publient sous des signatures fictives ou embellies doivent revoir leurs pages auteurs, leurs bylines et les qualifications affichées pour chaque rédacteur.
Google ajoute un avertissement dans sa page sur le contenu utile
Google a modifié sa page de documentation « Creating helpful, reliable, people-first content », qui détaille ce que le moteur attend d'un contenu conçu avant tout pour les internautes. D'après Matt G. Southern, journaliste chez Search Engine Journal, dans un article publié le 2 octobre 2026, la version de la page datée du 1er octobre contient un nouveau paragraphe consacré aux profils d'auteurs fabriqués.
Ce paragraphe se trouve dans la section « Who (created the content) », juste après le conseil, déjà présent, d'ajouter des informations d'auteur exactes comme les bylines (la signature de l'auteur affichée sur un article). Google y écrit :
« Toutefois, évitez d'utiliser des informations d'auteur trompeuses. Fabriquer des profils de créateurs (par exemple en utilisant des portraits générés par IA, des noms inventés ou de fausses qualifications pour faire croire qu'un contenu a été rédigé par des experts humains) est une forme de tromperie. Toute forme de tromperie rend une page non fiable aux yeux des utilisateurs comme de nos systèmes de qualité automatisés, et constitue un signal de page de faible qualité. »
Search Engine Journal a comparé cette version avec une copie de la page enregistrée le 8 juin 2026. Dans cette copie, le texte passait directement du conseil sur les bylines à la section « How », sans ce paragraphe. La version du 1er octobre ajoute aussi une section qui définit le contenu principal d'une page.
Photos IA, noms inventés et fausses qualifications cités en exemple
Google donne trois exemples précis de ce qu'il considère comme un profil fabriqué :
Portraits générés par IA : une photo d'auteur créée par un outil d'image plutôt qu'un vrai visage.
Noms inventés : une signature qui ne correspond à aucune personne réelle.
Fausses qualifications : des titres, diplômes ou expertises revendiqués sans fondement.
Le texte ne vise pas l'usage de l'IA en tant que tel. Ce qui est pointé, c'est l'intention : utiliser ces éléments pour faire croire qu'un contenu a été écrit par des experts humains. Autrement dit, un site qui produit des contenus avec l'IA n'est pas concerné par ce paragraphe tant qu'il ne leur attribue pas un auteur fictif ou des compétences inventées.
Une consigne déjà présente dans les Quality Rater Guidelines
L'idée n'est pas nouvelle chez Google. Les Search Quality Rater Guidelines demandaient déjà de traiter les faux profils de créateurs, les images d'auteurs générées par IA et les fausses revendications d'expertise comme de la tromperie.
Dans la section 4.5.3 de ces guidelines, Google cite notamment parmi les exemples de tromperie :
Contenu IA avec faux auteurs : des contenus générés par IA associés à des profils inventés, construits à partir d'images générées par IA ou de biographies trompeuses.
Fausses qualifications : des profils d'auteurs qui revendiquent à tort un titre, par exemple en se faisant passer pour un professionnel de santé.
Les évaluateurs ont pour consigne d'attribuer la note la plus basse (« Lowest ») aux pages qui recourent à la tromperie. La section consacrée à la tromperie dans les guidelines est d'ailleurs plus large que le nouveau paragraphe : elle couvre aussi les fausses informations sur une entreprise, l'usurpation d'identité et le design de page trompeur.
Google évoque ses systèmes automatisés, sans dire comment ils détectent les faux profils
La nuance a son importance. La page sur le contenu « people-first » rappelle que les évaluateurs de qualité n'ont « aucun contrôle » sur le classement des pages : leurs notes servent à évaluer les algorithmes, pas à positionner des sites. Le nouveau paragraphe, lui, fait directement référence aux « systèmes de qualité automatisés » de Google.
Le passage ne précise pas comment ces systèmes identifieraient un profil fabriqué. Google ne dit pas s'il analyse les images d'auteurs, croise les noms avec d'autres sources ou s'appuie sur d'autres signaux. On sait seulement que Google range désormais cette pratique parmi les signaux de faible qualité, dans un texte destiné aux propriétaires de sites.
Le compte Search Liaison de Google avait affirmé en janvier 2024 que les signatures n'aident pas les pages à mieux se positionner. Ajouter une signature ne constitue donc pas un levier de classement, selon Google. En revanche, une signature mensongère est maintenant présentée comme un signal négatif.
Les pages auteurs et les signatures à passer en revue
Pour les éditeurs, le changement est surtout symbolique dans sa forme, mais clair sur le fond : publier sous des experts inventés est qualifié de tromperie à la fois dans les consignes des évaluateurs et dans la documentation destinée aux sites. Les pages auteurs et les signatures sont les premiers endroits à contrôler.
Les points de vigilance découlent directement des exemples de Google :
Vérifier que chaque nom de rédacteur correspond à une personne réelle.
Remplacer les photos d'auteurs générées par IA par de vraies photos, ou s'en passer.
Contrôler que les titres et qualifications affichés (médecin, avocat, expert certifié, etc.) sont exacts et justifiables.
Porter une attention particulière aux thématiques sensibles comme la santé, où les guidelines citent explicitement l'exemple d'un faux professionnel de santé.
Ce point concerne directement les sites qui ont industrialisé leur production avec des « personas » d'auteurs, une pratique répandue sur certains sites d'affiliation et réseaux de sites éditoriaux.
Selon le compte rendu de John Campbell (ROAST), Gary Illyes a indiqué qu'il faut environ 20 heures en général à Google pour découvrir une nouvelle URL, et environ 30 jours pour recrawler une URL déjà connue.
Une migration de site prend généralement de 1 à 3 mois, et de 6 mois à plus d'un an dans les cas les plus lents. La récupération après une core update prend en général de 3 à 6 mois.
Pour plusieurs processus, dont le traitement des sitemaps et l'indexation, le délai le plus long affiché est « jamais », avec la mention « qualité » entre parenthèses.
Ces fourchettes servent de points de repère, pas d'échéances. Gary Illyes rappelle aussi que les étapes sont liées : un retard au crawl se répercute sur l'indexation puis sur l'affichage dans les résultats.
Gary Illyes présente des délais rarement partagés par Google
La session a eu lieu le 2 octobre au Search Central Live Deep Dive Europe de Barcelone. L'événement était organisé par Gary Illyes et Cherry Sireetorn Prommawin. Gary Illyes y a présenté, pour chaque processus, un délai le plus rapide, un délai typique et un délai le plus lent, tous tirés d'analyses internes de Google.
Les slides ne sont pas en ligne. Search Engine Journal, dans un article de Matt G. Southern daté du 5 octobre 2026, précise qu'elles ne figuraient pas sur la page des événements Search Central au moment de la publication. Les chiffres connus proviennent de deux sources :
Le compte rendu de John Campbell (ROAST) : il était l'un des intervenants de la communauté invités à l'événement. Search Engine Journal s'appuie sur ce document pour ses tableaux.
Les deux sources concordent sur la plupart des valeurs (découverte, rafraîchissement, sitemaps, indexation de bout en bout, migration, snippets, suppression via Search Console, core update). Le post d'Estela Franco ajoute quelques étapes intermédiaires de l'indexation qui n'apparaissent pas dans les tableaux de SEJ.
Selon le compte rendu de John Campbell, Gary Illyes a souligné que ces processus sont liés entre eux. Une page doit être crawlée avant d'être indexée, donc les retards s'additionnent d'une étape à l'autre.
Du crawl à l'indexation, des délais de quelques heures à « jamais »
Découverte, rafraîchissement et sitemaps
Pour rappel, le crawl est l'exploration des pages par Googlebot. Il précède toute indexation. Voici les délais relayés :
Découverte d'une nouvelle URL : environ 20 heures en général. Dans les cas les plus lents, cela prend des semaines, ou n'arrive jamais.
Rafraîchissement d'une URL connue (nouveau crawl d'une page déjà dans les systèmes de Google) : environ 30 jours en général, des semaines ou jamais au plus lent.
Traitement d'un sitemap : environ 24 heures en général, jusqu'à 14 jours au plus lent, ou jamais, avec la mention « qualité ».
Estela Franco donne les mêmes ordres de grandeur pour ces trois étapes. Elle les présente comme des moyennes.
Indexation de bout en bout
L'indexation complète d'une page prend en général environ 1 h 30. Le compte rendu la définit comme le moment où tous les processus critiques se sont terminés avec succès. Au plus lent, elle prend des mois, ou n'aboutit jamais, là encore avec la mention « qualité ».
Le post d'Estela Franco détaille les étapes intermédiaires :
Rendu de la page (exécution du code, JavaScript compris, pour obtenir la page telle qu'un navigateur l'affiche) : de quelques secondes à quelques heures.
Traitement des métadonnées : environ 45 à 90 minutes en moyenne.
Traitement des liens : de quelques minutes à 1 à 3 semaines.
Suppression : 1 à 3 semaines en moyenne. Le post ne précise pas de quel type de suppression il s'agit.
Canonicalisation et migration de site
La canonicalisation est le choix, par Google, de l'URL de référence parmi plusieurs pages identiques ou très proches. Un changement de canonique prend en général 1 à 3 semaines. Il peut prendre des mois quand les signaux envoyés au moteur sont contradictoires (balise canonical, liens internes et sitemap qui pointent vers des URL différentes, par exemple).
Une migration de site prend en général 1 à 3 mois, et de 6 mois à plus d'un an dans les cas les plus lents. Le compte rendu précise qu'une petite migration peut être bouclée en quelques semaines.
Titres, snippets et suppressions s'affichent en quelques jours
Ce qui change dans les résultats
Dans la partie « serving » (l'affichage des résultats), les délais sont plus courts :
Modification du titre : 1 à 2 jours en général, de plusieurs semaines à plusieurs mois au plus lent.
Modification du snippet (l'extrait de texte affiché sous le titre) : 1 à 2 jours en général, de plusieurs semaines à plusieurs mois au plus lent.
Suppression demandée dans Search Console : environ 2 heures en général, environ 24 heures au plus lent.
Mise à jour de l'image d'un résultat textuel : environ 1 à 2 semaines en moyenne, selon Estela Franco uniquement.
Pour rappel, l'outil de suppression de la Search Console masque une URL de façon temporaire, sans la retirer de l'index. Le délai de 2 heures porte donc sur la disparition de l'affichage, pas sur la désindexation.
Actions manuelles et core updates
Une action manuelle est une sanction appliquée par un membre de l'équipe Google après une infraction aux règles anti-spam. Sa levée prend en général 1 à 2 semaines, et 4 à 6 semaines au plus lent. Pour les sites dormants, cela peut être bien plus long.
La ligne consacrée aux core updates (les mises à jour majeures de l'algorithme de classement) porte sur la récupération d'un site après des corrections, et non sur la durée de déploiement de la mise à jour. Le délai typique est de 3 à 6 mois. Au plus lent, il va de 6 mois à un an, avec dans le tableau la mention « next core update » (prochaine core update).
Les chiffres recoupent en partie la documentation de Google
Search Engine Journal compare ces fourchettes à la documentation officielle. Sur les migrations, Google indique que la plupart des pages d'un site petit ou moyen sont généralement déplacées en quelques semaines, et que les gros sites demandent plus de temps. Cela correspond à la remarque sur les petites migrations.
Sur la canonicalisation, le guide de dépannage de Google précise qu'une page peut rester jusqu'à deux semaines dans un cluster de doublons après la correction du contenu. Google a ajouté cette précision en juillet. Elle se situe dans la fourchette basse des 1 à 3 semaines présentées à Barcelone.
Sur les core updates, la documentation indique que certaines modifications peuvent produire des effets en quelques jours, mais que la confirmation d'une amélioration globale peut prendre plusieurs mois. Elle ajoute que l'absence d'effet après quelques mois peut signifier qu'il faut attendre la prochaine core update. Cela correspond à la mention « next core update » de la slide.
Des tableaux à utiliser avec prudence
Plusieurs informations manquent pour interpréter ces chiffres. Ni le compte rendu ni les pages de l'événement ne donnent la taille de l'échantillon, la période de mesure ou la définition de « typique ». Search Engine Journal le signale explicitement. Estela Franco parle de « moyennes », SEJ et le compte rendu de délais « typiques ». On ne sait donc pas s'il s'agit de moyennes, de médianes ou d'estimations.
Les délais les plus rapides manquent aussi. D'après SEJ, le compte rendu indique qu'ils existaient pour chaque processus, mais ses tableaux ne les reprennent pas.
Enfin, il y a un décalage. SEJ indique que cinq des délais les plus lents comprennent « jamais », dont trois avec la mention « qualité » : les sitemaps, l'indexation de bout en bout et les mises à jour des données structurées. Or cette dernière ligne n'apparaît pas dans les tableaux publiés. Le détail complet ne sera vérifiable qu'avec les slides originales.
Des repères pour piloter les chantiers techniques
En pratique, ces fourchettes aident à répondre à une question fréquente des clients : une correction est-elle encore en cours de prise en compte, ou bloquée dans les systèmes de Google ? Search Engine Journal donne un exemple : une migration toujours pas stabilisée au bout de trois mois se situe en haut de la fourchette typique, sans être anormale pour autant puisque les cas lents vont jusqu'à plus d'un an.
Les délais s'additionnent aussi. Une nouvelle page découverte en 20 heures puis indexée en 1 h 30 peut apparaître en un jour. Une page déjà connue et modifiée peut attendre son prochain crawl, environ 30 jours en général, avant que Google ne voie le changement. C'est ce que rappelait Gary Illyes : un retard au crawl se répercute sur toutes les étapes suivantes.
Reste la mention « jamais (qualité) » pour les sitemaps et l'indexation. Elle laisse entendre qu'à partir d'un certain niveau de qualité perçue, aucun délai ne suffit. Les comptes rendus ne disent pas comment Google mesure ce critère ni à partir de quel seuil il bloque le traitement.
Google Gemini ajoute désormais des paramètres UTM à ses liens sortants, un changement repéré sur Reddit fin septembre 2026 et constaté par John Mueller, sans documentation officielle de Google à ce stade.
Selon un utilisateur de Reddit, le référent de Gemini ne serait transmis que dans environ 9 % des cas depuis l'application mobile, ce qui envoyait une grande partie de ce trafic dans le canal « direct » de GA4.
Contrairement au référent, un paramètre UTM résiste aux navigateurs intégrés des applications et apparaît dans les logs serveur, ce qui fiabilise l'attribution du trafic venu de Gemini.
Les SEO peuvent désormais isoler le trafic Gemini, le comparer à celui de ChatGPT ou de la recherche classique, et justifier chiffres à l'appui les ressources consacrées au GEO.
Un utilisateur de Reddit repère des UTM dans les liens de Gemini
L'information est partie de Reddit. Un utilisateur y a signalé que Gemini ajoutait des paramètres UTM aux liens présents dans ses réponses, un changement qu'il datait d'environ 24 heures et qu'il rapprochait de la pratique déjà en place chez ChatGPT. Le fil a été relayé par Roger Montti dans un article publié le 1er octobre 2026 sur Search Engine Journal.
Pour rappel, les paramètres UTM (Urchin Tracking Module) sont des balises ajoutées à la fin d'une URL, comme utm_source ou utm_medium. Ils indiquent explicitement aux outils d'analytics d'où provient une visite, indépendamment des informations transmises par le navigateur.
Google n'a publié aucune annonce ni documentation sur ce changement.
John Mueller constate le changement et s'interroge sur le référent
John Mueller, Search Advocate chez Google, a réagi dans le fil. Il a indiqué observer lui aussi les UTM, tout en se demandant pourquoi ils étaient nécessaires. Selon lui, Gemini transmettait déjà un référent (l'information « referrer » qui indique au site de destination la page d'origine du clic), ce qui devait permettre de suivre ce trafic.
Il faut noter que cette réaction relève du constat, pas d'une confirmation officielle de Google sur le fonctionnement du dispositif. John Mueller n'a donné aucune précision sur les conditions de déclenchement des UTM.
Le référent de Gemini se perd sur mobile, selon un utilisateur
La réponse la plus détaillée est venue d'un utilisateur identifié sous le pseudonyme CrawlWarden. D'après lui, le référent existe bien, mais il ne survit pour l'essentiel que sur la version web desktop de Gemini. Ses observations sont les suivantes :
Application mobile Gemini : le référent ne serait transmis que dans environ 9 % des cas.
Invocations de l'assistant sur Android : le référent serait totalement supprimé.
Conséquence dans GA4 : une part importante de ce trafic se retrouverait classée en « direct » plutôt que dans le canal dédié aux assistants IA.
Important : ces chiffres sont déclaratifs. Ils proviennent d'un utilisateur anonyme, sans méthodologie publiée ni données reproductibles.
CrawlWarden souligne aussi l'avantage technique de l'UTM : il survit aux webviews intégrées aux applications (les navigateurs embarqués qui ouvrent un lien sans passer par Chrome ou Safari) et apparaît dans les logs serveur bruts. C'est ce qui donne au changement plus de portée qu'il n'y paraît, même si un référent existait déjà.
John Mueller a répondu qu'il transmettrait volontiers à l'équipe concernée toute information reproductible sur la perte du référent. Il a ajouté qu'il serait souhaitable de conserver ce référent en plus du marquage UTM.
Le canal « direct » masquait une partie du trafic IA
Le problème soulevé dépasse Gemini. Dans GA4 comme dans la plupart des outils d'analytics, le canal « direct » sert de catégorie par défaut : une visite y est rangée lorsqu'aucun référent ni aucun paramètre UTM ne permet de la rattacher à une source.
Autrement dit, tant que le référent disparaissait, le trafic envoyé par Gemini depuis mobile se mélangeait aux saisies d'URL, aux favoris et à d'autres visites non attribuées. Impossible, dans ces conditions, de savoir précisément ce que l'assistant de Google apportait à un site.
Le contexte rend ce manque de visibilité d'autant plus sensible. Comme le rappelle Roger Montti, l'ajout intervient alors que la frustration monte face à la baisse du trafic envoyé par Google Search, attribuée au déploiement de la recherche IA et de Gemini. Un constat pas forcément partagé par Google, comme l'a récemment rappelé Nick Fox dans une interview.
Les conditions de déclenchement encore inconnues
Une question reste ouverte : dans quels cas Gemini ajoute-t-il ces UTM ? ChatGPT, de son côté, n'en ajoute qu'aux liens issus de réponses s'appuyant sur des sources web, et non à ceux qui découlent de ses données d'entraînement (les connaissances dites paramétriques du modèle).
Pour Gemini, rien n'est documenté. Roger Montti suppose que les UTM pourraient apparaître lorsque l'assistant présente une réponse qui renvoie directement à un site, sans pouvoir l'affirmer. Tant que Google ne précise pas ce comportement, une partie du trafic Gemini pourrait donc continuer à échapper à l'attribution, et la part captée par les UTM reste à mesurer site par site.
Le 1er octobre 2026, Google a modifié sa page d'aide sur les contenus générés par IA pour qualifier de « critique » la vérification factuelle et la relecture manuelle de tous ces contenus avant publication.
Google justifie cette consigne par le fonctionnement des modèles génératifs, qui prédisent une suite de mots probable au lieu de récupérer des faits, et peuvent donc produire des erreurs appelées hallucinations.
Google présente la mise à jour comme un alignement sur ses présentations aux événements développeurs.
La relecture doit couvrir le texte comme les métadonnées : balises title, meta descriptions, données structurées et textes alternatifs des images, qui peuvent s'afficher dans les résultats.
Google juge « critique » la vérification manuelle des contenus IA
La section « Focus on accuracy, quality, and relevance » contient désormais une phrase sans ambiguïté. Selon Google, il est « critique » de vérifier manuellement les faits et de relire tous les contenus générés par IA, pour leur exactitude et leur fiabilité, avant de les publier. Comme souligné par Barry Schwartz, Google emploie rarement le terme « critique » dans sa documentation Search.
Le cadre général de la page reste le même. Google y décrit toujours l'IA générative comme utile pour documenter un sujet ou structurer un contenu original. Il rappelle aussi que générer de nombreuses pages sans valeur ajoutée pour l'utilisateur peut enfreindre sa politique sur le « scaled content abuse » (c'est-à-dire la production de contenus en masse dans le but principal de manipuler le classement, quelle que soit la méthode de production).
Les hallucinations sont la justification avancée par Google
Google explique sa position par le fonctionnement même des modèles de langage. D'après la documentation, ces modèles ne récupèrent pas de faits : ils prédisent une suite de mots probable à partir de leurs données d'entraînement. Leurs productions peuvent donc contenir des inexactitudes, que Google désigne sous le terme d'hallucinations.
Pour rappel, on parle d'hallucination lorsqu'un modèle génère une information fausse présentée avec assurance : un chiffre inventé, une date erronée, une citation attribuée à la mauvaise personne ou une source qui n'existe pas. Le risque est d'autant plus élevé que le texte produit est fluide et ne trahit pas l'erreur.
La consigne porte sur « tous » les contenus générés par IA. Google ne précise en revanche ni méthode de vérification, ni niveau de contrôle attendu, ni seuil au-delà duquel un contenu serait considéré comme insuffisamment relu.
Les métadonnées et les données structurées entrent dans le périmètre
La documentation étend explicitement cette relecture aux métadonnées susceptibles d'apparaître dans les résultats de recherche. Elle cite quatre éléments :
Balise title : le titre de la page, souvent repris comme lien bleu dans les résultats.
Meta description : le résumé pouvant servir de snippet.
Données structurées : le balisage (Schema.org, en JSON-LD le plus souvent) qui aide Google à comprendre le contenu et peut déclencher des résultats enrichis.
Textes alternatifs des images : l'attribut alt qui décrit une image.
Pour les données structurées, Google ajoute qu'il faut respecter les consignes générales, les règles propres à chaque fonctionnalité de recherche, et valider le balisage pour rester éligible. La page recommande aussi de donner du contexte au lecteur sur la façon dont un contenu a été produit lorsqu'il est généré automatiquement, par exemple en expliquant le rôle de l'automatisation.
Côté e-commerce, la documentation renvoie aux règles de Google Merchant Center. Les images générées par IA doivent y porter la métadonnée IPTC DigitalSourceType avec la valeur TrainedAlgorithmicMedia (pour rappel, l'IPTC est un standard de métadonnées pour les images), et les titres ou descriptions de produits générés par IA doivent être fournis séparément et signalés comme tels.
Google parle d'une mise en cohérence documentaire
Dans son journal des mises à jour de la documentation Search, Google décrit le changement en deux lignes. Il indique avoir enrichi le guide avec des informations issues des Search Quality Raters Guidelines. Il justifie la modification par la volonté de synchroniser sa documentation avec les présentations utilisées lors de ses événements développeurs.
Pour rappel, les Quality Raters Guidelines sont les consignes remises aux évaluateurs humains qui notent la qualité des résultats de recherche. La page mise à jour renvoie à deux sections précises de ce document :
La section 4.6.5, sur l'évaluation du scaled content abuse,
Et la section 4.6.6, sur les contenus principaux créés avec peu d'effort, peu d'originalité et peu de valeur ajoutée
Google précise que ces évaluations servent à mesurer la performance de ses systèmes de classement et n'influencent pas directement le positionnement.
La spam update de septembre 2026 alimente les interprétations
Le calendrier de cette modification ne semble pas neutre. Google a annoncé la spam update de septembre 2026 le 24 septembre. Google a indiqué au média que ce déploiement durerait environ deux semaines. Est-ce que cette mise à jour cible spécifiquement les contenus IA non vérifiés, comme le pensent certains experts ? Une hypothèse impossible à vérifier pour le moment. Google n'a par ailleurs établi aucun lien officiel entre la modification de sa documentation et la spam update en cours de déploiement.
Ce que l'on peut dire toutefois est que ce durcissement s'inscrit dans une série de prises de position de la firme de Mountain View. Google a introduit sa politique sur le scaled content abuse le 5 mars 2024. Le 15 mai 2026, il a précisé que ses règles anti-spam s'appliquent aussi aux réponses générées par IA dans Google Search, le jour même où il publiait un guide sur l'optimisation pour ses fonctionnalités d'IA générative.
Qu'est-ce que ça change pour la création de contenu ?
A noter que la documentation de Google n'interdit pas l'IA générative et ne pénalise pas un contenu au seul motif qu'il a été produit avec elle. Elle pose en revanche une attente explicite : un humain doit vérifier ce qui est publié. Pour une équipe qui industrialise sa production, plusieurs postes sont concernés :
Vérification factuelle : chiffres, dates, noms et citations sont à contrôler sur la source primaire, pas sur la sortie du modèle.
Métadonnées : les title, meta descriptions et attributs alt générés en masse entrent désormais clairement dans le périmètre de relecture.
Données structurées : le balisage produit automatiquement doit être conforme aux règles de chaque fonctionnalité et validé.
Transparence : Google suggère d'indiquer au lecteur comment l'automatisation a été utilisée, lorsque c'est pertinent pour l'audience.
E-commerce : les images et fiches produits générées par IA doivent être signalées selon les règles de Merchant Center.
Reste que Google ne dit pas comment ses systèmes distingueraient un contenu relu d'un contenu publié tel quel. Les premières observations de la spam update ne permettent pas de trancher la question. Le consultant Glenn Gabe a relevé le 1er octobre sur X que les traductions automatiques de Reddit regagnaient de la visibilité dans plusieurs pays, dont la France, après avoir chuté lors des mises à jour de mai et juin 2026. Il rappelle que Google tolère la traduction par IA si le contenu est de qualité, sans savoir si ce retour relève d'un ajustement délibéré.
Nick Fox, SVP Knowledge & Information chez Google, affirme que les centaines de modifications imposées par le DMA rendent la recherche en Europe nettement moins bonne qu'ailleurs dans le monde.
Selon lui, Google a dû alléger ses protections antispam en Europe, ce qui conduit à afficher des résultats de moindre qualité, notamment sur l'abus de réputation.
Google a déposé le 29 septembre 2026 un recours devant le Tribunal de l'Union européenne contre l'obligation de partager des données de recherche, prévue pour janvier 2027.
Nick Fox conteste à nouveau les études sur la baisse des clics liée aux AI Overviews, sans avancer de chiffres, ce qui laisse les éditeurs sans données officielles pour mesurer l'impact réel.
Nick Fox dit sa « tristesse » de dégrader la recherche en Europe
Le dirigeant y revient sur les changements imposés par le DMA (Digital Markets Act, le règlement européen sur les marchés numériques qui encadre les grandes plateformes qualifiées de « contrôleurs d'accès »). Google avait déjà présenté ces changements comme la plus forte baisse de qualité de sa recherche en 28 ans d'existence. Nick Fox va plus loin sur le registre personnel : devoir dégrader le produit le fait se sentir « terrible » et le rend « triste ».
Sur LinkedIn, il pose le cadre : Google dit soutenir l'objectif du DMA, des marchés ouverts et concurrentiels, mais conteste la manière dont le texte est appliqué. Selon lui, chaque modification prise isolément paraît mineure, mais leur accumulation laisse aux Européens une recherche « nettement moins bonne que partout ailleurs ».
Prix, Maps, hôtels : les fonctionnalités retirées en Europe
Dans son post LinkedIn, Nick Fox affirme que Google a apporté « des centaines » de modifications à sa recherche en Europe en cinq ans. Il cite plusieurs exemples :
Prix des produits : impossibilité de consulter le prix actuel d'un produit directement dans la recherche.
Itinéraires : plus de clic direct vers Google Maps pour obtenir un trajet.
Hôtels : suppression du filtre par dates de séjour.
Vols : dans l'interview, il mentionne l'impossibilité d'afficher le prix d'un vol en temps réel.
Ces exemples sont présentés par Google comme des pertes pour l'utilisateur. Pour les acteurs tiers (comparateurs, agrégateurs, sites de voyage), ces retraits correspondent justement à l'espace que le DMA cherche à libérer.
Moins de protection antispam pour les résultats européens
Nick Fox évoque un autre effet, plus directement lié au SEO. Selon lui, Google a été « forcé de réduire » ses protections contre les sites qui cherchent à tromper ses algorithmes, et affiche donc des résultats de moindre qualité en Europe.
Dans l'extrait cité, il ne nomme pas de règle précise, mais cette déclaration semble avant tout viser l'abus de réputation de site. Pour rappel, cette règle antispam de Google sanctionne les contenus tiers publiés sur un site à forte autorité pour profiter de son classement. Cette pratique souvent appelée « SEO parasite ».
Autrement dit, Nick Fox pourrait sous-entendre que ces pratiques sanctionnées ailleurs pourraient rester visibles dans les résultats européens.
Google conteste devant la justice européenne le partage des requêtes
Le volet vie privée occupe une large part de l'interview. Une disposition du DMA oblige Google à transmettre des requêtes de recherche à des concurrents. Nick Fox estime que cela causera une « violation massive » de la vie privée des Européens. Ses arguments :
Nature des requêtes : les questions posées au moteur portent souvent sur la santé, les finances ou la famille, des sujets que l'on n'aborde pas toujours avec son conjoint ou son médecin.
Sécurité : une fois sorties des centres de données de Google, ces requêtes seraient exposées au piratage et à des usages abusifs.
Concurrence : les bénéficiaires ne seraient « généralement pas des entreprises européennes », ce qui ne favoriserait pas réellement la concurrence en Europe.
Anonymisation : dans son post, il juge que la décision n'impose pas d'anonymisation suffisante.
Partage des données de recherche : échéance fixée à janvier 2027.
Modifications sur Android : échéance fixée à juillet 2027.
Oliver Bethell, directeur senior de la concurrence chez Google, a déclaré que l'entreprise fait appel de décisions qui l'obligeraient à partager l'historique de recherche des internautes sans anonymisation suffisante et qui affaibliraient des protections de sécurité sur Android. Google avait été contraint en juin 2026 de permettre aux utilisateurs de transférer leurs données de recherche vers des tiers autorisés, comme des plateformes de récompenses ou des services de codes promo. Google a par ailleurs ouvert un programme de licence pour accéder à ces jeux de données.
L'enjeu financier est élevé. En cas de non-conformité au DMA, les amendes peuvent atteindre 10 % du chiffre d'affaires mondial annuel, 20 % en cas de récidive, auxquels peuvent s'ajouter des astreintes allant jusqu'à 5 % du chiffre d'affaires quotidien moyen.
Le zéro clic, « pas ce que nous constatons » selon Nick Fox
Le passage qui intéresse le plus les éditeurs arrive vers la douzième minute de la vidéo. Pietro Valetto explique qu'il ne clique souvent plus sur les liens, parce que le résumé généré par l'IA lui suffit.
Nick Fox répond que les internautes « cliquent encore beaucoup » vers le web. Il évoque les articles sur « la mort du web » ou le « zéro clic » (les recherches qui se terminent sans aucun clic vers un site), et affirme que ce n'est pas ce que Google observe. Il nuance toutefois : une question simple, à laquelle une réponse IA suffit, peut ne pas générer de clic. Mais selon lui, la plupart des recherches sont désormais plus longues et plus approfondies.
A noter que Nick Fox tenait déjà ce discours il y a un an, lorsqu'il remettait en cause les études sur les clics liés aux AI Overviews. Plusieurs études tierces ont mesuré une baisse des clics organiques en présence d'une AI Overview, comme l'étude d'Ahrefs sur l'impact des AIO en France un mois après leur déploiement. Google conteste ces études sans publier de données de clics ventilées permettant de les vérifier.
C'est la limite de cette prise de position : elle reste avant toute déclarative. Nick Fox ne cite par exemple aucun chiffre sur la part de recherches avec AI Overview suivies d'un clic, ni sur l'évolution du trafic envoyé aux sites. Les professionnels doivent donc continuer à s'appuyer sur leurs propres données (Search Console, analytics) pour mesurer l'effet réel sur leurs pages.
Imaginez un feed capable de vous suggérer une randonnée parce qu’il connaît votre région, sait que vous aimez marcher et estime que septembre et octobre offrent de bonnes conditions pour cette activité.
Un dimanche soir, il vous propose de nouveaux épisodes d’anime. La justification indique que leur calendrier de diffusion a été vérifié, que vous êtes abonné à des services compatibles et que ce créneau correspond bien à ce type de divertissement.
Le lendemain matin, il recommande une idée de repas riche en protéines parce qu’il a identifié une alimentation végétale, des achats cohérents avec cette habitude et un intérêt récurrent pour la nutrition.
Une autre story s’appuie sur la requête « recette crepe » et sur une visite de site de septembre 2025. Les justifications peuvent donc remonter jusqu’aux mots recherchés et aux dates de l’historique.
Pour cette analyse, Damien a examiné les stories et les métadonnées produites à partir de son profil : recherches Google, emails, factures, achats, agenda, abonnements, vidéos YouTube, conversations Gemini et autres traces d’activité. Les encarts ci-dessous reproduisent en anglais une sélection des textes relevés dans ses analyses.
Nous avons également analysé la version Android de Dreambeans publiée début septembre 2026, nom de code interne Lotus, pour comprendre comment Google transforme ces données en stories.
Dreambeans ouvre une étape nouvelle dans la personnalisation des feeds. L’objectif n’est plus seulement d’anticiper un clic. Le système essaie de déterminer ce qui pourrait être utile, intéressant ou opportun pour une personne à un moment donné.
Dreambeans, le feed proactif de Google
Google décrit Dreambeans comme un « proactive lifestyle AI product ». L’application génère chaque jour un ensemble fini de stories illustrées. Elles couvrent la technologie, le travail, la santé, la finance, les voyages, les loisirs, la famille, les restaurants ou les activités locales.
Une story transporte notamment les champs suivants :
Le sujet, la justification, la catégorie, le niveau de confiance et la durée de pertinence font partie du modèle de données. Chaque story peut également ouvrir sa propre conversation.
Dans le feed : une carte illustrée, un titre, un résumé et un créneau « MORNING ». Le sujet reprend ici le travail de Damien sur Google Discover.
La même carte ouverte : un texte développé, des liens vers des sites externes, un bouton « Read on SERoundtable », une explication de la recommandation et un accès au chat.
Compte tenu de ce que Google sait de cette personne et de ce qui se passe actuellement, qu’est-ce qui pourrait mériter son attention maintenant ?
Les cinq sources qui alimentent Dreambeans
Source
Ce que Dreambeans déclare pouvoir utiliser
Search
Recherches passées, lieux enregistrés et données issues de Search, Maps, Shopping, Flights, Hotels, Translate, News, AI Mode et Discover
Workspace
Emails, fichiers et événements, notamment Gmail, Calendar et Drive
YouTube
Intérêts issus de l’activité YouTube
Gemini
Historique des chats, informations communiquées à Gemini et insights déjà tirés de ces échanges
Google Photos
Photos, vidéos et informations permettant d’inférer intérêts, relations, lieux et moments
PERSONAL_CONTEXT_LOTUS_USING_SEARCH, WORKSPACE, YOUTUBE, PHOTOS et GEMINI_CHATS.
La nouvelle capture de connexion confirme les cinq familles : Google Workspace, Google Photos, YouTube, Search services et Gemini App. Pour Gemini, l’écran précise explicitement que l’historique des conversations fait partie des données connectées.
Le nouvel écran de confirmation affiche les cinq familles connectées. Gemini App apparaît désormais avec la mention « including chat history ».
La source Gemini va au-delà d’un simple historique de conversations. Google indique que les données partagées peuvent inclure « Gemini chat history and insights drawn from it ». Dreambeans peut donc recevoir à la fois ce qui a été dit à Gemini et des informations que Google a déjà déduites de ces échanges. Une fois cette source activée, l’application indique que l’historique Gemini sera utilisé dans les stories du lendemain.
Personal Context : la couche qui rassemble ces signaux
Google regroupe cette mécanique sous le nom de Personal Context. Dans les bibliothèques de consentement, la logique prend la forme d’une matrice :
PERSONAL_CONTEXT_<PRODUIT>_USING_<SOURCE>
Dreambeans, identifié par LOTUS, apparaît comme un consommateur parmi d’autres d’une infrastructure plus large. Sa combinaison actuelle repose sur Search, Workspace, YouTube, Photos et Gemini Chats.
Cette architecture explique la richesse des stories. Une facture Gmail, une recherche, un événement Calendar et une vidéo peuvent être rapprochés lorsqu’ils décrivent la même activité, le même projet ou le même intérêt.
Les textes relevés par Damien montrent le niveau de détail de ces rapprochements. Un extrait cite une facture pour cinq kilos de protéines de soja et une commande de merguez végétales. Un autre synthétise les préférences alimentaires du profil :
Alimentation : des achats précis aux préférences du profil
Mon Epicerie Paris invoice documents an August 2026 bulk purchase of 5kg textured soy protein medallions, paired with HappyVore plant-based merguez orders (June 30, 2026) and strict vegan and gluten-free dietary compliance.
Grounded in user profile records confirming a strict 100% vegan, plant-based diet with a preference for gluten-free whole foods and high-protein legume bowls. Verified whole-grain protein pairings and seed dressing emulsification techniques.
Dreambeans associe ici des produits, des quantités, des enseignes et des dates à une représentation du régime alimentaire. Avec les loisirs, abonnements de streaming, historique de visionnage et calendrier de sorties peuvent converger vers une recommandation pour le week-end.
L’alimentation végétale se retrouve aussi dans une story consacrée à JAPAN Fes NYC. La carte détaille des options de street food japonaise végétales, situe l’événement, donne ses horaires et propose de visiter le site officiel.
Une story réunit cuisine japonaise, options végétales et informations sur un événement. Elle propose aussi une question de suivi : « Any vegan street food? ».
Les données de départ restent des traces séparées. Dreambeans les assemble en une représentation plus synthétique des habitudes, des intérêts et des projets.
Le contexte professionnel est tout aussi détaillé. Le système décrit le rôle de Damien, le produit sur lequel il travaille et les technologies utilisées, puis évoque des optimisations précises :
Travail : du rôle professionnel aux détails du code
User is the co-founder and lead developer of 1492.vision, where he engineers real-time web analytics dashboards using Vue 3 and Vuero admin frameworks. Recent technical documentation in 2026 emphasizes modular composables and shallowRef optimizations for high-frequency data applications.
Les stories citent des recherches exactes, avec leurs dates
Les textes citent les mots saisis et, dans certains cas, le jour de la recherche.
Pour une recommandation liée aux performances du PC, le système mentionne ainsi la requête « transmit buffers ethernet gaming », effectuée quelques jours plus tôt, et la rapproche d’anciens diagnostics de pertes de paquets :
The user frequently conducts low-level PC hardware and system performance tuning, including explicit searches for network adapter driver settings ('transmit buffers ethernet gaming') on August 9, 2026, and past diagnostics for server packet drops.
Dans un exemple culinaire, il associe la requête « recette crepe » et une visite de cuisine.journaldesfemmes.fr.Une requête et une visite de site remontant à septembre 2025
Grounded in the user's historical query for 'recette crepe' and visit to French recipe portal cuisine.journaldesfemmes.fr on September 3, 2025. Verified through culinary science research on gluten relaxation and pan temperature standards.
Une trace vieille d’environ un an réapparaît donc dans la justification d’une story. Le texte la rapproche ensuite d’informations culinaires sur la pâte et la température de cuisson. Le système expose à la fois un élément de l’historique personnel et les informations externes utilisées pour développer le sujet.
Recherches, vidéos et visites de sites peuvent être rapprochées
Les formulations distinguent aussi les canaux. « Search history » et « Search logs » désignent des recherches, « watch history » des vidéos regardées, et « navigation » des visites de sites. Un même texte peut réunir plusieurs de ces traces et une préférence exprimée dans Dreambeans : Des vidéos regardées et des sites visités rapprochés des recherches
Supported by user watch history on August 19, 2026 ('Atelier Google Discover, avec Sylvain Deauré'), searches for 'discover' on March 17, 2026, and SEO consultant research in April 2025. Aligns with explicit preference for Google Search news recorded August 29, 2026, and the completed Google Spam Update on August 21, 2026.
Grounded in user navigation to cocktail publication PUNCH (punchdrink.com) on December 6, 2025, and searches for Japanese sake brewing processes and kanji terminology in May and June 2025.
Une story peut ainsi être justifiée par des activités de nature différente, réparties sur plusieurs mois.
Du Personal Context à la story
La génération repose sur un pipeline serveur nommé Manifold. Dreambeans planifie une mise à jour, lance le traitement puis suit son état :
SCHEDULED
↓
ONGOING
↓
FINISHED
Deux versions de prompts apparaissent dans le client :
La structure indique une génération en deux temps. Google extrait d’abord des topics à partir du Personal Context, puis génère des stories à partir de ces topics et du contexte disponible.
Les topics ont eux-mêmes un cycle de vie, avec deux niveaux actifs puis un état ARCHIVED. Un centre d’intérêt peut donc refroidir sans nécessairement disparaître du profil.
La génération peut se poursuivre lorsque l’application est fermée. Dreambeans conserve les credentials nécessaires au traitement en arrière-plan. Après une longue période d’inactivité, la création quotidienne est mise en pause jusqu’au retour de l’utilisateur.
Personal Context est aussi découpé dans le temps
Des traces runtime ajoutent une pièce importante au fonctionnement de Dreambeans. Le Personal Context n'apparaît pas uniquement sous la forme d'un état courant du profil. Nous avons observé des clés matérialisées par date, avec en parallèle des variantes real et sameday.
Dans l'échantillon observé, quatorze contextes datés coexistent, soit environ deux semaines de file. Les traces distinguent trois régimes :
pcontext:<YYYY-MM-DD>       contexte daté, préparé dans la file régulière
pcontext:<D>:sameday        passage de rattrapage pour le jour même
pcontext:real:<D>           branche plus immédiate, alimentée en parallèle
La grille observée associe une clé datée à une exécution overnight autour de 07:00 UTC la veille. Le chemin de production vu dans les traces suit l'ordre context → stories → story_selection → pcontext:dates → images. Le feed ne se remplit qu'une fois les images terminées, ce qui donne un éclairage concret au message utilisateur annonçant que les premières stories peuvent prendre « a few hours ».
Ces traces suggèrent que Dreambeans prépare une partie de son contexte personnel à l'avance, jour par jour, tout en conservant des voies pour le jour même et pour des signaux plus immédiats. Le timing de la recommandation est donc présent jusque dans la façon dont le Personal Context est matérialisé.
L’intérêt ne suffit pas : il faut aussi le bon moment
Les métadonnées de stories montrent à quel point le timing compte. Dans une story concernant les animes, les textes relevés citent des sorties d’épisodes, les abonnements du profil et un créneau précis dans la semaine : Anime : des sorties, des abonnements et un dimanche soir
Streaming calendars confirm August 30, 2026 episode releases for Mushoku Tensei Season 3, One Piece Elbaf Arc, and Grand Blue Season 3. User subscribes to Rakuten Viki and Netflix.
Ideal for Sunday evening, August 30, 2026, offering low-effort entertainment as part of the weekly anime broadcast schedule.
La justification affirme avoir vérifié le calendrier des sorties, puis présente le dimanche soir comme un moment adapté à ce divertissement.
Les structures de Dreambeans contiennent des créneaux MORNING, AFTERNOON et EVENING, ainsi qu’une expiration et un feedRecencyCutoff. On trouve également des champs nommés relevanceAndTimeWindowOfInterest et earliestDisplayLocalTime.
La pertinence personnelle peut donc varier avec la date, la saison et le moment de la journée. Une randonnée devient plus intéressante pendant une période de météo douce. Une sortie de jeu vidéo a plus de valeur pendant les premiers jours de son lancement. Un nouvel épisode d’anime peut être réservé au créneau du dimanche soir.
Le profil personnel est croisé avec des informations externes
Plusieurs stories de test incluent aussi des faits récents : calendriers de diffusion, sorties de jeux, saisonnalité d’une activité ou conditions locales. Certaines justifications utilisent des formulations comme Search verification confirms... ou Verified video game release calendars confirm....
Dans les structures du chat associé aux stories, nous avons retrouvé groundingEvidenceAndProvenance, mediaProvenance et une chaîne webSearch. Ces éléments indiquent la présence d’une couche de grounding dans l’expérience, même si nous n’avons pas encore capturé assez de payloads pour reconstruire précisément son rôle dans la génération initiale d’une story.
Le modèle général observé ressemble à ceci :
PROFIL PERSONNEL
intérêts + habitudes + agenda + lieux + achats
                    +
INFORMATIONS RÉCENTES
sorties + événements + conditions locales + saison
                    +
TIMING
jour + heure + période
                    ↓
                  STORY
La randonnée autour du Verdon en donne une bonne illustration. Une information géographique, un intérêt pour la marche et les conditions de début d’automne suffisent à faire émerger une recommandation locale et saisonnière. Randonnée : une commune, deux sentiers et une fenêtre saisonnière
User is based in a small town on September 1, 2026, immediately adjacent to the Verdon Regional Natural Park. Local trail conditions confirm optimal hiking weather during early autumn across the Sentier Blanc-Martel and Sentier de l'Imbut. Evergreen interest topic, particularly fertile throughout September and October 2026 due to ideal mild weather conditions and active trail shuttle services.
Le texte situe le profil près du Verdon, nomme deux sentiers et invoque la météo ainsi que les navettes pour justifier une fenêtre d’intérêt de deux mois.
Le cas de la localisation
Dreambeans déclare des permissions Android de localisation, mais nous n’avons trouvé aucun appel qui les utilise directement dans sa logique.
Google explique en revanche que les données Photos peuvent contenir une localisation estimée à partir du contenu ou attachée au fichier, et que cette localisation peut elle-même provenir de la localisation de l’appareil. Search apporte également les lieux enregistrés via Maps.
Une recommandation locale peut donc disposer d’un contexte géographique sans que Dreambeans interroge nécessairement le GPS au moment où la story est générée.
Google Photos ajoute le « qui, où, quand »
La description de Google Photos dans Dreambeans est particulièrement explicite. Google indique que Photos peut servir à inférer les intérêts de l’utilisateur, ses relations avec les personnes présentes dans les images et les lieux où il s’est rendu.
Le texte précise que le visage de l’utilisateur peut être associé aux données de localisation et aux timestamps correspondants.
QUI
+
OÙ
+
QUAND
Cette combinaison permet de transformer une collection de photos en informations sur les personnes, les lieux et les moments qui structurent une vie.
L’activation passe par Face Groups et par une brique nommée Photos Life Understanding. Le nom résume assez bien l’ambition : comprendre une vie à partir d’une photothèque.
Google ajoute que ces données peuvent servir à améliorer ses services, y compris pour l’entraînement de modèles d’IA générative.
storyWhy montre la recette de personnalisation
Chaque story possède un champ storyWhy. Dans les captures de stories ouvertes, l’explication de la recommandation est accessible par le bouton « Why did I get this? ».
Les justifications observées peuvent mentionner un abonnement, une recherche datée, une vidéo regardée, une visite de site, un achat, un projet ou un événement récent. Elles exposent parfois plusieurs signaux à la fois.
Dans une story consacrée aux jeux vidéo, l’historique d’achat est rapproché de la configuration matérielle. Le système cite les jeux, les plateformes d’achat, le modèle du SSD et la quantité de RAM. Ce rapprochement révèle l’étendue de l’historique utilisateur mobilisé pour produire une seule carte : Jeux vidéo : les achats rapprochés du matériel
Transaction history shows PC game key acquisitions (Call of Duty, Ratchet & Clank, Battlefield) via G2A and Gameseal, paired with high-end desktop hardware (Samsung 990 PRO 4TB SSD, Kingston 32GB DDR5 RAM). …
Les prompts restent côté serveur, mais leur empreinte est visible
Le texte intégral des prompts serveur qui pilotent la génération n'est pas livré dans l'application. Le client expose en revanche leurs versions, generateTopicsPromptVersion et generateStoriesPromptVersion, et les métadonnées observées sur les stories laissent voir une prose de travail très structurée.
Grounded in user profile records...
User profile confirms...
Transaction history shows...
Search verification confirms...
Verified ... release calendars confirm...
Highly relevant for morning...
Evergreen interest topic, particularly fertile throughout September and October...
Ces formulations reviennent autour de cinq opérations : rattacher la story à des preuves personnelles, synthétiser ce qu'elles disent de l'utilisateur, vérifier des faits extérieurs, évaluer la fraîcheur ou la fenêtre d'intérêt, puis justifier pourquoi le sujet mérite d'être montré maintenant.
Les exemples fournis par Google dans l'onboarding montrent la même ambition : repérer qu'un passeport expire six semaines avant un vol prévu huit semaines plus tard, retrouver un rendez-vous chez le dentiste enfoui dans un ancien email, détecter un atelier de pain au levain après des vidéos de pâtisserie ou suggérer vingt minutes de Pilates parce que l'utilisateur a demandé des séances plus courtes.
Le « Why » rend visible une partie du raisonnement qui a conduit à la card. C’est aussi ce qui donne à Dreambeans son côté le plus troublant : une recommandation anodine peut révéler combien d’informations différentes ont été rapprochées pour la produire.
On peut résumer cette compression en quelques étapes :
Dreambeans possède une taxonomie de ses propres erreurs
Le nouvel écran de dislike est probablement l’un des meilleurs indices sur la manière dont Google pense la qualité du feed. Son composant est nommé dislike_feedback_view.dart et l’interface demande :
Tell us what went wrong
Les réponses sont regroupées en quatre familles.
Le dislike est décomposé en erreurs de données personnelles, de faits, de visuel, de pertinence et de timing.
Accuracy & Substance
My personal info is wrong
Topic facts are wrong
Lacked depth
Visual
People or pets off
Irrelevant people
Objects or setting off
Relevance
Not for me
Repeated story
Seeing this too much
Steering ignored
Timing
Already happened
Old news
Plans changed
Wrong timing
Cette liste distingue les erreurs de données personnelles, les erreurs factuelles, les problèmes d’image, la mauvaise compréhension des intérêts et les erreurs de timing.
My personal info is wrong est le signal le plus intéressant. Google prévoit explicitement le cas où la représentation construite à partir du compte est incorrecte.
Le profil se corrige par des phrases, des clics et des swipes
Dreambeans permet aussi de déclarer directement ses préférences. Dans l’interface, un interstitiel peut proposer plusieurs choix et un champ Type your own.
Le chat permet également de formuler cette demande en langage naturel. Dans une capture, Damien écrit « I want more stories about SEO and algorithms ». L’application répond qu’elle a mis à jour le feed pour inclure davantage de stories sur ces sujets.
Dreambeans peut demander directement à l'utilisateur de choisir ou d'écrire ses préférences. Ici, un interstitiel sur les actualités Google Workspace.
Dans le chat, une demande de davantage de stories sur le SEO et les algorithmes reçoit une confirmation de mise à jour du feed.
Dans le modèle de données, une préférence possède un texte, une polarité et une origine :
Après un Not for me, l’application peut confirmer :
I've noted your preference to move away from stories like this one.
Les corrections explicites s’ajoutent à la télémétrie comportementale. Dreambeans enregistre notamment les impressions, les cards dépassées par swipe, l’ouverture complète, la fin de lecture, les likes, dislikes, sauvegardes et partages.
Les demandes formulées dans Dreambeans réapparaissent aussi dans les textes de personnalisation. Damien les identifie comme des directives issues du chat ou du bouton flottant de l’application. Cet extrait reprend une demande de contenus techniques sur les Knowledge Graphs et la recherche sémantique, datée des 30 et 31 août 2026 :Directive dans Dreambeans : une demande explicite de contenus techniques
The user explicitly requested technical deep-dives on Knowledge Graphs, entity resolution, and semantic search architecture on August 30 and 31, 2026. Recent technical literature highlights how multi-hop entity disambiguation errors compound in vector-only RAG without graph-guided filtering.
Les dates renvoient ici à une demande faite dans Dreambeans. Elles documentent un autre canal que les requêtes de l’historique Google Search.
Le système dispose donc à la fois de signaux implicites sur l’usage et de corrections très explicites sur ce qu’il a mal compris.
Supprimer une source, une story ou toutes les données Dreambeans
Google précise qu’une modification ou une suppression dans une application connectée peut mettre 24 à 48 heures avant d’être reflétée dans les nouvelles stories.
Les cards déjà générées restent dans le feed jusqu’à ce que l’utilisateur les supprime.
Une donnée source et le contenu généré à partir d’elle ont donc des cycles de vie distincts. Ce point devrait devenir important dans tous les produits d’IA personnalisés : supprimer l’information d’origine ne revient pas automatiquement à supprimer toutes les représentations déjà produites à partir d’elle.
Dreambeans propose aussi une commande globale, « Delete All Dreambeans Data ». L’écran de confirmation annonce la suppression des topics, des stories et des « profile information ». Il précise que cette action est irréversible, qu’elle ne supprime pas le compte Google et qu’elle n’affecte pas les autres services Google.
La suppression globale inclut explicitement les « profile information », en plus des topics et des stories. L’écran indique que le compte et les autres services Google ne sont pas concernés.
Le profil construit par Dreambeans apparaît donc aussi comme un ensemble de données nommé dans l’interface de suppression. Effacer un email dans Gmail, retirer une story et demander l’effacement de toutes les données Dreambeans correspondent à des périmètres différents.
Google précise aussi que les autorisations Dreambeans sont gérées indépendamment des réglages correspondants dans les autres services Google. L’application indique par ailleurs que des données provenant de Dreambeans peuvent être partagées avec d’autres services Google. Le périmètre exact de ce second flux n’est pas détaillé dans le client.
Et pour les éditeurs ?
Une card Discover renvoie vers un éditeur. Dans Dreambeans, la story ouverte présente déjà un texte développé et une illustration dans l’application, avec la possibilité de consulter des sites externes ou de poursuivre la conversation.
Les captures montrent clairement ces sorties vers le Web. La story sur Google Discover contient des liens vers 1492.vision et Search Engine Roundtable, ainsi qu’un bouton « Read on SERoundtable ». Celle sur JAPAN Fes NYC affiche un lien vers la page de l’événement et un bouton « Visit Official Site ».
Le Web peut servir à documenter une recommandation et rester accessible depuis la story. L’interface fournit toutefois déjà une synthèse adaptée au profil, avec des explications, des informations pratiques et des questions de suivi. Consulter le site externe est une possibilité au sein de ce parcours.
Pour les éditeurs, il faut donc regarder la place du lien, son libellé et ce qu’il propose d’apporter en plus du contenu déjà affiché. Une mention dans une story, un lien dans le texte et un bouton de sortie ne donnent pas la même visibilité à la source. Les captures montrent ces formats ; elles ne permettent pas de mesurer le trafic qu’ils génèrent.
Quand une story fournit déjà une réponse personnalisée, qu’est-ce qui donne encore envie d’ouvrir le site source ?
De « ce que vous aimez » à « ce qui compte maintenant »
La personnalisation historique d’un feed pouvait fonctionner avec une logique relativement simple : un intérêt observé entraîne davantage de contenus sur le même sujet.
Dreambeans ajoute plusieurs dimensions : les informations personnelles disponibles, les habitudes, les projets, le lieu, la saison, l’actualité du sujet et le moment de la journée. Il transforme ensuite les réactions de l’utilisateur en nouvelles préférences ou en corrections.
Le résultat donne un aperçu assez spectaculaire de l’évolution de la personnalisation chez Google.
La question centrale n’est plus seulement :
Sur quoi cette personne risque-t-elle de cliquer ?
Dreambeans tente d’aller plus loin :
Compte tenu de ce que nous savons de sa vie, de ses intérêts et de ce qui se passe maintenant, qu’est-ce qui mérite son attention aujourd’hui ?
Combien de liens ? Vers quelle page ? Pour quel montant ?
Le netlinking se décide encore trop souvent à l'intuition, faute d'une donnée qui relie l'effort d'acquisition au résultat attendu. Develink, acteur spécialisé dans la mise en relation entre annonceurs et éditeurs depuis dix ans, a pris le problème à l'envers dans un nouveau livre blanc : dix univers concurrentiels réels, un annonceur théorique par marché, et une seule question posée à chaque fois : « où l'euro suivant sera-t-il le plus rentable ? »
La méthode s'appuie sur le Develscore, un indicateur maison qui agrège les données de Majestic, Ahrefs et Semrush plutôt que de se reposer sur un seul outil, aucun n'étant parfait pris isolément. Cette approche est au cœur de Develink depuis 2015.
Loin d’être un plaidoyer pour un achat systématique de liens, ce livre blanc met en exergue la réalité du terrain. Sur certaines requêtes analysées verrouillées, qu’on vous laisse découvrir, le conseil est même plutôt de ne rien dépenser.
Les dix univers passés au crible
Le livre blanc de Develink analyse dix secteurs, chacun construit autour d'un annonceur théorique confronté à un panel de concurrents identifiés dans la SERP Google :
Mutuelle santé
Rentrée scolaire (cartables et fournitures)
Literie
Animalerie (univers chien)
Chauffage et climatisation
Golf
Smartphone reconditionné
Financement auto (LOA, LLD, crédit)
Paris sportifs
Banque et produits d'épargne
La méthode est identique pour chaque univers : diagnostic d'autorité de domaine, segmentation des mots-clés en quatre groupes d'action (défendre l'acquis, pousser une page dont l'autorité est déjà là, renforcer une page distancée, conquérir un terrain où le site est absent), lecture de la présence de l'AI Overview sur chaque requête, puis plan d'action séquencé avec un budget chiffré sur dix-huit mois.
Un déficit d'autorité globale qui ne dit pas grand-chose
Un petit exemple : l'univers banque et produits financiers, construit autour d'un annonceur théorique proche du Crédit Mutuel, illustre bien le constat qui revient d'un domaine à l'autre. Le site affiche une autorité de domaine dominante, avec près du double du nombre de domaines référents de son panel de concurrents. Mais cette force ne se traduit pas mécaniquement en positions : les pages qui portent les requêtes ciblées ne comptent, elles, que de deux à cent quarante-trois domaines référents selon les cas.
Le blocage ne se situe donc presque jamais au niveau du domaine, mais de l'URL. C'est là, selon l'étude, que la plupart des budgets de netlinking se perdent.
L'asymétrie du budget, un motif récurrent
Sur l'univers épargne, le rapport dévoile quant à lui un déséquilibre marquant : les mots-clés les moins coûteux à conquérir couvrent 85 % du volume de recherche pour seulement 2 572 euros, quand le mot-clé le plus concurrentiel du corpus mobilise à lui seul la majorité de l'enveloppe totale. Le même type d'asymétrie revient sur plusieurs univers analysés, notamment la rentrée scolaire, où 81 % du budget suggéré porte sur seulement 22 % du volume adressable.
Autre enseignement transversal : le rapport repère régulièrement des cas de cannibalisation, deux URL d'un même site positionnées sur la même requête, qui diluent l'effort de netlinking tant qu'une cible n'a pas été désignée.
L'AI Overview redistribue les priorités
Sur plusieurs univers, notamment l'épargne, la majorité des requêtes déclenchent déjà un AI Overview. Le rapport recommande de prioriser les mots-clés encore épargnés par ce format tant que la fenêtre reste ouverte, et de concevoir le contenu des pages concernées par l'AI Overview pour être cité par l'IA plutôt que pour viser uniquement la première position organique.
Télécharger le livre blanc
Vous souhaitez en savoir plus ? Le guide complet, avec le détail des dix univers, les tableaux de données et les plans d'action chiffrés, est disponible gratuitement en téléchargement !
Tester la méthode sur votre propre site, gratuitement
Jusqu'au 31 octobre 2026, Develink offre aux lecteurs d'Abondance l’analyse concurrentielle et financière présentée dans ce livre blanc : diagnostic d'autorité, groupes de mots-clés, budgets suggérés et lecture de l'AI Overview appliqués à son propre univers concurrentiel.
Google a modifié ses résultats de recherche dans l'UE le 8 septembre 2026 pour respecter le DMA, et qualifie ce changement de plus grande dégradation de la qualité de son service en 29 ans d'existence.
La nouvelle interface met en avant des comparateurs comme Booking.com ou Expedia, au détriment des entreprises qui n'apparaissent plus qu'avec un simple lien, un numéro de téléphone et une adresse.
Google affirme que ces ajustements ont déjà fait chuter de 30 % le trafic de réservation directe vers les entreprises européennes, et s'attend à une aggravation avec cette nouvelle version.
Ces changements interviennent après une amende de 460 millions d'euros infligée en juillet, portant le total des sanctions européennes contre Google à 10,38 milliards d'euros.
Ce que Google reproche à sa propre mise à jour
Selon les déclarations transmises à Reuters, Google estime que les nouvelles règles imposées par l'UE profitent avant tout aux sites de comparaison de prix, aussi appelés services de recherche verticale (VSS), actifs dans des secteurs comme l'hôtellerie, les vols ou la restauration. Des acteurs comme Expedia ou Booking.com gagnent ainsi en visibilité, alors que les entreprises de ces mêmes secteurs qui ne passent pas par ces intermédiaires se retrouvent réduites à un lien vers leur site, un numéro de téléphone et une adresse.
Nick Fox, vice-président senior en charge de la connaissance et de l'information chez Google, a résumé la position de l'entreprise dans une déclaration à Reuters : ces changements dégradent l'expérience des utilisateurs européens, favorisent des intermédiaires en ligne au détriment des commerces locaux, et suppriment des fonctionnalités utiles au quotidien. Il précise que les utilisateurs situés en dehors de l'UE ne sont pas concernés par cette évolution.
À quoi ressemble la nouvelle page de résultats
La refonte introduit une hiérarchie précise dans l'affichage des moteurs spécialisés. Un premier moteur de recherche spécialisé est mis en avant en haut de page, suivi de deux autres présentés avec moins de détails. En dessous apparaît un carrousel regroupant des offres d'hôtels, de vols ou de restaurants, mais sans les informations en temps réel comme les prix, qui ont été retirées de cet affichage. Le classement de ces éléments reste déterminé par l'algorithme de Google.
Des conséquences économiques déjà mesurées
Google indique que les précédents ajustements liés au DMA avaient déjà entraîné une baisse de 30 % du trafic de réservation directe et gratuite vers les entreprises européennes. L'entreprise s'attend à ce que la nouvelle vague de changements amplifie ce phénomène. Selon ses propres tests menés auprès de millions d'utilisateurs en Europe, le niveau d'insatisfaction est élevé, une partie des utilisateurs devant reformuler leurs requêtes pour retrouver ce qu'ils cherchaient initialement.
Un contentieux qui s'accumule depuis près de vingt ans
Ce nouvel épisode s'inscrit dans un bras de fer prolongé entre Google et les autorités européennes. En juillet 2026, la Commission européenne avait infligé à l'entreprise une amende de 460 millions d'euros pour avoir favorisé ses propres services dans les résultats liés au shopping, aux hôtels, aux transports et au sport, en violation du DMA. Un délai de 60 jours avait alors été accordé à Google pour se mettre en conformité, sous peine de pénalités pouvant atteindre 5 % de son chiffre d'affaires mondial.
Une seconde amende de 430 millions d'euros a été prononcée le même mois, cette fois pour des restrictions empêchant les développeurs d'applications de rediriger gratuitement leurs utilisateurs vers des offres moins chères sur des boutiques ou sites concurrents. Google indique avoir déjà mis à jour son programme d'offres externes sur Google Play pour répondre à ce grief, après avoir annoncé dès août de l'année précédente des ajustements facilitant l'orientation des utilisateurs vers d'autres canaux et le choix d'un modèle de commission.
Au total, les sanctions antitrust infligées par l'UE à Google atteignent désormais 10,38 milliards d'euros, dans un contentieux qui dure depuis près de deux décennies. Ces amendes ont également suscité une réaction du président américain Donald Trump, qui a menacé d'ouvrir une enquête sur ce qu'il a qualifié de spoliation des entreprises américaines par le bloc européen.
Google a par ailleurs publié un nouveau document d'aide détaillant les différences régionales de son expérience de recherche, confirmant que ces changements restent circonscrits à l'Union européenne.
Le 22 septembre 2026, la SEO Garden Party fait sa rentrée des classes ! Pour cette 22e édition, on ne change pas une formule qui a largement fait ses preuves. La SEO Garden Party, c'est une journée entière autour du Search Marketing. Un événement en ligne 100 % gratuit pour parler du SEO et du GEO sous toutes ses coutures ! Pour y participer, rien de plus simple : s'inscrire !
Une nouvelle édition particulièrement variée !
GEO, Google Search, AI Overviews, Google Maps, LinkedIn, Reddit... Pour cette rentrée, les intervenants vont s'attarder sur l'incontournable question de l'intelligence artificielle, mais c'est loin d'être la seule thématique stratégique qui sera abordée.
Que vous soyez SEO, consultant, développeur ou que vous ayez simplement envie de mieux comprendre les mutations du web, cette SEO Garden Party est un événement à ne surtout pas manquer !
À noter que cette édition du 22 septembre 2026 sera suivi d'une autre édition en novembre. On vous en reparle bientôt !
Chaque édition de la SEO Garden Party est l'occasion d'écouter des experts partager leurs retours terrain, leurs méthodes et leurs visions sur l'évolution du Search. L'événement est reconnu pour la qualité de ses interventions, son accessibilité et la richesse des échanges.
« La SEO Garden Party est un événement incontournable pour tous ceux qui veulent progresser en SEO. Les conférences offrent des retours d’expérience concrets et des conseils directement applicables. C’est rare de trouver un contenu aussi riche et gratuit. » - Victor Lerat, Directeur Abondance
Reach est un nouvel outil du projet NicheObserver, présenté le 8 septembre par Kevin Richard (512banque) lors d'un live sur X
Il permet d'estimer la taille de l'audience d'un site à partir des données Chrome (CrUX) publiées par Google, sans révéler de nombre de visites exact
Chaque domaine reçoit un score de reach de 0 à 100, une tranche de popularité, un marché principal probable et un historique sur 24 mois
L'outil est gratuit dans sa version actuelle, avec un mode bulk, un accès API, une extension via SEObserver et un serveur MCP pour les agents IA
Reach est présenté comme une alternative gratuite à Similarweb, capable de dire si un site a de vrais utilisateurs, à quelle échelle et sur quel marché, sans détailler les sources de trafic ni les visiteurs uniques
Un outil pensé comme une alternative gratuite à Similarweb
Comme annoncé par Kevin Richard dans son live du 8 septembre 2026, Reach se positionne comme une alternative gratuite à des outils comme Similarweb pour évaluer la taille d'un site. Contrairement aux estimations basées sur des panels ou des modèles statistiques, l'outil s'appuie directement sur le CrUX, le jeu de données que Google publie chaque mois à partir des chargements de pages réels effectués par des utilisateurs Chrome éligibles, sur ordinateur et sur Android. Les visites Safari et iOS restent hors du périmètre.
Selon les chiffres affichés, la base couvre plus de 35 millions de domaines interrogeables sur 24 mois, plus de 40 millions d'origins, et 238 pays et territoires. Pour le seul mois d'août 2026, environ 13,9 millions de domaines ont été observés.
Comment fonctionne le score de reach
Plutôt que d'afficher un nombre de visites, que Google ne publie pas, NicheObserver traduit les données brutes du CrUX en un score de 0 à 100, l'adjusted_reach_score, qui sert de signal principal pour comparer des domaines entre eux. Ce score s'accompagne d'un reach_score propre à la meilleure origin du domaine, et d'un popularity_rank_bucket qui indique une tranche d'appartenance (top 1 000, top 10 000, top 1 million, etc.) plutôt qu'un classement précis.
Un domaine classé dans une tranche donnée n'a pas nécessairement une position connue à l'intérieur de cette tranche, et un score à 0 signifie simplement que le domaine n'a pas été observé sur le mois concerné, pas qu'il a disparu.
L'outil permet aussi de repérer le marché principal d'un site (le pays où son audience est la plus concentrée), avec un niveau de confiance associé, ainsi que l'historique mensuel du score sur 24 mois pour suivre une progression ou un recul dans le temps.
Exemple du site de la CAF - Source : NicheOserver
Ce que propose l'outil dès aujourd'hui
Lors de sa présentation, Kevin Richard a précisé que l'ambition était de « dépixeliser la data » du CrUX pour la rendre directement exploitable par les professionnels du SEO. Dans sa version actuelle, Reach s'appuie uniquement sur les données gratuites du CrUX. Une offre payante est annoncée pour les prochains mois, au moment du lancement complet de NicheObserver.
Plusieurs modes d'accès sont déjà disponibles :
une recherche unitaire par domaine, hostname, origin ou URL
un mode bulk pour interroger plusieurs domaines à la fois
un accès via API, avec des exemples d'intégration donnés pour Codex et Claude Code
une extension proposée via SEObserver
un serveur MCP, pensé pour être branché à des agents IA
Un pont entre NicheObserver et SEObserver est également annoncé, sans que le calendrier précis n'ait été communiqué.
Le positionnement affiché : une alternative gratuite à Similarweb
Dans sa présentation, Kevin Richard revendique frontalement la comparaison avec Similarweb, en résumant son outil comme la promesse d'obtenir gratuitement ce que d'autres facturent pour vérifier si un site reçoit du trafic et comment ce trafic évolue.
Il insiste sur un point de méthode : le CrUX agrège des chargements de pages réels, quelle que soit leur origine, recherche, publicité, email, lien entrant ou accès direct. Reach ne cherche donc pas à décomposer les sources de trafic ni à donner un nombre de visiteurs uniques. La promesse est plus modeste et plus factuelle : dire si un site a de vrais utilisateurs, à quelle échelle, et sur quel marché.
Pour illustrer la fiabilité du signal, l’intéressé cite un test mené sur des sites dont il avait accès aux vraies statistiques. Sur l'un d'eux, l'outil a détecté l'apparition d'un nouveau marché en janvier 2026, le mois exact où les clics de la Search Console de ce site avaient triplé. Il invite d'ailleurs la communauté à tester l'outil sur des sites qu'elle connaît bien, pour vérifier où le signal se trompe.
Les limites à connaître
L'outil ne prétend pas offrir un recensement exhaustif du web. Certains sites sont absents des données, notamment ceux qui sont en noindex. Plus largement, Google applique ses propres critères d'éligibilité et de confidentialité pour intégrer une page au CrUX, ce que NicheObserver ne peut pas contourner.
Autre point de vigilance signalé par l'outil lui-même dans sa documentation : une variation du score de reach d'un mois sur l'autre ne signifie pas automatiquement une variation de trafic. Un changement de couverture du CrUX peut produire le même effet. D'où la recommandation de lire l'évolution sur plusieurs mois plutôt que sur un seul point.
ChatGPT fait tourner sa propre famille d'index appelée Labrador, qui couvre le web général, le PDF, YouTube, l'actualité, arXiv, Wikipédia, le local, la finance, le juridique, le médical, le shopping et les images.
Un témoignage de Nick Turley (responsable de ChatGPT) lors du procès antitrust de Google confirme que ce projet remonte à 2023, avec un objectif initial ambitieux de répondre à 80 % des requêtes via cet index propriétaire dès la fin de cette même année.
ChatGPT teste actuellement en conditions réelles son propre index contre des résultats scrapés, notamment sur les résultats shopping, via plusieurs expériences A/B en cours.
Google et Microsoft restent des fournisseurs importants : ChatGPT s'appuie sur au moins huit prestataires externes en plus de son propre index, dont Yelp, TripAdvisor et Web IQ de Microsoft.
Labrador, une famille d'index plutôt qu'un simple raccourci vers Google
Entre le 21 mai et le 21 juillet 2026, un champ nommé result_source apparaissait directement dans les événements serveur (SSE) de ChatGPT, révélant l'origine exacte de chaque résultat. Ce champ ne prenait que quatre valeurs possibles : Labrador, Bright, Oxylabs et SERP. Trois de ces sources sont des prestataires de scraping externes. La première, Labrador, est l'index propriétaire d'OpenAI.
En réalité, Labrador n’est pas un index unique, mais plutôt un ensemble de sous-index spécialisés par catégorie :
Web général
PDF
YouTube
Actualité, avec des niveaux distincts pour le dernier jour, les sept derniers jours et le reste
arXiv
Wikipédia
Local
Finance, avec un sous-index dédié aux PDF financiers
Juridique
Médical
Shopping
Images
Cet index stocke des données similaires à celles d'un moteur de recherche classique comme Google : contenu complet des pages, date de crawl et date de publication. Cette architecture reproduit ce que Google a mis deux décennies à construire, à savoir un index web généraliste complété par des index verticaux spécialisés selon le type de contenu.
Des offres d'emploi qui confirment la construction d'un index propriétaire
Plusieurs offres d'emploi publiées par OpenAI apportent des indices concrets sur cette infrastructure.
Une offre de poste "Software Engineer, Foundations Search" mentionne explicitement la conception et l'exploitation de systèmes d'indexation, de pipelines de récupération et de couches de service.
Une offre pour un poste d'"Engineering Manager, Online Data Systems" va plus loin : l'équipe Online Data y est décrite comme responsable de la base de données en ligne centrale et des services d'indexation derrière les applications de production d'OpenAI, ChatGPT compris. Cette même offre évoque une infrastructure fonctionnant à l'échelle de l'exaoctet, répartie sur plusieurs régions et plusieurs clouds. Un exaoctet représente 10 puissance 18 octets, soit un 1 suivi de 18 zéros, une échelle qui ne se justifie pas pour un système qui se contenterait de relayer des requêtes vers l'index de quelqu'un d'autre.
Une troisième offre, centrée sur la récupération par embeddings, demande explicitement la conception de nouveaux objectifs d'entraînement d'embeddings, d'architectures de vector store scalables et de méthodes d'indexation dynamique, avec un travail sur des représentations denses, éparses et hybrides. La représentation éparse renvoie au vocabulaire du TF-IDF et du BM25, les techniques de classement lexical sur lesquelles Google lui-même s'est construit. Associée aux embeddings denses, cette combinaison correspond exactement à ce qu'il faut pour faire fonctionner une fusion de rang réciproque (RRF), un mécanisme documenté par Metehan Yesilyurt, chercheur GEO chez Peec AI.
Un projet qui remonte au procès antitrust de Google, en 2024
La construction de cet index n'est pas récente. Elle démarre au début de l'année 2024, au moment où Google constatait de son côté que les systèmes RAG réduisaient les hallucinations des modèles de langage.
Pour bâtir son propre index, ChatGPT avait besoin d'un fournisseur de données de recherche sur lequel s'appuyer. Lors du procès antitrust de Google, Nick Turley, responsable de ChatGPT, a témoigné sous serment sur ce sujet précis. Il a expliqué qu'OpenAI rencontrait des problèmes de qualité importants avec les données de recherche fournies par des partenaires autres que Google, et que l'entreprise souhaitait à l'époque travailler avec Google. Une offre que Google a refusée.
Ce refus explique pourquoi OpenAI a dû se rabattre sur un plan B : construire son propre index en interne. Selon le témoignage de Turley, OpenAI a commencé à bâtir cet index dès 2023, avec pour objectif de répondre à 80 % des requêtes grâce à cet index avant la fin de cette même année, un calendrier extrêmement ambitieux pour un projet parti de zéro.
Le même témoignage livre un chiffre bien différent : même avec un accès complet aux données de l'index de Google, il faudrait à OpenAI au moins cinq ans pour simplement déterminer si répondre à 100 % des requêtes via son propre index est réalisable. Cet horizon, bien plus long que l'objectif initial de 80 % fin 2023, montre qu'une indépendance totale vis à vis des fournisseurs externes ne se décrète pas. Elle se construit progressivement, requête par requête, sans garantie d'y parvenir un jour. La stratégie semble être restée la même depuis le départ : s'appuyer sur des fournisseurs externes comme Google pour démarrer, puis augmenter chaque année la part de son propre index.
Le shopping, la vitrine la plus visible de cette bascule
Pour observer l'index d'OpenAI en action, le secteur du shopping offre l'exemple le plus parlant. En mi-août 2026, une expérience A/B nommée "prefer-index-over-serp-v3" affectait 8 % des conversations. OpenAI teste donc son index produit sur des tranches de trafic allant de quelques pourcents jusqu'à 20 %.
Les détails techniques d'implémentation n'ont pas pu être établis pour cette expérience précise, mais ils ont pu l'être pour une autre, nommée "shopping-reduced-topn-v4b". La pile technique qui en ressort se décompose ainsi :
Une composante lexicale BM25, qui réduit le champ à dix sources pour le classement.
Un module rerank400, qui reclasse un pool de 400 candidats.
Un pool d'entrée prod400, composé de 400 produits.
Une recherche vectorielle par plus proches voisins approximatifs (ann4096), exécutée sur deux dimensions différentes, 12 288 et 4 096.
Au 2 septembre 2026, au moins cinq expériences liées au shopping tournaient encore en parallèle : prefer-index-over-serp-v3, chatgpt-shopping-noamazon, shopping-index-q2qb, shopping-hqi-v2 et shopping-hq-v1. Il n'est pas confirmé que "hqi" signifie "high quality index", mais il est établi que prefer-index-over-serp-v3 et shopping-index-q2qb reposent toutes deux sur l'index propre de ChatGPT.
Cinq expériences actives simultanément sur du trafic shopping réel témoignent d'une équipe qui construit activement un index produit et valide sa fiabilité avant un déploiement complet.
Pourquoi ChatGPT met aussi en cache des pages entières
La récupération en direct est trop lente pour être utilisée à chaque requête. Selon le HTTP Archive Almanac, 58 % des pages web mettent plus de 0,8 seconde à se charger, un délai incompatible avec l'échelle à laquelle ChatGPT opère.
Cette contrainte a orienté vers l'hypothèse d'un cache, sur le modèle d'anciens brevets Google décrivant la conservation des pages les plus consultées dans un index séparé et plus rapide. Pour vérifier cette hypothèse, Metehan Yesilyurt a publié un site de test contenant un milliard de pages, dans le seul but d'observer le comportement de crawl de ChatGPT. Début septembre 2026, 6 millions de ces pages avaient déjà été explorées, à un rythme de 35 000 requêtes par heure, et le crawl se poursuivait.
Un crawl aussi intensif n'a de sens que si les pages récupérées sont conservées quelque part : les récupérer pour les jeter immédiatement n'aurait aucun intérêt. La mise en cache permet aussi à OpenAI d'anticiper les tâches coûteuses, comme le calcul des embeddings en amont et le filtrage des pages de faible qualité avant qu'elles n'entrent dans le pipeline, plutôt que de refaire ce travail à chaque requête.
Pour confirmer cette hypothèse, un test a été mené avec le mode verrouillé de ChatGPT, qui empêche la navigation en direct mais permet toujours de renvoyer des résultats hors ligne ou mis en cache. La même question, portant sur la dernière version de la page d'accueil, a été posée pour plusieurs éditeurs SEO majeurs, dont Search Engine Journal, Search Engine Land et Search Engine Roundtable. Dans chaque cas, ChatGPT ne récupérait pas les pages en direct mais les servait depuis son propre cache.
Google et Microsoft n'ont pas disparu du paysage
ChatGPT n'a pas remplacé les moteurs de recherche classiques. Il continue de s'appuyer sur plusieurs fournisseurs, dont Google et Microsoft.
Un test mené par Malte Landwehr, CPO chez Peec AI, illustre cette dépendance persistante à Google. Il a sélectionné un site sans trafic organique et a posé des questions le concernant uniquement à ChatGPT, sur des jours précis. Ces jours-là, Google Search Console affichait un pic de trafic pour ce site précis, une preuve directe que ChatGPT continue d'interroger Google pour étayer ses réponses.
Bing apparaît également, principalement dans les sessions de Deep Research. Les événements SSE diffusés pendant une session de Deep Research font clairement référence à Bing comme source de résultats, comme l'a signalé le chercheur GEO Peec AI David Konitzny sur LinkedIn.
La plateforme de grounding Web IQ de Microsoft, qui met en avant une latence P95 inférieure à 165 millisecondes et une récupération économe en tokens, cite directement ChatGPT parmi les produits qu'elle alimente déjà, aux côtés de Copilot et de clients entreprise comme Nasdaq.
En rassemblant tous les fournisseurs identifiés au fil de cette enquête, ChatGPT combine au moins huit sources externes en plus de son propre crawler :
Son propre crawler, qui fonctionne indépendamment de tout moteur de recherche externe.
Bright, très probablement Bright Data, qui scrape directement les résultats web de Google et, séparément, Google Maps pour les fiches locales.
Oxylabs, qui scrape Google et alimente spécifiquement le sous-index actualité.
Un troisième canal de scraping de résultats de recherche, identifié simplement sous "serp" dans les données, qui alimente également l'actualité ainsi qu'une version mixte de résultats locaux.
Yelp.
TripAdvisor.
Deux canaux internes anonymes, nommés b1 et b3 : b1 remonte les sites d'entreprises et les pages Facebook, b3 redirige vers Google Maps.
Web IQ, la plateforme de grounding de Microsoft, confirmée par Microsoft comme alimentant déjà ChatGPT aux côtés de Copilot et de Nasdaq.
Ce que cela change concrètement pour votre stratégie
Considérer que la visibilité sur Bing garantit la visibilité sur ChatGPT n'est plus une hypothèse fiable. Le rapport entre les deux est plus faible qu'on ne le pense, et ce qui ressemble à du Bing peut en réalité transiter par Web IQ de Microsoft, un produit différent conçu pour d'autres usages.
Si vous vendez des produits, il est indispensable de surveiller spécifiquement votre apparition dans les résultats shopping de ChatGPT. C'est aujourd'hui l'endroit où la bascule vers l'index propriétaire est la plus visible, et elle affecte directement la sélection des produits affichés.
Si les fiches locales comptent pour votre activité, soignez-les en priorité sur Yelp et TripAdvisor, traités comme des partenaires sous licence. Les données de Google Maps atteignent de toute façon ChatGPT, mais sans que vous ayez votre mot à dire sur la manière dont elles sont sourcées.
Enfin, le mode verrouillé de ChatGPT permet de vérifier concrètement si vos pages les plus importantes ont déjà été mises en cache, un test simple à reproduire pour évaluer votre propre visibilité dans ce système.
SEO programmatique va rarement de pair avec contenu de qualité
Dans une réponse publiée sur Bluesky, John Mueller met en garde contre le SEO programmatique. Selon l’intéressé, cette pratique peut amener à ce que le site soit perçu comme spam ou quasiment, ou de faible qualité.
Pour rappel, le SEO programmatique consiste à générer automatiquement un grand nombre de pages en combinant des listes de mots-clés, noms de domaines, technologies, attributs, etc. Et générer toujours plus de contenus automatisés n’améliore pas l’utilité réelle pour les internautes.
John Mueller souligne notamment que les systèmes de Google peuvent perdre confiance dans la capacité d’un site à apporter de la valeur, en raison de l’historique de ses anciennes pages. Une fois cette confiance perdue, la récupérer nécessite du temps et des efforts importants. Il compare cette situation aux cas des sites touchés par les Core Updates ou les Spam Updates. Il ne s’agit toutefois pas d’un jugement définitif, mais un avertissement général sur les risques représenté par le contenu généré en masse sans réelle valeur ajoutée.
Qu’il soit créé de façon automatisée ou pas, il vaut toujours mieux privilégier un contenu à forte valeur ajoutée. C’est une règle de base, qui limite un certain nombre de risques.
Une étude de SALT.agency portant sur 1 052 migrations de nom de domaine (Dan Taylor, 2026) donne la mesure du phénomène : la durée médiane de récupération du trafic organique est d'environ dix mois, et 42 % des migrations mettent plus d'un an à retrouver leur niveau d'avant bascule. Autant dire que le sort d'une migration ne se joue pas le jour du go-live, mais dans les semaines et les mois qui suivent.
La plupart des ressources disponibles sur le sujet détaillent très bien ce qu'il faut vérifier avant de basculer un site : plan de redirection, titles, canonicals, hreflang, indexabilité. Ce qui est moins souvent traité, c'est la question du pilotage. Concrètement, avec quels outils une équipe SEO peut-elle suivre une migration du premier crawl jusqu'aux semaines qui suivent le lancement ? Le plus souvent, elle passe par plusieurs outils qui ne communiquent pas entre eux : un crawler pour l'audit, un export Search Console pour les positions, un tableur pour le plan de redirection ou encore un ticket dev pour chaque correction. Chaque bascule d'outil est une occasion de perdre du temps ou de l'information. C'est ce fil continu, de la préparation jusqu'aux semaines qui suivent le lancement, que cet article propose de reconstruire.
1 - Préparer : avoir une vision d'ensemble avant de toucher au site
La clé du succès repose sur la capacité à comparer l'avant et l'après. Avant de toucher au site, il faut disposer d'un état des lieux complet. Celui-ci inclut la liste exhaustive des URLs existantes, l'état de leurs signaux SEO et une vision claire des priorités de correction.
C'est ce que permet la plateforme Fasterize. Historiquement centrée sur l'optimisation, elle couvre désormais l'ensemble du cycle : détecter les anomalies, tester et déployer les corrections, puis en démontrer l'effet. Son crawler propriétaire contrôle les principaux signaux techniques d'un site (titles, meta descriptions, hreflang, canonicals, H1, status HTTP, meta robots, attributs alt) et restitue le résultat sous une forme directement exploitable : un score de santé SEO qui synthétise l'état du site, accompagné de la liste des optimisations prioritaires, du volume de pages concernées et des URLs impactées.
Dans un contexte de migration, ce score joue un double rôle. Avant la mise en production, il permet de repérer rapidement les zones à risque plutôt que de dérouler un audit manuel, page par page. Après le go-live, le même contrôle permet de vérifier en quelques minutes que rien n'a été cassé au passage, sans attendre le prochain crawl programmé.
2 - Sécuriser : agir sur les signaux SEO sans dépendre du planning de développement
Une migration ne se résume pas à un plan de redirections 301, même si c'est souvent le poste de risque le plus visible. Il s'agit aussi de préserver tout ce qui permet aux moteurs de comprendre correctement le nouveau site, et de garder la capacité de corriger vite si une anomalie apparaît après le lancement.
C'est justement ce que la plateforme prend en charge : les plans de redirections, même volumineux, se déploient directement depuis l'interface, sans dépendre d'un développement spécifique.
De la même façon, les principaux signaux SEO (meta, canonicals, hreflang, robots) peuvent être ajoutés ou corrigés indépendamment des capacités du CMS : une canonical mal orientée ou un hreflang cassé se corrigent sans toucher au template. Et ces corrections se déploient rapidement, sans attendre un cycle de développement complet.
Ce dernier point compte particulièrement dans les jours qui suivent un go-live, moment où les anomalies remontent vite, mais où les équipes techniques sont rarement disponibles pour pouvoir déployer un correctif rapidement.
3 - Mesurer : objectiver la reprise plutôt que la deviner
Une fois le site en ligne, la question centrale change de nature : est-ce que les optimisations mises en place produisent un effet réel, et à quel rythme ? Sans point de comparaison clair, il est difficile de distinguer une volatilité normale d'une vraie perte, surtout que cette phase de stabilisation peut s'étaler sur plusieurs semaines.
La plateforme intègre pour cela les données de Google Search Console. Pour chaque recommandation mise en œuvre, il devient possible de suivre son évolution à travers les mêmes indicateurs que ceux de Search Console (clics, impressions, CTR, position moyenne), avec deux niveaux de lecture, par URL et par requête. Un repère visuel indique à quel moment une recommandation a été déployée, ce qui facilite directement les analyses avant/après.
Concrètement, cette fonctionnalité permet de relier une action précise (une correction de canonical ou un redéploiement de redirections, par exemple) à son effet mesuré, plutôt que d'observer une courbe globale sans savoir quelle décision l'a fait bouger.
4 - Corriger : boucler la boucle sans repartir de zéro
Enfin, ce qui distingue un pilotage continu d'une succession d'étapes isolées, c'est la capacité à revenir en arrière rapidement. Le crawl signale un problème, la correction se déploie via la plateforme sans dépendre du CMS ni d'un cycle de développement, et les données Search Console permettent de vérifier que le correctif a bien l'effet attendu. Les trois temps s'articulent au même endroit, plutôt que de se répartir entre plusieurs outils déconnectés.
Cette continuité change surtout la nature du travail post go-live. Au lieu d'attendre un rapport mensuel pour découvrir qu'une page a perdu ses positions, l'équipe dispose d'un fil de suivi continu pour agir en conséquence, de la préparation jusqu'aux semaines qui suivent le lancement.
Ce qu'il faut retenir
La difficulté d'une migration SEO ne se limite pas à la préparation, elle se joue tout autant dans le suivi des semaines qui suivent le go-live.
Un état des lieux technique complet, synthétisé par un score de santé SEO, permet de comparer l'avant et l'après mise en production.
Le déploiement des redirections et la correction des signaux SEO (meta, canonicals, hreflang, robots) se font indépendamment du CMS, sans attendre un cycle de développement.
Les données Search Console relient chaque correction déployée à son effet mesuré (clics, impressions, CTR, position moyenne), par URL et par requête.
La réussite d'une migration ne se joue donc pas dans une étape, mais dans la continuité entre les quatre : préparer, sécuriser, mesurer, corriger, au même endroit plutôt que réparties entre des outils déconnectés.
Le constat posé par les organisateurs est direct : le SEO d'hier ne suffit plus, et exister sur Google non plus. Il faut désormais être visible là où les IA répondent, citent et recommandent. C'est tout l'enjeu du GEO (Generative Engine Optimization), qui vient s'ajouter aux problématiques classiques de référencement naturel.
Pour cette édition 2026, les meilleurs experts SEO et GEO du marché viendront présenter des stratégies concrètes, des travaux de R&D et des méthodes inédites pour s'adapter à cette nouvelle donne.
Un nouveau décor et un format élargi
Après deux éditions organisées au Parc des Princes, le Summit change de décor et prend ses quartiers à Disneyland Paris, pour une expérience présentée comme plus immersive.
Le programme évolue également. Le SEO seul ne suffisant plus à couvrir les besoins des professionnels de l'acquisition, l'événement s'élargit à l'ensemble des leviers : SEA, social ads, contenu, marketing automation et CRM, pour une vision plus complète de l'acquisition digitale.
Autre changement notable, le Summit passe d'une à deux journées complètes de conférences et de rencontres, l'ampleur des sujets à traiter ne tenant plus en une seule journée.
Un programme multi-thématiques
Le programme, encore en cours d'élaboration, réunit déjà de nombreux intervenants autour du SEO, du GEO et des autres canaux d'acquisition. Voici un aperçu des conférences annoncées à ce jour :
10 questions à se poser avant d'investir en GEO, par Mikaël Priol
Les 7 canaux d'acquisition que toute entreprise devrait tester avant d'augmenter son budget média, par Maxence Rigottier
Canva x IA : le combo gagnant pour créer mieux et plus vite, par Mounir Moustahlaf
Comment manipuler facilement les LLMs (et générer plus de clients), par Alan CladX et Sylvain Montmory
Les risques de l'IA dans la désinformation et les fake news, par Romane Maltnoy
Exploiter Google Discover en tant que marque ou e-commerçant, par Sylvain Deauré
Du SEO à la diffusion multicanal, l'art d'être présent partout, par Dimitri Ageon
Comment et pourquoi déployer une stratégie de podcast, par Axel Thoreux
Comment optimiser votre stratégie LinkedIn en tant que marque, par Léo Garret
Google Ads et ChatGPT Ads pour la leadgen, par Alexandre Falck
Le copywriting SEO à l'ère de l'IA générative : reprendre la main sur la création éditoriale, par Syphaïwong Bay
Produire dix fois plus de créas : images et vidéos publicitaires par agents IA, par Maxence Tison
Les synergies SEO et GEO, par Mikaël Priol
Influence et génération de leads, par Jean-Baptiste Barat
Ma stratégie de visibilité organique, par Bilkher Diakhate
La prochaine évolution de l'AEO : façonner la manière dont l'IA parle de votre marque, par Louis Ktisti
Pourquoi l'IA recommande vos concurrents et pas vous, enquête sur un cas réel, par Olivier Duffez
Les relations presse et la brand, par Laurent Garrouste
Le netlinking à l'ère des IA Overviews, par Jacky Giang
La seule méthode SEO et GEO qui marche, prouvée par 14 ans de fausses révolutions, par Marvin Tranchant
Utiliser Reddit pour augmenter la visibilité des marques dans les LLMs, par Zohra Belmahdi
Les points d'entrée mémoriels : le KPI qui manque à votre reporting SEO pour peser auprès du CODIR, par Nelly Kempf
Comment retrouver la visibilité de 2020 sur LinkedIn, par Hervé Hoint-Lecoq
Analyse de la Spam Update Google du 21 août, par Mikaël Priol
D'autres conférences seront annoncées prochainement. Le programme, les jours et l'ordre de passage définitifs seront fixés quelques semaines avant l'événement.
Depuis 2017, du Grand Rex au Parc des Princes, les organisateurs affirment que les participants repartent avec des techniques et compétences qui n'étaient pas encore diffusées dans l'écosystème digital au moment de l'événement.
Selon les organisateurs, 2026 marque un tournant pour le référencement, avec des règles du jeu et des algorithmes en pleine réinvention. Moteurs de recherche, IA générative, réseaux sociaux, publicité en ligne, contenu vidéo, influence marketing, emailing, data et automatisation : chaque canal d'acquisition traverse ses propres évolutions.
Les organisateurs de l'événement
Le SEO & GEO Summit 2026 est porté par trois organisateurs issus de l'écosystème SEO et digital français.
Elliott Bobiet, expert SEO fort de 17 ans d'expérience, est spécialisé en SEO on-site, SEO off-site et optimisation des performances web. Il anime la newsletter, le podcast, les lives YouTube et le média L'Écosystème SEO, et intervient notamment à Masterclass SEO et au Séminaire SEO. Il est également ambassadeur de l'outil Yooda.
Alexandre Machado est spécialisé en intelligence artificielle, automatisation et no-code. Développeur et ingénieur industriel de formation, il dirige la Content Factory Contenu.fr et a cofondé la plateforme ContentRank.
Mikaël Priol, entrepreneur et expert SEO depuis plus de 15 ans, dirige le groupe Internet Factory, qui réunit notamment SEO.fr, Netlinking.fr, Netlinking.com et Yooda.
Les tarifs du SEO & GEO Summit 2026
Trois formules sont proposées pour assister au SEO & GEO Summit 2026, avec un tarif préférentiel jusqu'au 1er octobre.
Le Pass 1 Jour est à 225 euros HT jusqu'au 1er octobre, puis 250 euros HT. Il donne accès au programme élargi à l'acquisition et à une journée de conférences exclusives.
Le Pass 2 Jours est à 450 euros HT jusqu'au 1er octobre, puis 500 euros HT. Il permet de suivre l'intégralité des deux jours de conférences et donne accès à des tarifs d'hébergement exclusifs, avec une réduction de 50 %.
Le Pass VIP est à 1900 euros HT jusqu'au 1er octobre, puis 2000 euros HT. Il inclut les repas, les soirées et des temps de mise en relation, ainsi qu'un accès backstage et au cercle des décideurs.
Le SEO & GEO Summit 2026 se déroule à Disneyland Paris. Toutes les informations sur l'événement sont disponibles sur seo-summit.com, où il est également possible de réserver sa place.
ChatGPT Ads atteint 1 milliard de dollars de revenus annualisés en moins de 200 jours d'existence, avec des dizaines de milliers d'annonceurs actifs.
L'accès en libre-service via Ads Manager s'étend désormais à l'Inde, l'Europe, le Moyen-Orient et l'Afrique du Nord.
Les publicités sont clairement identifiées, séparées des réponses de ChatGPT, et n'influencent pas le contenu généré ; les annonceurs n'ont pas accès aux conversations privées des utilisateurs.
Le ciblage s'appuie sur le contexte de la conversation en cours et, selon les paramètres et le pays, sur les centres d'intérêt plus larges de l'utilisateur.
Une croissance rapide portée par la publicité
OpenAI présente la publicité comme l'un des piliers de son modèle économique, aux côtés des abonnements grand public, des offres entreprises et des API facturées à l'usage. Cette diversification permet de maintenir un accès gratuit à ChatGPT, soutenu par la publicité, pour une base qui dépasse le milliard d'utilisateurs actifs hebdomadaires.
Le principe de fonctionnement repose sur les moments où les utilisateurs prennent des décisions dans ChatGPT : choisir un logiciel, apprendre une langue, planifier des travaux, chercher un emploi ou explorer un nouveau loisir.
Selon OpenAI, ces échanges permettent aux annonceurs d'apporter des informations pertinentes directement dans le fil de la conversation, l'outil s'appuyant sur le contexte immédiat de l'échange pour afficher une publicité en lien avec ce que la personne recherche.
Des règles de transparence mises en avant
OpenAI insiste sur le respect de ce qu'elle appelle ses "principes publicitaires". Les annonces restent toujours signalées comme telles et distinctes des réponses générées par le modèle. La société affirme aussi que la publicité n'a aucune influence sur le contenu des réponses fournies par ChatGPT, et que les annonceurs ne reçoivent pas accès aux conversations privées des utilisateurs, qui gardent la main sur le niveau de personnalisation de leur expérience publicitaire.
D'après OpenAI, les indicateurs suivis en matière de confiance, de pertinence et d'expérience globale sont restés stables tout au long du déploiement international, ce qui a motivé la poursuite de l'expansion.
Un déploiement mondial et un écosystème élargi
Les publicités ChatGPT sont désormais disponibles dans plus de 40 pays, via l'équipe OpenAI Ads Solutions ainsi que des partenaires agences et technologiques. À partir d'aujourd'hui, l'accès en libre-service s'ouvre également en Inde, en Europe, au Moyen-Orient et en Afrique du Nord.
La base d'annonceurs internationaux progresse : les clients situés hors des États-Unis représentent une part croissante des revenus, et plusieurs des plus gros clients utilisent désormais ChatGPT Ads pour toucher des audiences sur plusieurs marchés à la fois. L'écosystème de partenaires technologiques et de mesure dépasse aujourd'hui les 50 entités, contre un modèle initialement centré sur la vente gérée et les agences.
Le lancement d'Ads Manager en mai a ouvert la plateforme aux petites et moyennes entreprises, qui représentent désormais une part significative de l'activité. OpenAI met en avant cette ouverture comme un moyen de donner accès à la publicité à des entreprises de toutes tailles.
Des outils publicitaires plus sophistiqués
La plateforme a gagné en maturité technique. La majorité des campagnes utilise désormais des enchères au coût par clic ou optimisées sur les résultats. Le pixel de suivi et l'API Conversions sont devenus des briques essentielles pour la mesure et l'optimisation des campagnes. Des fonctionnalités comme les flux produits, le ciblage géographique et par plateforme, ainsi que les audiences personnalisées, permettent aux annonceurs d'affiner leur portée.
OpenAI cite des résultats concrets pour illustrer ces progrès : un annonceur e-commerce a obtenu un retour sur investissement publicitaire multiplié par 3 sur ses campagnes en 28 jours, tandis qu'un partenaire technologique rapporte que plus de 80 % du trafic généré par les publicités ChatGPT provient de nouveaux clients.
Les prochaines étapes annoncées
OpenAI indique vouloir poursuivre l'expansion vers de nouveaux marchés et introduire de nouveaux formats publicitaires, objectifs de campagne, options d'achat et outils de mesure. L'entreprise évoque aussi de nouvelles façons pour les entreprises d'interagir avec les utilisateurs de manière plus intégrée dans ChatGPT. Les entreprises intéressées peuvent s'inscrire sur ads.openai.com.
Googlebot n'applique désormais qu'une seule passe de déséchappement HTML sur le JSON-LD, contre plusieurs passes auparavant.
Les entités doublement échappées, comme & ou ✔, ne seront plus « déroulées » automatiquement et risquent de casser le parsing.
Google recommande de basculer vers les échappements JSON standards ou les échappements Unicode hexadécimaux, comme \u0026.
Gary Illyes, de Google, renvoie vers la RFC 8259 (section 7) pour la définition exacte de l'échappement JSON correct.
Google a annoncé ce changement via un post publié sur LinkedIn par son compte Search Central : l'équipe explique avoir modifié l'extraction du JSON-LD « pour mettre notre parseur en conformité avec JSON et les autres standards ». Concrètement, Googlebot ne fait plus qu'une seule passe de désérialisation des entités HTML lorsqu'il lit vos balises script type="application/ld+json", alors qu'il en appliquait plusieurs jusqu'ici, ce qui masquait certaines erreurs de code.
Fin de la tolérance chez Google
Cette tolérance touche à sa fin. Jusqu'à présent, si votre CMS ou votre système de templating générait par erreur un double échappement, comme &amp; au lieu d'un simple &, Googlebot corrigeait le tir en appliquant plusieurs passes de déséchappement. Ce n'est plus le cas. Une entité doublement échappée reste désormais telle quelle dans la chaîne de caractères, ce qui peut invalider le JSON et empêcher Google d'exploiter vos données structurées, donc vos rich results (avis, prix produits, recettes, FAQ, etc.).
Gary Illyes, de Google, a complété l'annonce en rappelant que l'échappement correct en JSON est précisément défini par la RFC 8259, dans sa section 7. Ce standard décrit noir sur blanc les séquences d'échappement autorisées, dont les échappements Unicode hexadécimaux du type \u0026 pour représenter le caractère &.
Pour les éditeurs et développeurs qui génèrent du JSON-LD dynamiquement (via des CMS, des plugins SEO ou des scripts maison), l'enjeu est donc de vérifier que leur code produit un échappement simple et conforme au standard JSON, et non un échappement HTML redondant hérité d'un traitement en plusieurs étapes. Un bon réflexe consiste à valider ses balises JSON-LD avec un outil comme le Rich Results Test de Google ou un validateur JSON strict, pour repérer d'éventuelles entités mal formées avant qu'elles ne posent problème en production.
Dès le 24 août 2026, une vue sera comptée à la première frame de lecture, pour tous les formats (vidéos longues, Shorts, lives), au lieu des 30 secondes de visionnage auparavant requises pour les vidéos classiques.
Les compteurs publics vont augmenter plus rapidement, mais un nouveau métrique baptisé "vues engagées" restera disponible dans YouTube Analytics (mode avancé) pour suivre le visionnage réel.
La monétisation et l'éligibilité au Programme Partenaire YouTube ne changent pas : elles continueront de reposer sur les "Engaged Watch Hours " et les "Engaged Shorts views ", désormais aussi appelées "qualified Shorts views" et "qualified Watch Hours".
Avec ce changement, YouTube rejoint TikTok et Instagram, qui comptent déjà une vue dès le lancement de la lecture.
Un système de comptage à deux vitesses jusqu'ici
Jusqu'à présent, YouTube faisait cohabiter deux logiques de comptage bien différentes. Les Shorts enregistraient une vue dès que la lecture démarrait, tandis que les vidéos plus longues nécessitaient environ 30 secondes de visionnage avant que le compteur ne bouge. Cette différence de traitement créait une forme de confusion chez les créateurs, qui avaient du mal à comparer la performance réelle d'un Short et d'une vidéo classique traitant du même sujet, les chiffres pouvant varier fortement pour une audience pourtant comparable.
YouTube a donc choisi d'harmoniser les règles en retenant la méthode la plus généreuse : celle qui compte une vue dès la première frame. Cette règle s'appliquera à tous les formats, y compris les diffusions en direct.
Pourquoi ce changement maintenant
YouTube justifie cette évolution par une volonté de cohérence entre les formats et de clarté pour les créateurs, afin qu'ils puissent mieux évaluer leur exposition réelle sur la plateforme. Mais le contexte concurrentiel joue clairement un rôle.
TikTok et Instagram utilisent déjà ce mode de comptage depuis des années, ce qui leur permet d'afficher des chiffres de vues nettement supérieurs à ceux de YouTube pour un visionnage comparable. X, de son côté, applique un seuil de deux secondes, une option que YouTube n'a pas retenue.
En basculant sur la règle la plus permissive du marché, YouTube aligne ses statistiques publiques sur celles de ses principaux concurrents. Les créateurs pourront ainsi mettre en avant des compteurs de vues plus élevés auprès des marques et des sponsors, sans que cela ne reflète nécessairement une hausse réelle de leur audience engagée.
Aucun impact sur la monétisation
YouTube est clair sur ce point : ce changement ne touche que l'affichage public des vues, pas les revenus des créateurs. La rémunération continuera de se baser sur les "Engaged Watch Hours" et les "Engaged Shorts views", des métriques disponibles dans YouTube Analytics en mode avancé.
L'éligibilité au Programme Partenaire YouTube (YPP) n'est pas non plus modifiée. Les seuils d'entrée existants restent les mêmes, mais changent de nom : les "valid public Shorts views" et "valid public watch hours" deviennent respectivement les "qualified Shorts views" et "qualified watch hours".
Une donnée à interpréter avec prudence
Avec la lecture automatique activée par défaut sur de nombreuses interfaces, notamment le fil d'accueil et les recommandations, le nouveau mode de comptage pourrait faire grimper les vues publiques de façon spectaculaire, sans que cela corresponde à une audience réellement attentive. YouTube n'a pas encore communiqué sur la manière dont cette situation sera gérée ni sur d'éventuels ajustements à venir. C'est un point que les créateurs et les marques devront surveiller de près dans les semaines suivant le lancement, le 24 août.
31 marchés européens concernés dès le 24 août 2026, parmi lesquels la France, l'Allemagne, l'Espagne, l'Italie, la Suède, la Norvège, le Danemark, les Pays-Bas et l'Autriche.
L'accès se fait dans un premier temps via des intermédiaires : l'équipe Ads Solutions d'OpenAI, des agences partenaires et des partenaires technologiques. Le libre-service par Ads Manager n'arrivera que plus tard dans le trimestre.
Seuls les utilisateurs des offres Free et Go verront des publicités. Les abonnés Plus, Pro et Enterprise conservent une expérience sans publicité.
Les publicités sont clairement identifiées et séparées des réponses de ChatGPT, et OpenAI affirme qu'elles n'influencent pas le contenu généré par l'IA.
Un lancement pensé pour capter les décisions d'achat
Dans sa communication officielle, OpenAI justifie cette expansion par la nature même des usages observés sur ChatGPT. Les utilisateurs ne tapent plus de simples mots-clés comme sur un moteur de recherche classique : ils décrivent un objectif, un projet, des contraintes précises. Préparer un voyage, choisir un logiciel professionnel, meubler un appartement ou se lancer dans un nouveau loisir font partie des exemples cités par l'entreprise.
Pour OpenAI, ChatGPT est ainsi devenu un espace où les décisions se construisent progressivement, ce qui en fait un terrain particulièrement intéressant pour les annonceurs. L'objectif affiché est de permettre aux marques d'intervenir à différentes étapes du parcours client, au moment où les utilisateurs comparent leurs options et s'apprêtent à trancher.
Un modèle économique qui protège les abonnés payants
Point important pour les utilisateurs de ChatGPT : les publicités ne toucheront que les comptes gratuits (Free) et l'offre Go. Les formules payantes, Plus, Pro et Enterprise, resteront sans publicité. Cette répartition suggère qu'OpenAI utilise la publicité comme un levier pour financer l'accès gratuit ou peu coûteux à son service, plutôt que comme une source de revenus généralisée à l'ensemble de sa base d'utilisateurs.
Une plateforme construite étape par étape depuis février
Le lancement européen ne sort pas de nulle part. OpenAI rappelle avoir commencé à tester la publicité dans ChatGPT en février, avec un projet pilote limité aux États-Unis. Au fil des six derniers mois, l'entreprise a progressivement étendu le dispositif à huit marchés supplémentaires avant d'annoncer cette arrivée massive en Europe.
En parallèle, l'infrastructure publicitaire elle-même s'est étoffée :
Le système d'enchères a démarré au CPM, avant l'ajout du CPC, puis du CPC optimisé pour les conversions (oCPC), permettant aux annonceurs d'aligner leurs campagnes sur leurs objectifs commerciaux réels.
Le ciblage géographique et les audiences personnalisées ont été intégrés pour aider les entreprises à toucher les profils les plus pertinents.
Le suivi des performances a été enrichi au-delà du simple clic, avec le lancement d'OpenAI Pixel, d'une API Conversions et d'intégrations de mesure avec des outils tiers, donnant aux annonceurs une vision plus complète de l'impact réel de leurs campagnes.
OpenAI indique que des dizaines de milliers d'annonceurs ont déjà utilisé ChatGPT pour développer leur activité depuis le lancement du pilote. L'inscription pour les entreprises intéressées se fait sur ads.openai.com.
L’entreprise a publié une fiche de poste pour un ingénieur senior dans son équipe « Discover Ranking », l’équipe qui fabrique le classement de votre flux. Parmi les prérequis, une ligne retient l’attention : le candidat doit savoir construire et déployer des « modèles de systèmes de recommandation (retrieval, prediction, ranking, embedding) en production ».
L’offre « Staff Software Engineer, Discover Ranking » sur Google Careers. La quatrième ligne des prérequis nomme les briques du système. Surlignage ajouté par nos soins.
Quatre mots techniques, qui décrivent la chaîne complète d’un système de recommandation : sélectionner des contenus candidats, prédire ce que chaque lecteur va en faire, les classer, et représenter lecteurs et contenus sous une forme que la machine sait comparer.
Une offre d’emploi décrit des compétences recherchées, rien de plus. Sa valeur vient du recoupement : chez 1492.vision, nous observons de vrais flux Discover depuis deux ans, et ces mots recoupent très exactement ce que nous voyons passer. Voici trois exemples concrets, racontés simplement ; l’analyse complète, chiffres et graphiques à l’appui, est dans notre étude de référence (disponible en français et en anglais).
Chaque carte de votre flux porte des prédictions
Commençons par le mot « prediction ». Chaque carte qui s’affiche dans un flux Discover a été évaluée par des modèles qui prédisent le comportement du lecteur : va-t-il s’arrêter dessus ? Cliquer ? Lire en profondeur ?
Ces prédictions laissent des traces bien concrètes : des scores, que nous observons sur les cartes de nos panels de test. Et elles se résument à deux questions étonnamment indépendantes :
Cette carte va-t-elle arrêter l’œil ? C’est une propriété de l’article : son titre, son image. Elle varie peu d’un lecteur à l’autre.
Ce lecteur précis va-t-il s’engager ? Cliquer, lire longtemps, interagir. Celle-ci dépend énormément de chaque lecteur.
Les deux peuvent diverger complètement, et c’est toute la définition du clickbait : un titre qui arrête l’œil de tout le monde et ne retient personne. À l’inverse, un contenu de niche peut engager profondément ses lecteurs sans jamais accrocher la majorité.
Dans nos mesures, ces prédictions collent au comportement réel observé ensuite sur le panel : quand le score d’engagement prédit est haut, l’interaction constatée est environ deux fois plus forte que quand il est bas.
L’affinité change tout, à contenu égal
La personnalisation se raconte en deux exemples.
Premier exemple. Sur nos comptes de test, nous avons comparé deux éditeurs de sport, sur la même thématique, face aux mêmes comptes. Le potentiel de leurs sujets, tel que le système lui-même l’évalue, était du même ordre. Résultat : pour l’un des deux, les prédictions d’engagement étaient environ 2 fois plus élevées, et la visibilité finale dans les flux environ 8 fois plus forte, à sujet comparable.
Le détail qui surprend : l’éditeur dominant est celui que nos comptes de test suivent le moins, au sens du bouton « Suivre » de Google. Ce qui fait la différence, c’est l’affinité que ces lecteurs ont déjà installée avec la source : un historique de lectures, d’interactions, de rendez-vous pris. Le modèle a appris que ces lecteurs précis s’engagent avec cette source, et il le prédit.
Deuxième exemple, pour situer le rôle du bouton « Suivre ». Pour un même éditeur tech, à sujets égaux, les comptes qui le suivent obtiennent des prédictions d’engagement presque doublées par rapport aux comptes qui ne le suivent pas, et une visibilité un peu plus forte. Suivre compte, comme un signal parmi d’autres qui nourrit l’affinité. L’affinité, elle, fait la décision.
D’où une boucle qui s’auto-renforce, lecteur par lecteur : un lecteur découvre une source et s’y engage ; cette affinité s’installe dans les modèles ; la source devient plus visible dans son flux ; il s’y engage davantage. La boucle favorise structurellement les sources qui ont su créer une relation avec leurs lecteurs, et la fidélisation devient un levier direct de visibilité Discover, mesurable dans les prédictions elles-mêmes.
La boucle d’affinité se renforce lecteur par lecteur. Schéma, mécanisme interprété à partir de nos observations.
Un lecteur, plusieurs profils
Dernier mot de la liste : « embedding ». Derrière ce terme, une idée simple : pour vous recommander des contenus, la machine vous représente sous forme de coordonnées, et recommande ce qui est « proche » de vous.
Nos observations suggèrent que Google maintient plusieurs profils de vous en parallèle, plutôt qu’un seul : vos intérêts de fond, vos curiosités du moment, ce qui est en tendance autour de vous, et même un profil orienté achats. Votre flux du matin est le point de rencontre de ces différentes versions de vous.
C’est cohérent avec ce que tout utilisateur de Discover constate : le flux mélange vos passions stables, l’actu chaude et des essais parfois surprenants. Derrière ce qui ressemble à des sautes d’humeur de l’algorithme, il y a une architecture.
Ce qu’il faut en retenir
L’offre d’emploi valide un vocabulaire ; nos observations montrent la machinerie au travail. Pour un éditeur, trois conséquences :
À contenu comparable, l’affinité installée entre vos lecteurs et votre marque pilote la visibilité. Fidéliser (faire revenir, faire interagir, faire suivre) est un levier Discover à part entière, au même titre que le travail éditorial, et dans nos tests il pèse davantage que le seul bouton « Suivre ».
Capter l’attention et créer de l’engagement sont deux chantiers distincts, qui se mesurent et se travaillent séparément.
L’engagement n’est que la moitié de l’histoire : l’offre parle de contenu « engaging, and useful », et la satisfaction du lecteur est portée par d’autres signaux. Optimiser le clic seul est une stratégie à courte vue.
Google a nommé publiquement les briques de sa machine à recommander. Nous, de l’extérieur, nous continuons à mesurer ce qu’elles font, carte après carte. L’analyse complète est ici.
Méthodologie : observations issues d’un panel de comptes de test sur de vrais flux Discover ; « suivre » s’entend au sens du bouton « Suivre » de Google, mesuré sur ce panel ; les deux cas éditeurs sont des illustrations sur de petits échantillons. Méthode complète, chiffres et graphiques : l’étude complète.
Damien Andell, co-fondateur de 1492.vision. Observations issues de l’analyse de vrais flux Google Discover ; les mécanismes décrits sont nos interprétations, pas des confirmations de Google.
Un projet e-commerce B2B coûte structurellement plus cher qu'un site B2C classique, en raison de la complexité métier et des intégrations obligatoires.
Les budgets observés vont de quelques milliers d'euros pour une solution simple à plus de 150 000 € pour un projet sur-mesure avec catalogue volumineux et intégration ERP poussée.
Des solutions modulaires pensées nativement pour le B2B, comme BaseCart développée par l'agence Vigicorp, permettent de réduire le temps de développement par rapport à un projet 100 % sur-mesure.
Le nombre de comptes clients, la taille du catalogue, la profondeur de l'intégration ERP et le niveau d'automatisation des workflows sont les principaux critères qui font varier la facture.
Anticiper les postes de migration de données et de formation des équipes évite les mauvaises surprises budgétaires après la mise en ligne.
Pourquoi le e-commerce B2B coûte plus cher que le B2C
Si un site B2C commercialise un produit au même prix pour tout le monde, un site B2B doit gérer des comptes entreprise avec des grilles tarifaires personnalisées, des catalogues parfois confidentiels selon le client, des commandes en gros et des cycles de validation impliquant plusieurs interlocuteurs (acheteur, décideur, utilisateur final). Cette complexité métier se traduit mécaniquement par plus de développement spécifique, donc un budget plus élevé.
L'autre différence structurante est l'intégration aux systèmes existants. Un projet B2B part rarement d'une page blanche. Il doit se connecter à un ERP, parfois à un CRM et à un PIM, pour synchroniser stocks, tarifs et données produits. Cette brique technique est un facteur de coût supplémentaire que les projets B2C n'ont, la plupart du temps, pas besoin de budgéter avec la même ampleur.
Une solution pensée nativement pour le B2B : l'exemple de Vigicorp
Face à ce constat, certaines agences ont choisi de construire leur propre socle technique plutôt que d'adapter une plateforme généraliste à chaque nouveau projet. C'est le parti pris de l'agence nantaise Vigicorp, qui a développé BaseCart, sa solution ecommerce btob en interne.
Concrètement, BaseCart combine la robustesse d'un développement sur Symfony avec la rapidité de déploiement d'un socle déjà configuré pour les besoins spécifiques du B2B : gestion des comptes entreprise, catalogues privés, grilles tarifaires personnalisées, validation des commandes et devis.
L'architecture est modulaire, ce qui permet de n'activer que les fonctionnalités nécessaires au démarrage, puis d'ajouter des modules à mesure que l'activité évolue. L'intégration avec l'ERP, le CRM ou les outils comptables fait partie du socle, plutôt que d'être développée à chaque fois de zéro.
L'intérêt budgétaire de cette approche : partir d'un socle déjà pensé pour les enjeux du B2B réduit le temps de développement et le time-to-market par rapport à un projet 100 % sur-mesure, sans sacrifier la possibilité de personnaliser la plateforme selon le secteur d'activité et le modèle commercial de l'entreprise. Pour les projets aux exigences techniques encore plus poussées, Vigicorp propose également un développement entièrement sur-mesure en Symfony, notamment pour les logiques de tarification très spécifiques ou la gestion logistique multi-entrepôts.
Les grandes fourchettes de budget selon le type de projet
Les budgets constatés sur le marché français varient fortement selon l'approche retenue. Une agence web française facture en moyenne entre 5 000 € et 12 000 € un site e-commerce simple, mais ce type de tarif correspond rarement aux besoins réels d'un projet B2B avec tarification personnalisée. Sur un échantillon de projets réels, le budget médian d'un développement e-commerce sur-mesure sans CMS no-code atteint environ 45 000 € et pour les gros catalogues B2B multi-sites, la médiane dépasse 75 000 €, avec un troisième quartile qui grimpe au-delà de 185 000 €
D'autres retours de terrain vont dans le même sens. Un site B2B connecté à un ERP, gérant plusieurs milliers de références et une dimension multi-pays, n'a rien de comparable en termes de budget avec une boutique Shopify basique, avec des écarts qui peuvent aller de 1 à 50 selon le périmètre. On peut résumer ces ordres de grandeur en trois familles de projets :
Solution B2B « sur étagère » adaptée : quelques milliers à environ 20 000 €, pour un catalogue limité et des besoins d'intégration réduits.
Solution B2B modulaire pré-construite (à l'image de BaseCart) : généralement entre 20 000 € et 60 000 €, selon le niveau de personnalisation et le nombre de modules activés.
Développement 100 % sur-mesure : à partir de 45 000 € et souvent au-delà de 100 000 € pour les catalogues volumineux, le multi-sites ou les intégrations ERP complexes.
Ces chiffres restent évidemment des ordres de grandeur : chaque agence fixe ses propres tarifs, et le périmètre exact du projet reste le facteur déterminant.
Les postes de coûts à budgéter
Un budget e-commerce B2B complet doit couvrir plusieurs postes, souvent sous-estimés au moment du premier devis :
Conception et UX : parcours d'achat professionnel, arborescence du catalogue, gestion des comptes multi-utilisateurs.
Développement front et back : l'essentiel de l'enveloppe pour un projet sur-mesure ou semi-sur-mesure.
Intégration ERP, CRM et PIM : synchronisation des stocks, des tarifs et des fiches produits.
Migration des données existantes : reprise du catalogue, des comptes clients et de l'historique de commandes.
Formation des équipes internes : back-office, gestion des tarifs, suivi des commandes.
Maintenance, hébergement et évolutions : un poste récurrent qui se prolonge après la mise en ligne.
Cette liste rejoint un constat largement partagé sur le marché : les postes les plus souvent oubliés dans un budget e-commerce sont l'intégration aux outils de gestion existants, la préparation des données produits et la formation des équipes, alors même qu'un site techniquement abouti, mais mal pris en main en interne ne produira jamais les résultats attendus.
Les critères qui font varier les budgets
Plusieurs facteurs expliquent pourquoi deux projets B2B, en apparence similaires, peuvent afficher des devis très différents :
Le nombre de clients à gérer : plus les comptes nécessitent des grilles tarifaires ou des catalogues individualisés, plus le développement se complexifie.
La taille et la structure du catalogue : nombre de références, variantes, disponibilité différenciée selon les clients.
La profondeur de l'intégration ERP : une synchronisation en temps réel coûte nettement plus cher qu'un import périodique.
Le multilingue, le multi-devises et le multi-sites : chaque déclinaison ajoute de la complexité technique et de la maintenance.
Le niveau d'automatisation des workflows de commande : validation interne, devis automatisés, gestion des commandes en gros.
Les domaines très exposés aux AI Overviews (plus de 20 % de leurs requêtes concernées) perdent 23,1 % de CTR en neuf jours, un chiffre qui monte à −24,8 % une fois neutralisée l'évolution du groupe témoin (+2,3 % sur la même période)
82,2 % des domaines très exposés perdent du CTR
À la médiane, sur l'ensemble du panel de 963 domaines, la baisse est de 5,7 % de CTR et 8,8 % de clics
Près de la moitié des domaines du panel (48 %) ont perdu plus de 10 % de leurs clics, et 5 % en ont perdu plus de la moitié
Les domaines en .fr sont plus touchés (−12,3 % de clics) que la moyenne du panel (−8,8 %)
La santé est le secteur le plus exposé (taux d'AI Overview de 22,2 %) et le plus touché (−20,4 % de CTR)
Selon l'étude mondiale d'Ahrefs, la baisse de CTR en position 1 sur les requêtes avec AI Overview est passée de −34,5 % au printemps 2025 à −58 % fin 2025
Ce que montre l'étude
Dans une nouvelle étude publiée hier, Ahrefs a comparé deux populations de domaines pour isoler ce qui relève spécifiquement des AI Overviews d'une simple variation saisonnière.
Les domaines très exposés, c'est-à-dire ceux dont plus de 20 % des requêtes déclenchent un AI Overview, enregistrent une baisse moyenne de CTR de 23,1 % en neuf jours. Sur ce même groupe, 82,2 % des domaines perdent du CTR : à ce niveau d'exposition, s'en sortir est devenu l'exception plutôt que la règle.
Le groupe témoin, composé de domaines dont moins de 2 % des requêtes déclenchent un AI Overview, sert de point de comparaison. Sur la même période, son CTR progresse de 2,3 %. Ahrefs précise que le −23,1 % du groupe très exposé est calculé sans retrait de cette évolution du témoin : une fois cette hausse prise en compte, l'effet réel attribuable aux AI Overviews atteint −24,8 %.
Autrement dit, les domaines très exposés n'ont pas seulement perdu 23 % de CTR, ils ont aussi raté la légère hausse dont le reste du marché a profité sur la même période.
Une relation à peu près linéaire entre exposition et perte de CTR
En comparant la variation du taux de clics au taux d'AI Overview sur l'ensemble des domaines étudiés, Ahrefs obtient une pente de −0,9 : chaque point de taux d'AI Overview supplémentaire coûterait environ un point de CTR.
Ahrefs formule cet ordre de grandeur comme un repère opérationnel, pas comme une prédiction. L'étude précise elle-même qu'une pente n'est pas une prédiction, que certains sites très exposés s'en sortent, et que d'autres, peu exposés, reculent pour des raisons sans rapport avec l'IA.
Les impressions montent, les clics tombent
Selon Ahrefs, il y a eu peu de perte de positions dans les SERP fin juillet. Les pages continuent de s'afficher aussi souvent qu'avant, parfois davantage, mais elles sont moins cliquées. Le cas le plus marqué du panel affiche +183 % d'impressions pour −1,9 % de clics, soit un CTR divisé par plus de trois.
Les chiffres à la médiane sur l'ensemble du panel
Sur l'ensemble des 963 domaines retenus dans l'étude, et non plus seulement sur le groupe très exposé, la médiane du panel affiche une baisse de 5,7 % de CTR et de 8,8 % de clics.
La répartition des pertes de clics sur ce panel est la suivante :
48 % des domaines ont perdu plus de 10 % de leurs clics
19 % en ont perdu plus de 30 %
5 % en ont perdu plus de 50 %
Presque un site sur deux a donc perdu plus de 10 % de ses clics quotidiens, et un sur vingt en a perdu la moitié, en seulement neuf jours.
Ahrefs signale par ailleurs que l'exposition va probablement continuer de progresser : le taux d'AI Overview médian des sites étudiés est aujourd'hui de 5,4 %, et 29 % d'entre eux dépassent déjà 10 %. Ces taux ont augmenté sur tous les marchés depuis 2024, selon l'étude.
Les .fr plus touchés que la moyenne
Les domaines en .fr du panel perdent 12,3 % de clics en médiane, contre 8,8 % pour l'ensemble des sites étudiés. Ahrefs avance une explication : les sites français seraient plus exposés aux AI Overviews que les acteurs internationaux présents sur le marché français.
Le secteur santé, le plus touché
Un secteur se détache nettement dans l'étude : la santé, avec un taux d'AI Overview de 22,2 %, le plus élevé relevé, et une baisse de CTR de 20,4 %.
Ahrefs explique ce résultat par la nature des requêtes santé, majoritairement informationnelles et à réponse courte, c'est-à-dire le type de requête que l'AI Overview absorbe le mieux : la réponse tient dans l'encart et l'utilisateur repart sans avoir besoin de cliquer. Pour Ahrefs, ce qui détermine l'exposition au risque n'est donc pas tant la verticale que l'intention derrière les requêtes : une requête à laquelle un paragraphe suffit est une requête à risque, tandis qu'une requête qui suppose un outil, un compte, un prix, un achat ou un avis humain résiste mieux.
Une trajectoire qui pourrait s'aggraver
L'étude situe ces résultats français dans une trajectoire plus large observée à l'échelle mondiale. Sur cette étude mondiale, l'impact des AI Overviews sur le CTR de la position 1 est passé de −34,5 % au printemps 2025 à −58 % fin 2025. Selon Ahrefs, l'effet ne s'atténue pas avec le temps : il s'accentue, à mesure que l'AI Overview se déclenche sur davantage de requêtes et que les utilisateurs prennent l'habitude de moins cliquer.
Ahrefs indique vouloir relancer cette analyse sur une fenêtre plus longue pour suivre l'évolution du marché français, sans affirmer à ce stade qu'il suivra la même trajectoire que le marché mondial.
Des ordres de grandeur cohérents avec d'autres études
Ahrefs rapproche ses résultats de mesures publiées par d'autres acteurs sur l'effet des AI Overviews sur le CTR organique : une baisse de 49,4 % à 65,2 % relevée par Seer Interactive, une baisse supérieure à 50 % selon Kevin Indig, et une baisse de 47,5 % selon Authoritas.
Méthodologie de l'étude
Ahrefs a suivi les 1 000 domaines générant le plus de clics en France entre avril et juillet 2026, via des données agrégées de Google Search Console. Les domaines dont l'historique ne couvrait pas l'intégralité de la période ont été écartés, ce qui ramène le panel final à 963 domaines.
Pour chaque domaine, Ahrefs a calculé la moyenne quotidienne de clics, d'impressions et de CTR sur les 28 jours précédant le 22 juillet 2026, puis sur les 9 jours suivant cette date.
Ahrefs a également mesuré le taux d'AI Overview de chaque domaine, c'est-à-dire la part de ses requêtes France qui déclenchent un AI Overview. Cette donnée sert à répartir les domaines entre le groupe très exposé (plus de 20 % de requêtes concernées) et le groupe témoin (moins de 2 %), afin d'isoler l'effet propre aux AI Overviews de l'évolution générale du CTR sur la période, saisonnalité de fin juillet comprise.
L'étude précise que le chiffre de −23,1 % de CTR médian pour le groupe très exposé est la variation brute observée, sans retrait de l'évolution du groupe témoin. Sur la même période, le CTR du groupe témoin progresse de 2,3 %. En intégrant cet écart, l'effet réel attribué aux AI Overviews est estimé à −24,8 %.
Comment déployer un agent de données dans Data Studio ? [Partie 1]
Par Chloé Nieuwjaer, Consultante SEO Senior, Data Analyste & Formatrice Freelance
À découvrir dans cette première partie :
Le Conversational Analytics, ce nouveau chat intégré à Data Studio qui permet d'interroger ses données stockées dans BigQuery en langage naturel, sans écrire une seule ligne de SQL.
Ce que contient réellement une réponse de l'agent : pas juste un résultat brut, mais un raisonnement affichable, une contextualisation en langage naturel, une mini-analyse et des suggestions de questions complémentaires.
Une comparaison concrète et détaillée entre une requête SQL écrite à la main et le raisonnement complet de l'agent pour arriver au même résultat, avec le détail de sa chaîne de pensée sur un cas réel (les villes du département du Nord).
Un piège de données bien réel révélé au passage : comment une simple requête peut confondre deux villes homonymes situées à l'autre bout de la France.
Les prérequis techniques à avoir en tête avant de se lancer : compte Google d'entreprise, projet Google Cloud, BigQuery, et les API à activer.
Ce qu'on a aimé : Une présentation qui va au-delà du simple mode d'emploi et documente vraiment ce qu'il se passe "sous le capot" : le raisonnement complet de l'agent, en anglais et non retouché, permet de voir précisément comment il interprète le schéma de données, formule ses hypothèses et anticipe les biais avant même d'exécuter sa requête. Chloé Nieuwjaer illustre son propos avec un vrai jeu de données (les mots-clés liés au trail en France), ce qui rend la démonstration concrète plutôt que théorique. On attend avec intérêt la suite, qui promet un tutoriel de configuration complet et un regard critique sur les limites de l'outil.
Les chiffres qui placent Reddit au 4ème rang mondial des sites les plus visités, et pourquoi le marché francophone reste encore largement vierge comparé aux États-Unis.
Pourquoi la mise à jour Google de 2023, en privilégiant les discussions humaines authentiques face à la prolifération de contenus IA, a fait de Reddit l'un des premiers bénéficiaires sur les requêtes à forte intention d'achat.
Le rôle central que jouent les threads Reddit dans les réponses des IA génératives, et pourquoi ça change la donne pour les marques présentes sur la plateforme.
La méthode concrète pour construire un compte crédible sans se faire bannir : karma, cartographie des bons subreddits, et le délai à respecter avant toute action promotionnelle.
Les pièges qui trahissent instantanément un contenu promotionnel déguisé, et pourquoi un ton "trop soigné" est justement ce qui vous fait repérer par la communauté.
Ce qu'on a aimé : Un article qui vient d'un vrai praticien du sujet, avec des chiffres concrets tirés de l'expérience terrain de l'agence Skilfut (une communauté de 4 000 membres générant plus de 50 000 impressions hebdomadaires, par exemple). César Gaston ne vend pas Reddit comme une solution miracle mais insiste au contraire sur la patience nécessaire : 4 à 6 semaines minimum de contribution non promotionnelle avant d'espérer être bien reçu. Les pièges détaillés (schémas répétitifs, ton trop parfait, marque citée en ouverture) sont le genre de détails opérationnels qui manquent souvent dans ce type de contenu. Une porte d'entrée utile sur un canal encore largement ignoré par les équipes marketing françaises.
Le décalage exact entre la France (20,9% des mots-clés à fort volume) et les États-Unis (44,4%), et pourquoi rien ne suggère que la France plafonnera en dessous du niveau américain.
Le sens de propagation des Aperçus IA, du bas vers le haut du funnel, avec le calendrier secteur par secteur : la santé déjà saturée, la finance et le voyage manifestement bridés, le B2B et le e-commerce en milieu de gué.
La preuve chiffrée qu'être bien classé sur Google et être cité dans un Aperçu IA sont deux choses différentes, avec des cas concrets où 38 à 43% des sources citées ne figurent même pas dans le top 10.
Le chiffrage précis de ce que coûte un Aperçu IA en clics perdus, passé de -34,5% à -58% de CTR en seulement 8 mois aux États-Unis, avec la méthode pour appliquer ce calcul à votre propre trafic.
Un plan d'action en 5 mouvements pour être cité, et une expérimentation qui invalide au passage une idée reçue très répandue sur le schema markup.
Ce qu'on a aimé : Un article qui transforme un sujet souvent traité de façon anxiogène en feuille de route concrète, en s'appuyant sur des données Ahrefs solides plutôt que sur des impressions. Juliette Begue ne se contente pas d'annoncer la tendance : elle chiffre le retard français, le calendrier par secteur et même le coût en trafic avec un exemple concret. La partie sur le poids de YouTube dans les citations (20% des liens cités) et sur l'inutilité du schema markup comme levier GEO tranche avec beaucoup de discours ambiants sur le sujet. Du concret, des chiffres, un plan d'action directement actionnable.
Le test grandeur nature de l'auteur : un site bien classé sur Google et Bing, mais totalement absent de l'index Brave, et invisible aux yeux de Claude jusqu'à une seule manipulation.
Les preuves qui confirment que Claude s'appuie sur Brave et non sur Google : jusqu'à 79,2% des URLs citées par Claude figurent dans le top 10 de Brave, contre seulement 34% pour Google.
Un diagnostic reproductible en 2 minutes pour savoir si votre propre site est visible ou non par Claude.
Les trois portes d'entrée réelles de l'index Brave (query channel, page channel, crawler propre), et pourquoi le formulaire de soumission ne fait en réalité que forcer un re-crawl.
Les trois crawlers distincts d'Anthropic à connaître, et les deux pièges de configuration qui bloquent silencieusement votre visibilité sans que ça apparaisse nulle part dans votre robots.txt.
Ce qu'on a aimé : Un article qui part d'un test personnel daté et vérifiable, mais qui ne s'arrête pas à l'anecdote : Raouf Douihech est allé chercher la mécanique complète derrière le résultat, code du Web Discovery Project de Brave à l'appui, et croise deux études indépendantes (Profound et MERJ sur 35 000 citations) pour asseoir sa démonstration. La partie sur les trois crawlers d'Anthropic et les pièges de configuration CDN/pare-feu est le genre de détail opérationnel qui fait souvent défaut ailleurs. Honnête aussi sur ses propres limites, avec la nuance apportée sur TurboPuffer, second sous-traitant apparu depuis mai 2026, dont le rôle exact reste flou.
La méthode des rising stars, pour transformer l'observation d'un concurrent jeune et comparable en véritable règle de sélection de mots-clés.
La méthode des zones de compétitivité, illustrée par deux cas réels très contrastés : un petit blog e-commerce et un site gouvernemental.
Pourquoi allintitle, souvent présentée comme une méthode avancée, est en réalité l'une des plus datées, avec un exemple frappant où aucun résultat de la première page ne contient le terme recherché dans son titre.
Le vrai fonctionnement du KGR (Keyword Golden Ratio), sa formule, ses seuils, et les trois particularités qu'on oublie systématiquement quand on l'applique.
Deux méthodes complémentaires plus rarement évoquées : les slots par formats dominants et les SERP ouvertes vs verrouillées, avec des exemples concrets sur "prêt immobilier" ou "femme de ménage".
Ce qu'on a aimé : La suite logique et tout aussi rigoureuse de la première partie, avec le même souci de confronter chaque méthode à des cas réels plutôt qu'à de la théorie. Alexis Rylko ne se contente jamais d'expliquer une méthode : il en pointe systématiquement les limites, ce qui est particulièrement salutaire pour allintitle et le KGR, deux approches qui reviennent régulièrement dans les formations SEO sans qu'on interroge vraiment ce qu'elles mesurent. La conclusion reformule intelligemment la question à se poser : non pas "ce mot-clé est-il difficile", mais "mon site est-il capable de remplacer l'un des résultats en place". Un article de référence à garder sous la main.
En juin 2026, Google déployait une Spam Update. La firme de Mountain View nous propose une nouvelle mise à jour similaire pour l'été.
Comme le précise Google dans sa communication : « Aujourd’hui, nous avons publié la mise à jour anti-spam d’août 2026 sur Google Search. Il s’agit d’une mise à jour anti-spam normale, et elle sera déployée dans toutes les langues et lieux. Le déploiement peut prendre quelques jours à être terminé. Plus d’informations sur les mises à jour antispam sont disponibles surhttps://lnkd.in/gshkDEU3
Nous mettrons à jour notre page d’historique des sorties de classement à la fin du déploiement :https://lnkd.in/epYqNUQw»
Les mises à jour anti-spam ciblent spécifiquement les pratiques de spam sur les sites web, comme le contenu généré automatiquement en masse, le contenu de faible qualité ou dupliqué, les redirections trompeuses, et d'autres abus visant à manipuler le classement. Elles ont pour objectif de nettoyer les résultats de recherche des contenus trompeurs ou abusifs en améliorant les systèmes automatisés anti-spam de Google.
Les mises à jour du cœur de l'algorithme (Core Update) sont à la fois plus larges et profondes. Elles permettent de réévaluer la qualité, la pertinence et la satisfaction des contenus affichés dans les résultats de recherche. Contrairement aux spam updates, ces mises à jour ne ciblent pas spécifiquement le spam.
Que faire en cas d'impact d'une Spam Update ?
Pendant la mise à jour : rien. Attendez la fin de la mise à jour avant de faire des analyses et d'identifier les pages ou rubriques touchées. Vous pouvez également réaliser un audit SEO afin de vous aider à corriger les problèmes.
Si vous êtes impacté par une SPAM Update, consultez les règles de Google en matière de spam afin de vous assurer que vous les respectez. Apporter des modifications peut aider votre site à s'améliorer si Google ne détecte plus de spam sur votre site. Néanmoins, dans le cas d'une mise à jour spécifique au spam de liens, apporter des modifications peut ne pas entraîner d'amélioration :
Lorsque nos systèmes suppriment les effets que les liens spammeurs peuvent avoir, tout avantage en termes de classement que ces liens pouvaient générer auparavant pour votre site est perdu. Les avantages potentiels en termes de classement générés par ces liens ne peuvent pas être récupérés.
Si ce concept d'Update est nouveau pour vous ou vous inquiète, on vous conseille ces articles :
Rendez-vous dans quelques semaines pour faire le bilan de cette Spam Update !
Pourquoi se tenir informé des updates de Google
Rester informé des dernières évolutions de l'algorithme de Google est nécessaire pour tous les propriétaires de sites. Les core updates peuvent avoir un impact majeur sur le trafic, et anticiper ces changements offre un avantage concurrentiel. On vous expliqueavec quels outils suivre les mises à jour des algorithmes de Google!
Les URLs alternatives hreflang ne sont pas toujours indexées
Gary Illyes (Google) a clarifié le fonctionnement des URLs alternatives hreflang lors de la canonicalisation, suite à une question posée sur LinkedIn par Faiez Javaid. La question initiale était la suivante : Si Google choisit une seule URL /lang/ comme canonique et affiche les autres comme "non indexées" dans GSC, comment se fait-il que Google puisse quand même afficher ces autres versions linguistiques dans les résultats de recherche ?
La réponse de Gary Illyes en deux points :
Noms alternatifs : lorsqu'une URL est canonicalisée, les autres URLs de son cluster de duplicats peuvent devenir des "noms alternatifs". Elles peuvent apparaître dans les résultats si la requête de l'utilisateur le justifie, le cas le plus courant étant les requêtes site:, qui peuvent afficher des URLs qui redirigent en réalité, sans être "indexées" au sens propre.
Les alternates hreflang fonctionnent de la même façon : ce sont des noms alternatifs, pas des URLs indexées au sens strict.
Voir des versions linguistiques/régionales d'une page apparaître en SERP alors que GSC les signale "non indexées" n'est pas forcément le signe d'un problème. Ces URLs ne sont ni cassées ni ignorées, elles sont simplement rattachées à la version canonique comme noms alternatifs, et Google peut les faire remonter dans des contextes précis (hreflang, requêtes site:, etc.). Utile à garder en tête si un client ou un audit s'inquiète de voir des URLs hreflang marquées "non indexées" dans Search Console.
En Europe, environ 15 % des bots IA de type "fetcher" identifiés ont accédé à des URL pourtant marquées comme interdites.
ChatGPT-User, Bytespider et Youbot sont les principaux responsables : chacun a atteint des pages interdites sur près de la moitié des sites européens qui les avaient explicitement bloqués, ChatGPT-User en tête.
OpenAI justifie ce comportement par le fait que ChatGPT-User agit à la demande d'un utilisateur, ce qui le distinguerait d'un crawl classique soumis au robots.txt. Perplexity avance le même argument pour Perplexity-User, tandis qu'Anthropic affirme que ses trois bots respectent tous le fichier.
Bloquer ChatGPT-User ne bloque pas OAI-SearchBot, l'agent qui décide si un site apparaît dans les résultats de recherche de ChatGPT. Un site qui interdit les deux pense couper tout trafic IA, mais perd la visibilité côté recherche sans gagner en protection côté fetch.
Le rapport State of the Bots de TollBit, qui compile les données du premier semestre 2026, montre aussi que la situation varie beaucoup selon les agents. Claude-User n'est bloqué que par 9 % des sites européens, contre 26 % en Amérique du Nord. Perplexity-User affiche 13 % contre 26 %. La plupart des agents récents ont des taux de blocage à un chiffre en Europe, mais ChatGPT-User fait figure d'exception, à la fois très bloqué et très souvent contourné malgré ce blocage.
La documentation d'OpenAI est claire sur ce point : ChatGPT-User se déclenche quand un utilisateur pose une question dans ChatGPT, et parce que l'action part d'un humain, le robots.txt pourrait ne pas s'appliquer. TollBit, de son côté, ne fait pas cette distinction : toute requête vers une URL interdite est comptée comme un contournement, quelle que soit la justification donnée par l'opérateur du bot.
Pour un éditeur de site, la conséquence pratique est la suivante : le fichier robots.txt ne montre que ce qui a été demandé en théorie, pas ce qui s'est réellement passé. Seuls les logs serveur ou les données CDN permettent de savoir ce qui a effectivement été récupéré.
Cloudflare prépare de son côté un changement de méthode. À partir du 15 septembre, les nouveaux domaines ajoutés à Cloudflare verront leurs crawlers d'entraînement et leurs agents bloqués par défaut sur les pages contenant des publicités, les crawlers de recherche restant autorisés. La décision de blocage se déplace ainsi au niveau du réseau plutôt que d'être laissée à la bonne volonté du crawler. Reste à savoir si l'argument du "chargement initié par l'utilisateur" tiendra sur la durée, maintenant que tous les grands assistants IA récupèrent les pages de cette manière.
Un projet SEO, c'est une multitude d'accès à protéger
Sur un client, une agence ou un consultant jongle en général avec une dizaine d'accès différents : Search Console, Google Analytics, CMS (souvent WordPress), FTP ou SFTP, panneau d'administration de l'hébergeur, comptes publicitaires, outils tiers comme Screaming Frog, Ahrefs ou SEMrush, parfois des clés API pour des intégrations spécifiques. Multiplié par une dizaine de clients, et par plusieurs collaborateurs qui vont et viennent sur ces différents comptes, le nombre d'identifiants à gérer peut prendre des proportions ahurissantes.
Dans la pratique, cette gestion demeure souvent artisanale. Un tableur partagé sur le Drive de l'agence, un mot de passe envoyé par email ou par Slack au démarrage d'une mission, et parfois même un mot de passe réutilisé d'un client à l'autre parce que “c'est plus simple à retenir”. Ces habitudes fonctionnent au quotidien, jusqu'au jour où un compte se retrouve compromis ou qu'un accès n'est pas révoqué après la fin d'une collaboration.
Le tableur partagé, la fausse bonne solution
Un fichier de mots de passe partagé donne l'illusion d'une organisation centralisée. En réalité, il cumule plusieurs faiblesses :
Aucun chiffrement réel des données,
Aucune traçabilité de qui a consulté quoi,
Une diffusion qui échappe vite à tout contrôle une fois le fichier copié, dupliqué ou envoyé par erreur.
Si l'ordinateur d'un collaborateur est piraté, c'est alors l'ensemble des accès de tous les clients de l'agence qui se retrouve exposé en même temps.
Le même problème se pose à la fin d'une mission. Que devient l'accès à la Search Console ou au CMS quand un freelance termine sa collaboration, ou qu'un salarié quitte l'agence ? Trop souvent, rien n'est révoqué proprement, et l'ancien accès reste valide durant des mois, voire des années.
Structurer les accès par client, avec un chiffrement réel
C'est exactement le terrain sur lequel se positionne un gestionnaire de mots de passe conçu pour les équipes. Dans sa version Business, il permet de créer plusieurs coffres partagés, un par client ou par projet, avec des permissions différenciées selon les membres de l'équipe. Chaque identifiant, note ou code stocké est chiffré de bout en bout localement, avant même d'être synchronisé : le fournisseur lui-même n'a jamais accès aux données..
Concrètement, cela change la logique de partage. Plutôt que d'envoyer un mot de passe en clair, on donne accès à un coffre précis, pour la durée de la mission, avec la possibilité de révoquer cet accès en un clic le jour où la collaboration s'arrête. L'outil intègre aussi un authentificateur 2FA directement dans les entrées, avec remplissage automatique des codes, ce qui évite de jongler entre plusieurs applications et encourage réellement l'équipe à activer cette protection sur les comptes sensibles comme la Search Console ou l'hébergement.
Générer des mots de passe solides dès le départ
La deuxième faiblesse classique, au-delà du partage, c'est la nature même des mots de passe utilisés pour créer ces comptes. Un mot de passe court, réutilisé ou construit sur un schéma prévisible reste vulnérable même stocké dans le meilleur des coffres.
À ce titre, ce type d’outil propose un générateur de mot de passe intégré, qui génère des combinaisons longues et aléatoires directement au moment de la création d'un compte, sans avoir à réfléchir à un mot de passe mémorisable. Sur un projet SEO, l'utiliser systématiquement pour chaque nouvel accès (CMS, hébergeur, outil tiers) limite fortement le risque qu'un identifiant insuffisamment sécurisé ne devienne le maillon faible de tout le projet.
Un scénario courant : la fin de mission mal gérée
Prenons un exemple, malheureusement, on ne peut pas plus classique. Un consultant SEO termine une mission de six mois pour un client. Pendant cette période, il a eu accès à la Search Console, à l'administration WordPress, au FTP de l'hébergeur et à un compte Ahrefs partagé. À la fin du contrat, personne ne pense à retirer ces accès. Le client change de prestataire et passe à autre chose.
Un an plus tard, le compte email personnel de l’ancien consultant est concerné par une fuite de données sans rapport avec le client. Si les identifiants du CMS ou du FTP étaient stockés dans ce même email, ou dans un tableur synchronisé avec ce compte, l'attaquant récupérerait au passage un accès toujours actif à un site qu'il n'a jamais eu besoin de pirater directement.
Bien qu'ancien, le cas de Dropbox est un cas d'école. En 2012, LinkedIn subit une fuite massive de données touchant 167 millions de comptes. Un salarié de Dropbox utilisait le même mot de passe pour son compte LinkedIn personnel et pour un compte interne Dropbox. Les attaquants ont réutilisé les identifiants récupérés lors de la fuite LinkedIn pour accéder aux systèmes internes de Dropbox, un cas typique de réutilisation d'identifiants. Une fois entrés, ils ont récupéré une base de données contenant des mots de passe hachés et d'autres informations utilisateur, qui a fini par circuler en ligne...
Avec des coffres organisés par client dans un gestionnaire chiffré et des mots de passe uniques générés à la volée, ce scénario n’a plus du tout les mêmes conséquences. L'accès du consultant est limité au coffre du projet, il ne transite jamais par sa messagerie personnelle, et il suffit de retirer son compte du coffre partagé le jour où la mission se termine pour couper immédiatement l'accès, sans être contraint de changer un par un les mots de passe de chaque outil.
Les crawlers de Google renvoient parfois des requêtes différentes de GET et POST
Gary Illyes a confirmé sur LinkedIn que les robots d'exploration de Google n'envoient pas uniquement des requêtes HTTP GET et POST, mais aussi des requêtes HEAD, OPTIONS, PUT, PATCH et DELETE, en réponse à plusieurs questions reçues à ce sujet ces dernières semaines.
Ces types de requêtes (HEAD, OPTIONS, PUT, PATCH, DELETE) représentent moins de 1,5% du total des requêtes envoyées par l'ensemble des crawlers Google. Leur origine : le JavaScript. Selon Gary Illyes, c'est du code JS présent sur les pages qui déclenche ces requêtes lors du processus de rendu effectué par Google.
Google a annoncé jeudi dernier une mise à jour majeure de sa fonction « Ask Maps », qui gagne en autonomie. Au-delà des informations, l'outil peut désormais accomplir des tâches concrètes pour l'utilisateur, en s'appuyant sur des plateformes partenaires. Cette évolution illustre la volonté de Google de transformer son application de navigation en véritable assistant du quotidien.
Ce qu'il faut retenir :
Ask Maps peut désormais commander de la nourriture, réserver un hôtel et trouver des billets pour des événements, via des plateformes partenaires comme Square, Toast ou Uber Eats.
La fonction Personal Intelligence permet à l'outil de personnaliser ses réponses en puisant dans Gmail et Google Calendar de l'utilisateur, mais elle est désactivée par défaut.
Ask Maps garde désormais en mémoire les conversations précédentes, ce qui permet de reprendre une recherche ou un projet de voyage là où on l'avait laissé.
Les fonctionnalités de commande, réservation et billetterie sont pour l'instant réservées aux utilisateurs américains, tandis que Personal Intelligence et le widget de transit en temps réel sont déployés dans tous les marchés où Ask Maps est disponible.
Commander à manger et réserver un hôtel directement depuis Maps
Concrètement, un utilisateur peut désormais taper une requête comme « où puis-je commander un avocado toast vegan et un latte au lait d'avoine près de chez moi » dans Ask Maps. L'outil affiche alors les restaurants à proximité qui proposent ces plats. En sélectionnant un établissement, il suffit de cliquer sur « commander en ligne » pour passer commande via une plateforme partenaire comme Square, Toast ou Uber Eats. Ask Maps ajoute les articles au panier, et l'utilisateur peut compléter sa commande et payer directement sur la plateforme choisie.
La même logique s'applique à la réservation d'hôtel. En formulant une demande précise, par exemple pour trouver un hôtel bien noté et pas trop cher, avec une ambiance particulière, proche d'une salle de sport et de restaurants, Ask Maps compare les prix et vérifie les disponibilités avant de proposer une sélection d'options. Il suffit ensuite de cliquer pour être redirigé vers le site du partenaire afin de finaliser la réservation.
L'outil permet également de dénicher des spectacles ou des concerts à proximité, avec des liens directs pour acheter les billets.
Une personnalisation basée sur Gmail et l'agenda, mais désactivée par défaut
Avec Personal Intelligence, Ask Maps va plus loin en s'appuyant sur les emails et le calendrier de l'utilisateur pour donner des réponses sur mesure. On peut par exemple demander à quelle heure on atterrira à Vancouver lors d'un prochain vol, ou se faire recommander des restaurants et activités près de son hôtel de réservation.
Cette fonctionnalité reste toutefois optionnelle et n'est pas activée automatiquement, ce qui laisse à chacun le choix de partager ou non ces données personnelles avec l'outil.
Autre nouveauté notable, Ask Maps mémorise désormais les échanges précédents. Il devient ainsi possible de demander à l'outil quelles activités il avait suggérées pour un voyage à Seattle, par exemple, et de continuer à planifier son séjour sans repartir de zéro.
Enfin, Google lance un widget de transit en temps réel dans Ask Maps, permettant de suivre les retards et les conditions de circulation au fil de leur évolution.
Le e-commerce français a atteint 196,4 milliards d'euros de chiffre d'affaires en 2025, soit une hausse de 7 % par rapport à 2024, avec 3,2 milliards de transactions réalisées (+11 %).
42,2 millions de Français ont acheté en ligne au cours des 12 derniers mois, soit 72,9 % des plus de 15 ans, avec un usage désormais multi-écrans pour plus d'un e-acheteur sur deux.
Le commerce agentique s'impose comme une tendance de fond : 94 % des marchands ont déjà adopté des solutions d'IA générative et près d'un cyberacheteur sur trois les intègre dans son parcours d'achat.
Les places de marché continuent de gagner du terrain et concentrent désormais 32 % du volume d'affaires des ventes de produits en ligne.
Un marché qui retrouve des couleurs après la crise inflationniste
Après deux années marquées par la pression inflationniste, le e-commerce français repart de l'avant. Le chiffre d'affaires du secteur s'établit à 196,4 milliards d'euros en 2025, en progression de 7 % sur un an. Cette croissance se répartit entre deux dynamiques bien distinctes : les services, qui atteignent 120,3 milliards d'euros (+9 %), et les produits, qui renouent avec la croissance à 76,1 milliards d'euros (+4 %) après deux années de repli.
Ce redémarrage des ventes de produits est présenté par la Fevad comme le signal le plus encourageant de cette édition. Il confirme que la crise inflationniste de 2023 est bel et bien refermée, sans pour autant effacer son empreinte sur les comportements d'achat : le panier moyen continue de baisser et s'établit désormais à 62 euros, preuve que les Français achètent plus souvent, mais avec plus de vigilance sur les prix.
Le nombre de transactions suit la même trajectoire ascendante, avec 3,2 milliards d'opérations enregistrées en 2025, soit une progression de 11 % par rapport à 2024. Le e-commerce représente aujourd'hui 12 % du commerce de détail et près de 30 % de l'activité sur les principaux univers non alimentaires, comme l'équipement de la maison (32 % de part de marché) ou l'habillement (30 %).
Des acheteurs toujours plus nombreux et toujours plus mobiles
En France, 42,2 millions de personnes de plus de 15 ans ont acheté en ligne au cours des douze derniers mois, soit 72,9 % de cette population, et 80 % des 16-74 ans. La progression est continue, avec 0,6 million d'e-acheteurs supplémentaires en un an.
Le profil de ces acheteurs révèle des écarts marqués selon l'âge et la catégorie socioprofessionnelle. Les 30-44 ans affichent le taux d'achat en ligne le plus élevé (90,8 %), tandis que les 75 ans et plus restent en retrait (25,9 %). Du côté des catégories professionnelles, les cadres et professions intellectuelles supérieures se distinguent nettement avec 96,5 % d'acheteurs en ligne.
Autre tendance de fond : la multiplication des écrans utilisés pour acheter. 55 % des e-acheteurs sont désormais multi-écrans. Si l'ordinateur reste le support privilégié (76 % d'utilisateurs), le mobile progresse rapidement et gagne sept points en un an, pour atteindre 69 % d'utilisateurs.
Le paiement et la livraison, deux terrains d'innovation constante
Le paiement par carte bancaire demeure archi-dominant, utilisé par 92 % des cyberacheteurs. Mais les alternatives s'installent durablement dans les habitudes : points de fidélité et cartes cadeaux (76 %), portefeuilles numériques (57 %), prélèvement (48 %) ou encore paiement fractionné, désormais utilisé par 21 % des acheteurs et déjà testé par 51 % des cyberacheteurs au moins une fois.
Sans surprise, la sécurité reste la préoccupation numéro un des e-acheteurs : 94 % jugent important d'évoluer dans un environnement de paiement sécurisé, devant la simplicité du parcours (92 %) et les modes de paiement proposés (87 %).
Côté livraison, la livraison à domicile reste le mode privilégié, utilisée par 77 % des e-acheteurs. Mais les solutions hors domicile, points relais en tête (76 % d'utilisateurs), progressent fortement et représentent désormais 46 % des usages, portées par une demande croissante de flexibilité.
L'intelligence artificielle bouleverse déjà les pratiques
C'est le fait marquant de cette édition selon Marc Lolivier, délégué général de la Fevad : près d'un cyberacheteur sur trois intègre déjà l'intelligence artificielle dans son parcours d'achat. Ce chiffre grimpe à près de trois sur quatre parmi les utilisateurs réguliers d'IA.
Du côté des professionnels, le mouvement est encore plus net. 94 % des marchands déclarent avoir adopté au moins une solution basée sur l'IA générative, et 87 % d'entre eux constatent déjà des évolutions concrètes sur les compétences et les process au sein de leur entreprise. Le commerce agentique est perçu comme l'une des innovations les plus prometteuses à trois ans par 69 % des dirigeants interrogés, juste derrière l'IA générative elle-même.
Pour les consommateurs, l'usage de l'IA reste concentré en amont de l'achat : 58 % des utilisateurs réguliers s'en servent pour la recherche et l'aide à la décision, contre seulement 27 % au moment du paiement et 35 % pour le suivi après achat.
La seconde main, un réflexe désormais installé
Autre évolution notable : plus de 4 cyberacheteurs sur 10 (41,4 %) ont acheté au moins un produit d'occasion en ligne au cours des 12 derniers mois. Ce mode de consommation ne se substitue pas au neuf, il le complète. Dans la mode par exemple, 30 % des acheteurs combinent achats neufs et seconde main, une proportion similaire dans les jeux et jouets ou les produits culturels physiques.
Les recherches « tenues de festival été » ont augmenté de +400 % sur Pinterest, signe que les festivaliers préparent leurs looks bien avant les premiers concerts.
Six grandes tendances se dégagent : maximalisme tropical, style pirate, indie sans effort, pop Y2K, transparence euphorique et esthétique « grand drama ».
Pinterest lance un partenariat inédit avec Le Touquet Music Beach Festival, avec un tableau dédié pour planifier ses tenues, ainsi que des contenus exclusifs et des challenges créatifs sur place.
L'esthétique « showgirl » explose littéralement, avec une hausse de +945 % des recherches associées.
Du maximalisme tropical au style pirate
La tendance qui écrase toutes les autres, c'est le maximalisme tropical. Plumes, franges et paillettes dorées s'y mêlent dans une ambiance de carnaval, portée notamment par l'explosion des recherches « esthétique showgirl » (+945 %). On y retrouve aussi les tenues « tropicoqueta » (+105 %) et les robes à franges dorées (+30 %).
À l'opposé, le style piratecore mise sur le récup et l'imperfection assumée : ceintures superposées, suédine usée et maquillage légèrement baveux. Les recherches de maquillage yeux pirate grimpent de +330 %, tandis que les mini-jupes en suédine progressent de +195 %.
Indie, pop et transparence : trois façons différentes de vibrer
Le style indie sans effort séduit les nostalgiques de l'esthétique rock des années 2000 : t-shirts de groupes chinés, chemises en flanelle usées et allure décontractée mais pointue. Les recherches de tenues rock années 2000 et d'outfits shoegaze progressent chacune de +60 %.
À l'inverse, la tendance pop Y2K joue la carte de l'excès assumé, avec des jeans aérographés (+75 %) et l'esthétique « Frutiger Aero » (+40 %), qui mélange brillance techno et maximalisme pop.
Autre ambiance avec la tendance « sheer euphoria » : organza transparent et soies oversize pour des looks doux et émotionnels, pensés pour les moments de complicité entre amis sur le dancefloor. Les jupes transparentes street style et les chemises en organza progressent toutes deux de +60 %.
Le grand drama, ultime tendance de la saison
Dernière esthétique repérée par Pinterest : le grand drama, où l'exagération devient la règle. Chaussures dépareillées, maquillage contrasté et superpositions audacieuses composent des looks pensés comme de véritables costumes. Les recherches de tenues dépareillées bondissent de +75 %, celles de maquillage dramatique des yeux de +45 %.
En juillet 2026, notre équipe chez RESONEO a capturé et disséqué 1 200 réponses ChatGPT, 88 000 résultats de recherche et 26 900 pages distinctes pour répondre à une question : quand ChatGPT cite une page, d'où vient-elle ? Jérôme Salomon (Oncrawl) a guidé toute la partie cache. L'étude complète est publiée sur think.resoneo.com ; cet article en tire ce que les professionnels du search doivent retenir.
La version courte : le grounding de ChatGPT repose sur trois étages de stockage. Un index de discovery qui trouve les pages, un cache de lecture qui conserve la copie intégrale des pages déjà fetchées, et un petit lot de pages ouvertes en live. Chaque étage a ses règles, sa fraîcheur et ses angles morts. Une fois qu'on a ces trois étages en tête, le comportement de citation de ChatGPT cesse d'être mystérieux et redevient ce qu'il est : un système construit pour répondre au moindre coût.
Comment on sait tout ça
Notre extension chrome enregistre le flux de données brut que chatgpt.com envoie au navigateur, y compris des champs que l'interface n'affiche jamais. Jusqu'au 21 juillet 2026, ce flux contenait un champ result_source qui nommait le pipeline interne derrière chaque résultat de recherche. Quatre valeurs revenaient sans cesse : labrador, bright, oxylabs, serp. Aucune n'est documentée par OpenAI, qui ne parle publiquement que de « third-party search providers ».
Puis le champ a disparu du flux. Du jour au lendemain, sur tous les comptes qu'on surveille. Nous ré-identifions désormais chaque pipeline par ses signatures de format (longueur de snippet, forme des title...), avec un classifieur qui tombe juste environ 98 % du temps. La V5 de notre extension l'embarque en natif. Nous avons aussi fait tourner une flotte de comptes sur plusieurs tiers et plusieurs pays, rejoué les mêmes prompts via l'API d'OpenAI, et publié des pages canari sur notre propre domaine avec les logs serveur complets, pour voir exactement ce que les robots d'OpenAI récupèrent au lieu de le deviner.
Le casting des pipelines
Ce qu'on avait établi avant cette campagne, et qui tient toujours :
labrador est le hub de retrieval maison d'OpenAI. En plus du web search, il renvoie des résultats news, academia (arXiv), Reddit et YouTube : il fonctionne comme un orchestrateur d'index internes, de dépôts ouverts type Wikipedia et de partenariats presse.
bright et oxylabs, ce sont des résultats Google scrapés, achetés en live.
P1/P2/P3 servent le shopping, depuis les feeds marchands propres à OpenAI, avec Google conservé en oracle pour les prix et les avis.
B1/B3, Yelp et Tripadvisor servent le local, avec une subtilité : les liens affichés aux utilisateurs pointent vers Google Maps.
Le shopping et le local ne touchent jamais au web search. Si vous vendez des produits ou tenez un restaurant, votre bataille se joue dans les feeds marchands et les fiches locales, en plus des citations classiques. Cet article se concentre sur le versant web search, parce que c'est là que sont tombées les surprises.
Étage 1 : l'index, et Bing n'y est pour rien
Commençons par le résultat principal : OpenAI a son propre index web, et ce n'est pas Bing qui l'alimente. On l'a vérifié de trois façons. Seules 1,5 % des URLs labrador apparaissent dans le top 20 de Bing sur les mêmes fan-outs. Aucun snippet labrador ne correspond à un snippet Bing. Et Bing coupe les title à 75 caractères, alors que 24 % des title labrador dépassent allègrement cette limite. Le plus long qu'on ait capturé fait 289 caractères.
Cet index alimente la quasi-totalité des citations search en mode instant, le mode rapide servi aux utilisateurs gratuits. L'exception, ce sont les questions dont la réponse nécessite des données quasi en live (« qui a gagné le match hier soir »), où il partage à peu près 50/50 avec des résultats Google scrapés.
Maintenant, que contient concrètement un résultat de cet index ? Trois choses. L'URL. Le title complet de la page, jamais tronqué, même quand il est absurdement long. Et un snippet d'environ 200 caractères.
La construction du snippet mérite qu'on s'y arrête, parce que c'est l'intégralité du texte de votre page qui atteint le modèle en mode instant. Il est ancré sur votre H1, restitué en majuscules, plus tout le texte visible qui traîne immédiatement autour. Cen'est pas forcément le texte que vous choisiriez... Tout : le libellé de catégorie au-dessus du titre, l'attribut alt de l'image en dessous, la signature, la date de publication, un sommaire s'il est posé là. On a mesuré un cas où le snippet était à 100 % un sommaire et à 0 % du contenu. Ce qui occupe ces 200 caractères sera repris, et rien d'autre, et la meta description est totalement ignorée.
Encore une chose sur ce snippet : il ne dépend pas de la query. La même URL ressort avec le même snippet figé, que l'utilisateur ait demandé un prix, un historique ou des effets secondaires. Il est découpé à l'indexation et servi tel quel jusqu'au crawl suivant.
Au regard des standards du search moderne, c'est assez grossier... Le snippet indépendant de la query, c'est le genre de chose que la recherche web a abandonné il y a une vingtaine d'années, et le voilà en 2026 aux commandes de l'assistant IA le plus utilisé de la planète. On suppose que c'est un provisoire appelé à s'améliorer vite. En attendant, c'est là-dessus que votre contenu est jugé.
En comparaison, les résultats bright ressemblent exactement à ce qu'ils sont, des résultats Google : title coupés vers 60 caractères avec des points de suspension, snippets d'environ 160 caractères, meta description reprise une fois sur trois. Votre meta description ne sert à rien pour labrador et fonctionne toujours pour les pipelines alimentés par Google.
Un routage économique, pas technique
Pourquoi OpenAI entretient-il les deux ? Le coût est la réponse.
En mode instant, ChatGPT doit répondre en quelques secondes et l'utilisateur ne paie généralement rien. Donc il n'interroge que ce qu'OpenAI possède déjà : le hub labrador. Aucune page n'est ouverte (zéro page ouverte dans 93 % des réponses instant capturées). La réponse est fondée sur des title et des snippets de 200 caractères, rien d'autre.
En mode thinking, l'utilisateur paie un abonnement et accepte d'attendre. Là, les outils chers sont invoqués : classements Google scrapés via bright (75 % des résultats search en thinking), et vraies ouvertures de pages par le robot ChatGPT-User. Une conversation thinking ramène une centaine de résultats répartis sur environ 28 domaines, contre environ 11 résultats en instant.
Tout ce qui coûte à OpenAI de l'argent (payer les prestataires de scraping) ou du temps (ouvrir des URLs, appeler des APIs live) est réservé au mode où les utilisateurs paient et patientent.
Voilà pourquoi ça compte commercialement : plus de 90 % des utilisateurs de ChatGPT sont au tier gratuit. Gratuit veut dire instant, et instant veut dire labrador. Le pipeline dont personne n'avait entendu parler il y a six mois est celui qui décide de la visibilité dans l'immense majorité des conversations ChatGPT en cours en ce moment même.
Les chiffres du funnel rendent l'enjeu concret. Sur notre corpus, 61 332 URLs ont été remontées dans la sidebar de sources. 5 032 sont devenues la source principale d'une citation. 759 pages ont été réellement ouvertes, toutes en mode thinking. Une page ouverte finit citée 74 % du temps ; une page simplement remontée, mais non ouverte, 7 %.
Étage 2 : un cache de lecture partagé par tout le monde
C'est la partie que Jérôme Salomon a creusée avec nous, et elle a changé notre façon de comprendre « ChatGPT a visité ma page ».
À côté de l'index, ChatGPT entretient un cache de toutes les pages qu'il a fetchées un jour. Pas des snippets : des pages complètes, converties du HTML vers du markdown et stockées comme ça. Le cache est keyé sur l'URL et partagé entre tous les utilisateurs et tous les tiers. Si un utilisateur gratuit à Berlin pose une question sur une page qu'un abonné payant de l'Ohio a fait fetcher la semaine dernière, Berlin reçoit la copie de l'Ohio.
La logique de rafraîchissement est ce que les ingénieurs appellent du stale-while-revalidate. Une copie est considérée fraîche pendant environ 30 minutes. Dans cette fenêtre, tout le monde reçoit la version stockée et votre serveur ne voit rien passer. Au-delà de 30 minutes, l'utilisateur reçoit quand même la copie périmée immédiatement, et un fetch en arrière-plan la rafraîchit pour le suivant. Ce qui veut dire que le rythme de recrawl de vos pages est réglé par un seul signal : la fréquence à laquelle les utilisateurs de ChatGPT les demandent. Les pages populaires restent fraîches. Les autres vieillissent indéfiniment ; Jérôme a documenté des copies servies plus de 90 jours après le fetch, sans plafond d'éviction en vue. Votre header Cache-Control: no-store ? Ignoré. Votre noindex ? Ignoré aussi.
La conversion en markdown a sa propre personnalité. Les scripts, les iframes et le JSON-LD sont supprimés (oui, vos données structurées n'atteignent jamais le modèle par ce chemin). Les alt d'images survivent. Et le texte masqué en CSS est extrait quand même, ce qui veut dire que le robot lit des choses qu'aucun visiteur humain ne voit. On vous laisse méditer les implications, en notant que la détection de cloaking ne semble pas encore être le point fort d'OpenAI.
Deux limites dures encadrent chaque fetch. Le robot n'exécute pas le JavaScript, donc le contenu injecté côté client lui est invisible. Et les pages sont plafonnées à exactement 4Mo. Au-delà, la page n'est pas tronquée. Elle est rejetée d'un bloc avec une HTTP 400, et le modèle ne lit rien du tout. Une page trop lourde n'est pas lue en partie ; elle n'existe pas.
Une surprise se cache dans tout ça : un paramètre de l'API renvoie la date de crawl de la copie stockée d'une URL. Fetchez vos propres pages par ce biais et vous savez quand un utilisateur de ChatGPT a fait lire votre page pour la dernière fois. C'est une vraie métrique d'exposition, presque gratuite, et personne ne la regarde (merci Jérôme Salomon pour la trouvaille !).
L'angle mort analytics
Vous avez sans doute déjà vu utm_source=chatgpt.com dans vos rapports analytics. Ce paramètre est ajouté aux liens cliquables affichés aux utilisateurs. Il traque le clic sortant. Mais toutes les citations n'ont pas ce paramètre de tracking... Nous avons en effet observé que les pages que ChatGPT ouvre de lui-même en mode thinking ne contiennent pas d'utm_source dans les citations présentées aux utilisateurs.
Donc les pages que le modèle a réellement lues en entier, celles qui ont 74 % de taux de citation, ne laissent aucune trace utm. Si vous jaugez votre exposition ChatGPT en filtrant sur ce paramètre, vous comptez les clics et vous ratez les lectures. Surveillez aussi le user-agent ChatGPT-User dans vos logs serveur.
Le mystère : des citations venues de nulle part
Un résultat résiste à l'explication, et on aimerait l'aide de la communauté dessus.
Une partie des résultats qui atteignent le modèle n'ont aucun snippet, juste un title et une URL. On l'a constaté pour les résultats arXiv ou Reddit, qui viennent de bases de données pour lesquelles OpenAI a un accès direct, donc cela ne nous choque pas. Mais il y en a beaucoup d'autres.. Et voilà le plus étrange : en mode instant, les URLs sans snippet (hors Reddit, Youtube, arXiv) sont citées plus que les URLs avec snippet (14,9 % contre 8,2 %). Le modèle préfère citer les pages sur lesquelles il a lu le moins de choses.
Plus étrange encore, certains liens cités ne correspondent à aucun résultat de recherche. Notre hypothèse est que le modèle les écrit depuis sa mémoire paramétrique, la connaissance gravée dans ses poids à l'entraînement. Ce sont presque toujours des racines de domaines connus, consciencieusement suffixées utm_source=chatgpt.com comme si elles sortaient d'une recherche. Une part non négligeable de ce que ChatGPT finit par citer pourrait être simplement ce dont il se souvient, pas ce qu'il a récupéré. On observe le phénomène ; on ne sait pas encore le dimensionner précisément, et on accueillera volontiers les contradicteurs sur ce point.
Une bizarrerie voisine : arXiv a été remonté plus de 2 600 fois dans notre corpus et cité 10 fois. Reddit, même profil. ChatGPT lit des preprints et des forums pour réfléchir, puis montre au lecteur des pages web ordinaires. Être récupéré et être cité sont deux marchés différents.
Alors, faut-il écrire des title de 289 caractères ?
Soyons francs sur la tentation. Le title complet atteint le modèle sans troncature, donc il fait partie de votre budget de grounding. Les 200 caractères après votre H1 sont le seul texte du corps que le modèle voit en mode instant, donc décaler les libellés de catégorie, les dates et les widgets coincés entre votre H1 et votre première phrase utile améliore directement ce que ChatGPT sait de votre page. Ces deux leviers sont réels, mesurés, actionnables aujourd'hui.
Actionnez-les avec légèreté. Écrivez le title comme une phrase autoportante plutôt que comme un libellé optimisé pour la troncature. Faites porter votre message de fond par les 200 premiers caractères après le H1. Gardez un alt informatif près du haut de page. Gardez votre meta description quand même, parce que les pipelines alimentés par Google s'en servent toujours. Restez sous les 4 Mio et lisible sans JavaScript.
Mais ne reconstruisez pas votre site autour d'une bizarrerie. Tout ce que décrit cet article est un système qui évolue très vite : le champ result_source a disparu du jour au lendemain, les providers shopping ont été anonymisés la même semaine, et les tokens Google Shopping sont passés de lisibles à chiffrés en quatre jours. N'importe quel mécanisme documenté ici peut avoir disparu le temps que vous déployiez.
Deux faits structurels, en revanche, sont solides. Un : les LLMs ont un knowledge avec une date de cutoff, après laquelle ils ne connaissent plus rien, ils sont donc condamnés à s'appuyer sur des moteurs de recherche pour combler l'écart entre leurs données d'entraînement et aujourd'hui. Le retrieval restera une dépendance permanente de tout assistant IA. Deux : tous les moteurs sur lesquels ils s'appuient seront poussés vers une qualité de niveau Google, parce qu'un index rudimentaire produit des réponses rudimentaires et que les utilisateurs le remarquent. Le snippet de 200 caractères ne fera sans doute pas long feu... Le besoin d'être la meilleure réponse, non. C'est pour ça que les fondamentaux classiques, des pages crawlables, des title clairs, du contenu qui répond vraiment à la question, continuent de payer quelle que soit la plomberie.
La bataille durable : posséder les réponses aux vraies questions
Optimiser la mécanique du snippet, c'est de la tactique. La stratégie est en amont : savoir ce que les gens demandent réellement aux assistants IA, et être la source qui y répond.
Personne ne demande à ChatGPT « une poussette avec un châssis de 49 cm de large ». On lui demande « une poussette qui passe les portiques du métro ». Personne ne cherche la dureté de la mousse d'un casque audio ; on demande quel casque reste confortable quand on porte des lunettes. On demande quel canapé survit à un chat qui fait ses griffes. Cet écart entre la langue des fiches techniques et la langue des humains est exactement là où se joue la visibilité IA, parce que les assistants répondent à des questions conversationnelles avec le contenu qui s'y apparie le mieux.
Vous possédez déjà la moitié du corpus qui révèle ces questions : les avis clients, les conversations du support, les emails que vous recevez chaque jour, les enquêtes que personne n'a rouvertes. L'autre moitié vit hors de vos murs, dans ce qui se dit de vos produits sur les forums, les plateformes sociales, en vidéo, dans la presse et sur les blogs. Lisez les deux versants et les key benefits et pain points de vos produits ressortent dans les mots de vos clients, qui sont aussi les mots qu'entendent les assistants IA. Exploitez cette langue, répondez-y sur des pages que les robots peuvent lire, et vous optimisez pour tous les systèmes de retrieval à la fois, y compris ceux qu'OpenAI n'a pas encore construits.
Ce qui reste ouvert
Nous ne savons pas quel robot alimente l'index labrador ; nos pages canari ont vu OAI-SearchBot quasi muet pendant que l'index continuait de servir des résultats. Reddit est le cas facile, puisqu'OpenAI dispose d'un accès temps réel à la data API de Reddit via leur partenariat de 2024 ; YouTube est une autre histoire, sans accord public ni empreinte visible expliquant comment ces résultats entrent. Et la sur-citation des URLs sans snippet reste expliquée par une hypothèse.
La stack d'OpenAI devient de plus en plus difficile à observer. Des champs disparaissent du flux, des providers sont anonymisés, le routage change d'une semaine à l'autre, et l'ensemble se complexifie au fil du temps. Nous avons tout publié, méthodologie comprise, précisément pour que d'autres puissent challenger ces résultats ou pousser plus loin. L'étude complète, avec les données derrière chaque chiffre de cet article, est sur think.resoneo.com/chatgpt-retrieval.
Pourquoi se former à l'IA générative aujourd'hui ?
L'IA générative n'est plus un sujet de curiosité réservé aux early adopters. Rédaction, analyse de données, code, service client, marketing : la plupart des métiers du tertiaire sont désormais traversés par ces outils, à des degrés divers. Savoir utiliser un chatbot n'est plus suffisant pour en tirer un avantage réel : encore faut-il comprendre les forces et limites de chaque outil, savoir construire un prompt efficace, automatiser une tâche récurrente, ou encore éviter les écueils liés à la confidentialité des données professionnelles.
C'est cette montée en compétence, souvent négligée, qui fait la différence entre un usage anecdotique de l'IA et un vrai gain de productivité. D'où l'intérêt grandissant pour les formations dédiées, qu'elles s'adressent à des débutants curieux ou à des professionnels souhaitant structurer leur pratique.
Comment choisir sa formation IA générative ?
Avant de comparer les offres, il faut clarifier son objectif. Les formations disponibles sur le marché ne répondent pas toutes au même besoin :
Se familiariser avec les outils pour un usage quotidien au travail (rédaction, synthèse, automatisation de tâches)
Acquérir une culture générale sur l'IA, ses enjeux et ses limites, sans viser une application professionnelle immédiate
Se spécialiser techniquement, avec une orientation développement ou data science
Le format compte aussi : un MOOC en autonomie ne demande pas le même investissement qu'un parcours encadré avec formateurs et projet final. Le prix, l'éligibilité au CPF, et la reconnaissance de la formation par les employeurs sont d'autres critères à examiner avant de s'engager.
Le classement des meilleures formations en IA générative
1. Jedha, la formation pour gagner du temps dans son travail grâce à l'IA
Les options pour suivre une formation IA générative ne manquent pas en 2026, mais elles sont toutes loin de se valoir. Celle proposée par Jedha vise spécifiquement les professionnels déjà en poste qui veulent intégrer l'IA à leur travail, sans pour autant devenir des techniciens experts. Étalé sur 42 heures, le programme couvre la prise en main des principaux outils du marché (Claude, ChatGPT, Gemini), la création d'assistants IA adaptés à son métier, et les bonnes pratiques pour utiliser l'IA sans exposer les données de son entreprise.
Quelques infos sur la formation :
Durée : 42 heures, sur 6 jours à temps plein ou 6 semaines à temps partiel
Prérequis : aucun, accessible aux débutants
Prix : 1 500 euros, éligible au CPF
Format : à distance ou en présentiel, sur l'un des 17 campus
Ce qui distingue cette formation des autres offres du secteur :
Un apprentissage multi-outils plutôt que la maîtrise d'un seul assistant, pour savoir lequel mobiliser selon la tâche
Un projet final concret, un assistant IA répondant à un vrai besoin métier
Des formateurs qui exercent leur activité en parallèle de l'enseignement
A noter que Jedha a été élue meilleur bootcamp en IA et Machine Learning 2026 par Course Report, et forme aux métiers de la tech depuis 2017, avec plus de 4 000 alumni et une note moyenne de 4,9/5. Un gage de sérieux pour celles et ceux qui ne veulent pas transiger sur la qualité.
2. Les MOOCs des grandes plateformes (Coursera, edX, Udemy)
Pour une approche plus autonome et souvent moins coûteuse, les grandes plateformes de MOOCs proposent de nombreux cours sur l'IA générative, du niveau découverte jusqu'à des modules plus techniques. Coursera héberge notamment des cours conçus par DeepLearning.AI, la structure fondée par Andrew Ng, qui fait référence sur les sujets d'intelligence artificielle.
Le principal avantage de ce format, c’est la flexibilité totale et un coût d'entrée généralement assez faible. Le revers de la médaille : la plupart des accompagnements sont peu personnalisés, et le taux de complétion historiquement bas des MOOCs témoigne de la difficulté à maintenir de la motivation sur la durée, lorsqu’elle n’est pas soutenue par un cadre structurant.
3. Les formations universitaires
En phase avec leur époque, plusieurs universités françaises ont intégré des modules ou des diplômes universitaires dédiés à l'IA générative, dans le cadre de la formation continue. Ces parcours ont l'avantage de bénéficier d’une reconnaissance académique et d'un contenu généralement plus approfondi sur les fondements théoriques. Cependant, ils s'adressent davantage à un public souhaitant une compréhension approfondie qu'à des professionnels à la recherche d'une montée en compétence rapide et opérationnelle.
4. Les certifications proposées par les éditeurs
OpenAI, Google et Microsoft, et la plupart des autres acteurs du monde de l’IA, proposent chacun des parcours de certification ou des programmes de formation autour de leurs outils respectifs. Ces certifications ont l'intérêt d'être directement alignées sur les fonctionnalités des produits, et peuvent constituer un plus sur un CV pour des postes où un outil spécifique est central. Elles restent en revanche centrées sur un écosystème donné, et moins adaptées à qui cherche une vision transversale des usages de l'IA générative.
Pour résumer : trouver une formation en IA générative
L'IA générative transforme la plupart des métiers du tertiaire, et une vraie montée en compétence fait la différence par rapport à un usage superficiel des outils. Le choix d'une formation dépend avant tout de l'objectif visé : usage professionnel quotidien, culture générale, ou spécialisation technique.
Dans ce cadre, Jedha propose une formation de 42 heures pensée pour les professionnels en poste, avec un apprentissage multi-outils et un projet final concret, éligible au CPF. De leur côté, les MOOCs, comme Coursera, edX, Udemy, conviennent pour une découverte flexible et peu coûteuse, à condition d'être autonome et très rigoureux. Enfin, les formations universitaires et les certifications proposées par les éditeurs (OpenAI, Google, Microsoft) répondent à des besoins plus spécifiques, académiques ou techniques, et davantage ciblés sur les outils-maison.
Sur Bluesky, John Mueller a répondu à un internaute, qui signalait qu'une fiche produit affichait « rupture de stock » sur la page alors que le HTML serveur et les données structurées indiquaient « disponible ». John Mueller déconseille d'avoir des métadonnées contradictoires car cela « complique le travail pour déterminer ce qui est pertinent ». Il suggère une alternative : passer par un flux (feed) plutôt que par les métadonnées on-page.
Interrogé sur la source que Google privilégie en cas de conflit (feed vs données structurées), il répond qu'il n'existe aucun ordre de priorité publié par Google pour la réconciliation des métadonnées. C’est pour cette raison qu’il conseil de corriger le conflit plutôt que d'essayer de deviner quelle source Google retiendra.
John Mueller évoque aussi le cas similaire des dates (date visible sur la page, dateModified en données structurées, lastmod dans le sitemap), en précisant que ces valeurs peuvent avoir des poids différents et évoluer dans le temps, d'où l'importance de rendre la bonne valeur facile à identifier.
La disponibilité d'un produit peut facilement diverger entre le HTML initial, le DOM après rendu JS, et le flux Merchant Center. Comme Google ne communique pas de hiérarchie officielle, aligner ces trois sources est plus fiable que de chercher à deviner laquelle prévaut. En somme : faites la chasse aux incohérences, au lieu de perdre votre temps à tester.
95% des utilisateurs de ChatGPT continuent d'utiliser Google en parallèle, et la recherche classique pèse encore environ cinq fois plus que l'ensemble des chatbots IA réunis (3,3 milliards de visiteurs mensuels contre 655 millions).
Seulement 6,8% des réponses de ChatGPT aux États-Unis contenaient un lien externe en mai 2026, un chiffre en forte hausse sur un an mais qui reste minoritaire.
65% des URL citées par ChatGPT pointent vers des pages profondes (deux ou trois niveaux d'arborescence), alors que 58,8% du trafic de référencement généré par l'IA atterrit... sur la page d'accueil. Les pages citées et les pages cliquées ne sont donc presque jamais les mêmes.
La visibilité IA varie fortement selon les secteurs et les plateformes : ChatGPT est plutôt utilisé pour des recherches grand public (restaurants, santé, mode), Claude attire massivement les profils universitaires et étudiants, et Gemini surperforme sur les contenus techniques et matériel.
Les utilisateurs de ChatGPT sont restés sur Google
Le rapport Similarweb, basé sur des données collectées entre mars et mai 2026, part d'un constat simple : l'immense majorité des utilisateurs de ChatGPT n'ont pas quitté Google, ils ont ajouté un outil supplémentaire à leurs habitudes. Sur 494 millions d'utilisateurs de ChatGPT suivis, 461 millions utilisent aussi Google sur la même période. Même en tenant compte d'une croissance de 57% en un an du côté des chatbots IA, la recherche traditionnelle reste très largement dominante en volume.
ChatGPT perd du terrain dans le domaine de l'IA, au profit de Google Gemini - Source : Similarweb
Du côté des citations, la progression est réelle mais reste marginale en proportion. Le taux de réponses ChatGPT contenant un lien externe est passé d'environ 1% à 6,8% en un an aux États-Unis, une multiplication par cinq qui traduit un changement de fond, mais qui signifie aussi que 93 réponses sur 100 ne renvoient encore vers aucun site.
Le point le plus utile du rapport concerne le décalage entre les pages citées par l'IA et les pages effectivement visitées par les internautes. Aleyda Solis (Orainti) souligne que les deux populations d'URL se recoupent très peu : l'IA cite des pages profondes qui servent de preuve à sa réponse, mais le trafic humain atterrit majoritairement sur la page d'accueil. Une conséquence concrète pour le suivi de performance : mesurer uniquement le taux de citation ne dit rien de ce qui se passe une fois que l'internaute clique réellement.
L’IA générative n’est pas seulement un effet de mode
En parallèle, plusieurs signaux indiquent que l'adoption des IA génératives dépasse le simple effet de mode. Les visites mensuelles sur les plateformes IA ont atteint 9,5 milliards entre juin 2025 et mai 2026 (+70% sur un an), et la moitié des utilisateurs a désormais plus de 35 ans, contre 61% de moins de 34 ans il y a deux ans seulement. Meta AI illustre aussi cette dynamique : ses utilisateurs actifs mensuels sont passés de 384 millions en septembre 2024 à 1,2 milliard en mars 2026, sans exister comme destination autonome mais en s'appuyant sur Instagram, Facebook, WhatsApp et Messenger.
Enfin, la visibilité dans les réponses IA varie fortement d'une marque à l'autre au sein d'un même secteur, comme le montre l'écart entre CeraVe (indice de visibilité de 100) et NYX Cosmetics (19) dans la beauté. Kevin Indig (Growth Memo) recommande de raisonner en part de voix plutôt qu'en score absolu, une approche jugée plus pertinente dans un système par nature aléatoire comme les réponses génératives.
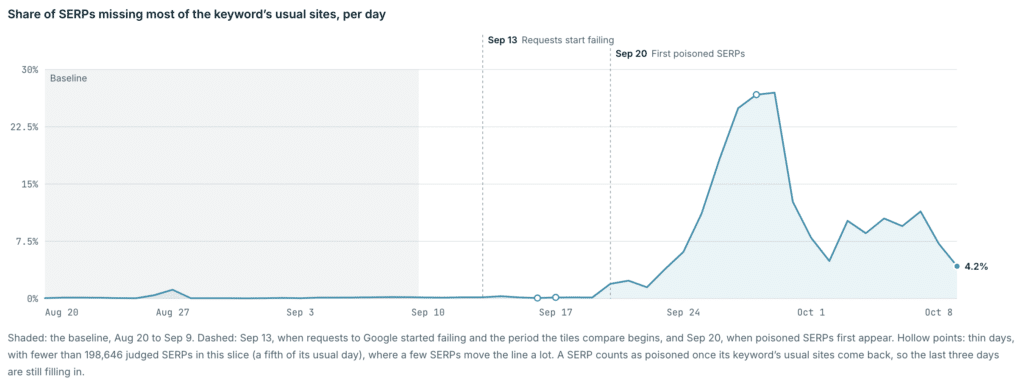


 Au moment où nous écrivons ces lignes, votre fichier


 "Lorsque les lecteurs sélectionnent votre site, vos contenus peuvent s'afficher plus souvent dans des fonctionnalités comme À la une, Aperçus IA et Mode IA." https://t.co/IYMCqHwvEg



 Mardi 22 septembre 2026
 9h30 : Serge-Jérome Laverny : "
 10h30 : Guillaume Pracht : "Google Search et IA : quels leviers méritent vraiment votre budget ?"
 11h30 : Thomas Casiez : "
 14h00 - Dorothée Raffray : "
 15h00 : Kate Herchuez et Marilou Rudel : "GEO & Reddit : comment émerger sur ces plateformes ?"


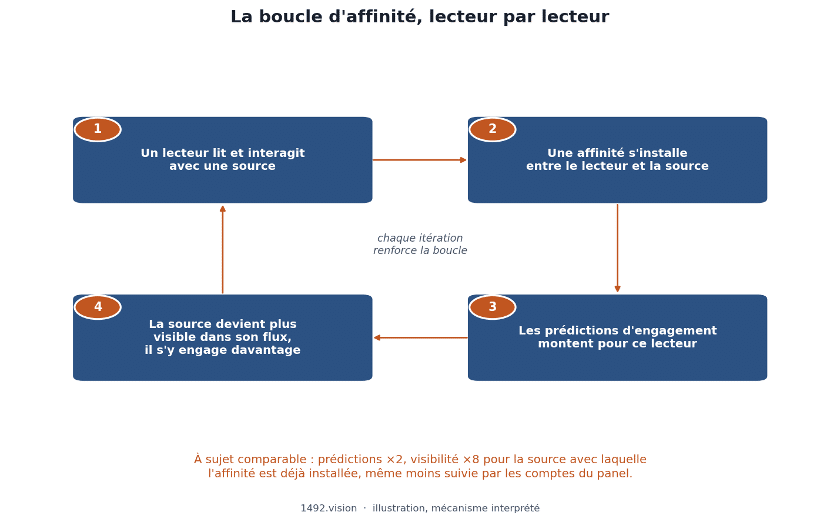


 Ce qu'on a aimé :