Google a annoncé le 15 octobre 2026 davantage de liens dans AI Mode et les Aperçus IA, placés plus haut dans les réponses, avec un ou deux liens mis en avant pour certaines requêtes.
Les carrousels d'articles d'actualité sont étendus à de nouvelles régions et langues, et Google affirme que l'usage de la fonction « Sources préférées » a été multiplié par plus de sept.
Selon Chartbeat, cité par Le Figaro, les sites d'information ont perdu 40 % de leur trafic venu de Google entre juillet 2025 et juillet 2026, une période marquée par l'essor des résumés IA.
Google ne fournit toujours pas de données de clics issues de ses réponses IA dans ses rapports, ce qui empêche les éditeurs et référenceurs de mesurer l'effet concret de ces nouveaux formats de liens.
Google remonte et multiplie les liens dans ses réponses IA
Pour rappel, les AI Overviews génèrent un résumé en tête des résultats classiques, tandis qu’AI Mode ouvre une interface conversationnelle séparée, avec une réponse plus développée. Lancés respectivement en mai 2024 et en mars 2025 aux États-Unis, ils sont arrivés en France sous les noms d’Aperçus IA et de Mode IA.
Premier changement : les liens contextuels, insérés directement dans le texte généré, deviennent plus nombreux. Google les placera aussi « plus fréquemment » dans la partie haute de la réponse, là où l’attention de l’internaute est la plus forte.
Deuxième changement : pour certaines requêtes, Google affichera un ou deux liens vers ce qu’il considère comme la « bonne page web ». Search Engine Roundtable précise que ce traitement est réservé aux requêtes qui le justifient, sans que Google ne détaille les critères de sélection.
Carrousels, articles connexes et profils : le détail des autres nouveautés
Des carrousels d’actualité dans plus de pays
Google étend ses carrousels d’articles liés à l’actualité. Il s’agit de vignettes affichées sous le résumé, avec le titre de l’article et une image d’illustration. Le Figaro évoque une extension « au monde entier », quand Search Engine Roundtable parle plus prudemment de nouvelles régions et langues.
Selon les informations partagées, ces carrousels privilégieront les articles publiés par des sources identifiées par l’internaute. Une variante reprendra des publications issues des réseaux sociaux ou de forums lorsque la requête porte sur des avis ou des points de vue.
La fonction « Sources préférées » en forte hausse
Google affirme que le nombre de personnes utilisant les « Sources préférées » a été multiplié par plus de sept. Pour rappel, cette fonction permet à l’internaute de désigner les médias qu’il souhaite voir apparaître en priorité. Il y a quelques jours, Google a d'ailleurs commencé à envoyer des informations sur ces sources préférées. Le chiffre est déclaratif : Google ne communique ni la période de référence, ni le volume de départ.
Des articles connexes plus visibles
Les liens affichés en fin de réponse, destinés aux internautes qui veulent approfondir, bénéficient d’un design plus visible, avec des vignettes, selon les captures publiées.
Des profils de créateurs qui renvoient d’abord vers Google
Dernier test en cours : sur les vidéos affichées dans AI Mode, le nom du créateur ou de l’éditeur est désormais cliquable. Mais comme le souligne Barry Schwartz, ce lien mène d’abord à une page de profil hébergée par Google, et non au site ou à la chaîne du créateur. Autrement dit, ce nouveau lien garde l’internaute dans l’écosystème de Google avant tout clic sortant.
Les données de clics restent absentes des rapports
C’est le principal angle de critique de Barry Schwartz. Google répète que ces évolutions visent un design « plus cliquable », mais ne fournit toujours aucune donnée de clics dans ses rapports de performance dédiés à l’IA.
Interrogé par le journaliste, Google a répondu qu’il continuait d’échanger avec les propriétaires de sites pour identifier les indicateurs les plus utiles, et qu’il ajouterait « des indicateurs supplémentaires au fil du temps ». Aucun calendrier, aucun engagement sur les clics.
Rappelons que le clic est la métrique que les éditeurs réclament en priorité, et qu’elle constitue aussi l’indicateur central de Google Ads. Le contraste est difficile à ignorer : Google mesure précisément les clics quand il les vend, mais ne les partage pas quand il s’agit d’évaluer le trafic qu’il renvoie gratuitement.
Barry Schwartz qualifie par ailleurs cette annonce de nouvelle itération parmi de nombreuses autres, avec le sentiment que les tentatives précédentes pour générer des clics depuis la recherche IA n’ont pas donné les résultats escomptés.
Un énième ajustement face à l’érosion du trafic des éditeurs
Le contexte chiffré éclaire la portée de l’annonce. Lors de la présentation des résultats du deuxième trimestre 2025, Sundar Pichai, PDG d’Alphabet, indiquait que les Aperçus IA comptaient plus de deux milliards d’utilisateurs mensuels dans plus de 200 pays, rappelle Le Figaro.
Dans le même temps, plusieurs études ont établi que les résumés IA réduisent nettement les clics vers les liens proposés. Le Figaro cite un rapport de Chartbeat selon lequel les sites d’information ont perdu 40 % de leur trafic venu de Google entre juillet 2025 et juillet 2026. D’autres estimations évoquent des baisses comprises entre 30 % et 60 % selon les sites.
En France, le sujet a pris une dimension juridique. En août, l’Alliance de la presse d’information générale (Apig), qui représente les quotidiens français, a saisi l’Autorité de la concurrence. Elle estime que les résumés IA contreviennent aux accords conclus en 2022 entre Google et les éditeurs, dans le cadre des droits voisins. Pour rappel, les droits voisins encadrent la rémunération due aux éditeurs de presse pour la réutilisation de leurs contenus par les plateformes.
Un geste qui sert d’abord l’intérêt de Google
Le timing de l’annonce n’est pas anodin. Face à des éditeurs qui dénoncent publiquement leurs pertes et à une procédure ouverte devant l’Autorité de la concurrence, rendre les liens plus visibles permet à Google d’afficher une bonne volonté, sans fournir la donnée qui permettrait de la vérifier.
Le discours n’est pas nouveau. À chaque vague de critiques depuis le lancement des AI Overviews, Google a répondu par des ajustements d’interface présentés comme favorables aux clics.
Il existe aussi un intérêt plus structurel. Les réponses générées par Google reposent sur les contenus publiés par les sites. Si les éditeurs perdent leur modèle économique fondé sur le trafic et la publicité, ils risquent de produire moins ou de bloquer les robots d’exploration. Sans contenus frais, l’IA de Google n’a plus de matière à synthétiser, en particulier sur l’actualité. Maintenir un minimum de trafic sortant revient donc à protéger la source d’approvisionnement de ses propres réponses.
D'après Nozzle, 8 % des SERP collectées depuis le 13 septembre 2026 sont « empoisonnées », contre 0,17 % entre le 20 août et le 9 septembre, avec un pic à un quart des pages du 27 au 29 septembre.
Ces pages s'affichent sans erreur ni captcha, mais leurs résultats organiques ne conservent que 20,7 % des sites habituels de la requête, au profit notamment de Reddit, Facebook et LinkedIn.
Un site suivi sort du top 10 sur 58,6 % des SERP empoisonnées, mais 77,9 % d'entre elles retrouvent leurs sites habituels dans les trois jours qui suivent.
Avant de signaler une chute de positions à un client, Rémy Blanchard (Foxglove) recommande de la confronter à la Search Console et à l'historique des sites habituels du mot-clé sur plusieurs semaines.
Nozzle mesure 8 % de SERP « empoisonnées » depuis septembre
L’étude a été publiée le 10 octobre 2026 par Nozzle, un outil de suivi de positions (ou rank tracker, qui relève régulièrement la place d’un site dans Google pour une liste de mots-clés). Elle s’appuie sur les données collectées jusqu’au 9 octobre dans 49 pays, sur desktop, iPhone et Android. Sur les 27,5 millions de pages de résultats collectées depuis le 13 septembre, 17,8 millions ont pu être analysées. Parmi elles, 8 % étaient « empoisonnées ». Sur la période de référence, du 20 août au 9 septembre, le taux n’était que de 0,17 %.
Nozzle décrit une chronologie :
13 septembre : les requêtes envoyées à Google commencent à échouer en masse, et moins de SERP parviennent aux outils pendant deux semaines.
20 septembre : les premières SERP empoisonnées apparaissent parmi les requêtes qui aboutissent.
27 au 29 septembre : le phénomène culmine, avec un quart des SERP touchées.
Depuis le 1er octobre : le taux oscille entre 5 et 11 % par jour.
Pour qualifier une page d’empoisonnée, Nozzle définit d’abord les « sites habituels » de chaque mot-clé : ceux présents dans son top 10 sur au moins 60 % des SERP de la période de référence. Une SERP est jugée empoisonnée quand moins de la moitié de ces sites y figurent, sur l’ensemble de ses pages, et qu’ils réapparaissent ensuite. Nozzle précise que les derniers jours de ses courbes sont encore incomplets, puisqu’une SERP n’est classée empoisonnée qu’une fois les sites habituels revenus.
Zone ombrée : période de référence, du 20 août au 9 septembre. Lignes en pointillés : le 13 septembre, date à laquelle les requêtes adressées à Google ont commencé à échouer et début de la période couverte par les graphiques, et le 20 septembre, date à laquelle les premières pages de résultats (SERP) « empoisonnées » sont apparues. Points vides : jours « creux » comptant moins de 198 646 SERP analysées (soit un cinquième du volume quotidien habituel) ; dans ces cas-là, quelques SERP suffisent à faire varier significativement la courbe. Une SERP est considérée comme « empoisonnée » dès lors que les sites qui y figurent habituellement réapparaissent ; par conséquent, les données relatives aux trois derniers jours sont encore en cours de consolidation. - Source : Nozzle
Des pages normales en apparence, mais des résultats remplacés
Ce qui rend le phénomène particulièrement gênant, c’est qu’il ne laisse aucune trace visible. La page renvoyée n’affiche ni message d’erreur ni captcha (le test qui demande de prouver qu’on n’est pas un robot). Elle reprend le même gabarit et, selon Nozzle, la même version du frontend de Google qu’une page normale. Rien dans le code HTML ne la signale.
Les résultats, eux, ont changé. Nozzle illustre le phénomène avec la requête « white label local seo », collectée aux États-Unis le 4 puis le 7 octobre. La première SERP listait des prestataires SEO en marque blanche. Trois jours plus tard, les 9 sites de la page 1 avaient tous disparu, remplacés entre autres par un outil de développement WordPress, un steakhouse de Jackson Hole, un annuaire des services de santé des comtés et USA.gov. D’après Nozzle, Google a pris le mot « local » au pied de la lettre, et la pagination est passée de 10 pages à 3.
À l’échelle de l’étude, la part des sites conservés d’une SERP à l’autre s’effondre dans plusieurs zones de la page :
Résultats organiques : 20,7 % des sites conservés sur une SERP empoisonnée, contre 88,5 % sur la période de référence.
« Autres questions posées » (People also ask) : 46,9 %, contre 87,4 %.
« Recherches associées » (People also search for) : 30,7 %, contre 87,9 %.
Sources citées dans les AI Overviews : 42,3 %, contre 68,8 %.
Pack local : 60,5 %, contre 85,8 %.
Seules les zones payantes résistent. Les résultats Shopping conservent 92,2 % de leurs éléments (contre 92,8 %) et les annonces en gardent même davantage qu’à l’ordinaire, 83,7 % contre 70,6 %. La composition des pages change aussi : l’AI Overview n’apparaît plus que sur 34,9 % des SERP empoisonnées, contre 54,2 % habituellement, tandis que les blocs d’images passent de 23,0 % à 44,2 %. Sur desktop, pour les mots-clés qui comptent d’ordinaire au moins 8 pages de résultats, 50,9 % des SERP empoisonnées s’arrêtent à la page 4 ou avant, contre 0,2 % en temps normal.
Les réseaux sociaux et les forums prennent la place
Nozzle a comparé la présence de certains sites dans le top 10 des SERP empoisonnées et des autres SERP des mêmes mots-clés :
Reddit : de 20,8 % à 28,8 %, la plus forte hausse.
Facebook : de 28,3 % à 33,8 %.
LinkedIn : de 6,2 % à 9,3 %.
Instagram : de 9,6 % à 12,1 %.
Quora : de 5,3 % à 6,7 %.
YouTube, Yelp et MapQuest : en recul, respectivement de 16,3 % à 13,9 %, de 12,9 % à 11,1 % et de 4,2 % à 3,5 %.
Sur les mots-clés américains, 14,2 % des SERP empoisonnées affichent dans leur top 10 un site sous extension nationale étrangère (un .ca ou un .co.uk, par exemple), contre 6,1 % des autres.
Le site suivi disparaît du top 10
Conséquence directe pour les reportings : sur les mots-clés où le site d’un projet fait partie des sites habituels, ce site est absent du top 10 sur 58,6 % des SERP empoisonnées. Ce taux était de 2,7 % sur la période de référence et de 10,2 % sur les autres SERP des mêmes mots-clés depuis le 13 septembre. Un rank tracker enregistre donc ces relevés comme une chute de positions.
L’épisode est généralement bref. Selon Nozzle, 80 % des « épisodes » d’empoisonnement ne concernent qu’une seule SERP, 15 % en touchent deux et 5 % trois ou plus. La SERP suivante retrouve ses sites habituels dans 55,9 % des cas, et 77,9 % des SERP empoisonnées sont rentrées dans l’ordre sous trois jours (deux jours en valeur médiane).
Pays, secteurs et types de requêtes ne sont pas touchés de la même façon
La France relativement épargnée, la Belgique et la Suisse nettement plus
Parmi les grands marchés, l’Australie (11,5 %), l’Inde (10,9 %) et le Canada (10,5 %) sont les plus touchés, devant les États-Unis (8,5 %). L’Allemagne, la France et l’Espagne se situent entre 3,4 et 4,3 %, et le Royaume-Uni ferme la marche à 3,0 %.
Les voisins francophones sont bien plus exposés. Nozzle relève 13,2 % de SERP empoisonnées en Belgique et 12,8 % en Suisse, ainsi que 18,8 % en Autriche. L’Afrique du Sud (18,4 %), les Émirats arabes unis (14,4 %), la Nouvelle-Zélande (13,8 %), la Norvège (13,1 %) et l’Arabie saoudite (12,9 %) dépassent eux aussi les 12 %. Le type d’appareil, en revanche, pèse peu : 7,7 % sur desktop, 8,3 % sur iPhone et 7,1 % sur Android.
Nozzle note aussi que le taux dépend du chemin emprunté par la requête pour atteindre Google. Entre le 30 septembre et le 9 octobre, l’une de ses voies de collecte renvoyait 1 à 7 % de SERP empoisonnées, une autre 9 à 30 %.
Le juridique et les services à domicile en tête aux États-Unis
Sur les SERP américaines, le secteur juridique est le plus touché depuis le 13 septembre (15,9 %), devant les services à domicile (12,7 %), les mariages (11,6 %) et le transport (11,0 %). L’animalerie (4,3 %) et l’automobile (5,3 %) sont les moins concernées. Tous les secteurs ont atteint leur pic entre le 27 et le 29 septembre, avec un maximum de 51,3 % pour les SERP juridiques le 27 septembre.
Les requêtes « près de oi » et la longue traîne plus exposées
Selon le type de recherche, les écarts sont les suivants :
Requêtes « near me » (près de moi) : 11,4 % empoisonnées, contre 7,8 % pour le reste.
Longue traîne : 9,4 % pour les expressions recherchées moins de 100 fois par mois, contre 6,1 à 7,1 % au-delà.
Requêtes de marque : 5,3 % pour les requêtes les plus navigationnelles, le taux le plus bas.
Ciblage local : aucun effet propre. Une même expression suivie à l’échelle nationale et locale, dans le même pays et sur le même appareil, affiche 7,5 % et 7,4 % sur 21 508 paires comparées.
Google vise les scrapers IA, les outils SEO sont pris dans les filets
Nozzle présente le phénomène comme une réponse de Google au scraping (l’extraction automatisée de données) et au grounding, c’est-à-dire la collecte massive de ses résultats pour alimenter les réponses d’IA. Les rank trackers, qui collectent les SERP de la même manière, en feraient les frais. L’étude insiste sur la logique de l’approche : une requête refusée pousse le robot à réessayer, alors qu’une page empoisonnée est enregistrée comme valide.
Derek Perkins a détaillé à Barry Schwartz ce qu’il décrit comme une stratégie de Google en trois volets :
Blocage d’adresses IP à très grande échelle, visant notamment les grands réseaux de proxys résidentiels (des adresses IP de particuliers utilisées pour masquer des requêtes automatisées).
Hausse nette de l’utilisation des captchas.
Injection de données erronées dans les SERP jugées suspectes.
Barry Schwartz replace ces mesures dans une série d’initiatives antérieures. En juillet, Google a commencé à tester des redirections « goto » dans ses résultats pour mieux identifier les scrapers. Il évoque aussi le conflit entre Google et SerpApi, un fournisseur d’API de collecte de SERP, ainsi que la fin du paramètre num=100 en 2025, qui permettait d’afficher 100 résultats sur une seule page. Comme Nozzle, il estime que Google ne cible pas directement les outils SEO, mais les robots IA et SerpApi. Cette lecture reste une interprétation : aucune des sources ne cite de déclaration de Google sur le sujet.
Monitorank date le phénomène à mai
Le 13 octobre, Monitorank a réagi sur X en affirmant que le phénomène a débuté le 15 mai 2026. L’outil français décrit des résultats YouTube envahissant les pages 4 et 5, des sites disparaissant du top 10, voire un top 10 entièrement différent. Selon Monitorank, Google détecte comme robot une requête venant d’une adresse IP étrangère (via un VPN, par exemple), en navigation privée, qui demande des résultats français avec le paramètre gl=fr. L’éditeur indique avoir corrigé le problème rapidement, et signale une mise à jour similaire de Google le 25 septembre.
Ce calendrier diffère de celui de Nozzle, qui ne relève que 0,17 % de SERP empoisonnées sur sa période de référence (20 août au 9 septembre). Les deux observations ne portent pas forcément sur le même mécanisme. Monitorank affirme par ailleurs que son API de scraping, SEMScraper, n’est pas affectée, et dit avoir développé une application interne comparant cinq API concurrentes à la sienne et à un navigateur Chrome connecté servant de référence. Ces affirmations sont déclaratives et n’ont pas été vérifiées de façon indépendante.
Les éditeurs d’outils réagissent en ordre dispersé
Barry Schwartz rapporte que plusieurs outils ont publié des avertissements sur leur site, leur blog ou dans leur interface : Sistrix, DataForSEO (sur sa page de statut), Advanced Web Rankings et Morningscore. SE Ranking a indiqué le 12 octobre que des positions manquaient pour certains mots-clés sur Google, tout en assurant que l’essentiel du problème était résolu.
Le journaliste relève toutefois que beaucoup d’éditeurs n’ont pas répondu à ses sollicitations, et que certains ont confondu les redirections « goto », qu’il juge faciles à gérer pour les outils, avec les problèmes apparus en septembre. C’est l’injection de fausses données qui l’inquiète le plus : il estime que la plupart des outils ne la détecteront pas rapidement et pourront croire que tout fonctionne alors que leurs relevés sont faussés.
Comment distinguer un empoisonnement d’une vraie chute de positions
Nozzle liste plusieurs indices pour séparer un problème de données d’une baisse réelle :
Comparer le résultat à l’historique du mot-clé, et pas seulement à la veille. La SERP de la veille peut elle-même avoir été empoisonnée. La référence la plus fiable reste l’ensemble des sites habituels de page 1 sur les semaines précédentes.
Attendre quelques jours. Quatre épisodes sur cinq ne concernent qu’une SERP, et la plupart se résorbent sous trois jours. Une vraie perte de positions, elle, persiste.
Observer la structure de la page. Les SERP empoisonnées affichent en moyenne moins souvent un AI Overview et des recherches associées, davantage de blocs d’images et de réseaux sociaux, et une pagination plus courte. Nozzle prévient qu’aucun de ces signaux n’est fiable isolément.
Croiser avec la Search Console. Si un site « disparaît » alors que la Search Console continue d’enregistrer impressions et clics, il n’a rien perdu.
Rémy Blanchard en tire une règle de travail pour les agences : une chute d’un jour dans un reporting ne constitue pas un diagnostic. Avant de la signaler au client, il la compare à la Search Console et à l’historique des sites habituels du mot-clé sur plusieurs semaines. Si les impressions n’ont pas bougé, il considère qu’il ne s’est rien passé. Il conseille aussi, aux agences dont un client a paniqué fin septembre après une disparition de 24 h du top 10, de vérifier cette piste avant de lancer un audit.
La Search Console a toutefois ses limites : elle ne fournit ni données de clics ni données de requêtes pour la recherche générative, comme les AI Overviews et l’AI Mode. Sur ces surfaces, les professionnels restent dépendants d’outils tiers dont les relevés sont précisément ceux que Google cherche désormais à perturber.
Notre livre blanc fait le point sur 17 sujets GEO de l'année, avec dix enseignements tirés des études et sept questions qui divisent encore.
Il s'appuie sur 47 études et 26 prises de parole d'experts publiées entre janvier et octobre 2026, chacune relue sur sa source.
Les fondamentaux du SEO comptent plus que jamais, alors que la discipline n'a jamais évolué aussi vite.
Le GEO est-il un nouveau métier ? Ou du SEO rebaptisé ?
Réponse : la question divise
Google a indiqué sa position le 15 mai 2026 : optimiser pour la recherche IA, "c'est toujours du SEO" . La réponse nous étonne très peu mais les mesures lui donnent en partie raison : plus une page est haut placée, plus l'AI Overview la cite. Une page en position 1 est citée dans 24,9 % des cas, contre 10,2 % en position 10, selon Conductor.
Une partie des experts conteste pourtant.
Pour Mike King (iPullRank), "Dire que c'est juste du SEO est naïf", et cette formule apporte aux équipes "plus de périmètre, le même budget, aucune autorité supplémentaire". David Groult (Noiise) le résume ainsi : "GEO = le SEO x la communication". Entre les deux, Ethan Smith (Graphite) estime qu' "il y a des différences, mais leur ampleur a été exagérée".
ChatGPT lit-il vraiment les pages qu'il cite ?
Réponse : presque jamais en entier
Sur plus de 1 200 réponses de ChatGPT analysées par Resoneo, à peine plus d'une page récupérée sur 80 est réellement ouverte, et seulement en mode thinking. Le reste du temps, ChatGPT s'appuie sur un extrait de 202 caractères fourni par son index, qui contient le H1 dans 83,6 % des pages citées qui en ont un.
Quand le texte de la page est utilisé, c'est surtout son début : sur 18 012 citations de ChatGPT retrouvées dans leur page, Kevin Indig établit que 44,2 % viennent des 30 premiers pour cent du texte.
10 enseignements & 7 questions non tranchées
Abondance.com a condensé 47 études et 26 prises de parole d'experts. L'objectif : faire le point des infos sûres et des sujets qui font encore débat.
La mesure de la visibilité dans les IA est-elle fiable ?
Réponse : la question divise
Le constat de départ, lui, est partagé : les réponses changent sans cesse. Pour un même prompt, les sources citées ne se recoupent d'un jour à l'autre qu'à 34 à 42 % en moyenne, selon l'université de Saint-Gall. Et selon SparkToro, il y a moins d'une chance sur 100 d'obtenir deux fois la même liste de marques en interrogeant 100 fois ChatGPT ou l'IA de Google.
Pour Rand Fishkin (SparkToro), on peut pourtant suivre la fréquence à laquelle une marque apparaît "avec rigueur statistique", à condition de répéter les prompts assez de fois. Mais "le suivi de positions, en revanche, c'est du grand n'importe quoi".
D'autres jugent les outils pas encore prêts : "Soyons clairs : aucun outil GEO du marché n'est actuellement suffisamment fiable pour être employé seul", tranche Michael Beresin (Cosmo5). Kevin Indig, lui, résume : "Je pense que le suivi de prompts tient plus du sondage que du suivi de positions".
Les bots IA vont-ils là où vous le souhaitez ?
Réponse : pas toujours
Quand ils visitent une page à la demande d'un utilisateur, les robots de ChatGPT, Claude et Gemini n'exécutent pas le JavaScript : ce qu'une page n'affiche que par script leur échappe, selon les tests de Resoneo.
Le fichier llms.txt, proposé pour guider les IA, n'est pas lu non plus : sur les journaux de six sites analysés par Daniel Roch (SeoMix), aucun des 33 092 passages de robots des IA relevés en avril et mai ne l'a appelé.
Et certains sites bloquent les IA sans le savoir. Sur 2 096 grands sites testés par HasData, 5,5 % bloquent GPTBot, le robot d'entraînement d'OpenAI, au niveau du CDN ou du pare-feu, alors que leur robots.txt l'autorise.
Vaut-il mieux un backlink ou une mention ?
Réponse : la question divise et aucune étude ne tranche
Plusieurs experts misent sur la mention :
"Le lien garde sa valeur pour Google, mais c'est la mention, la marque contextualisée dans un site ou média tiers, qui fait basculer la mention IA en volume", estime Julien Bismuth (Getfluence).
"Au bout du compte, ce sont les mentions, idéalement dans le bon contexte", abonde Kevin Indig.
Olivier de Segonzac (Resoneo) reconnaît de son côté l'impact (indirect) du netlinking sur les citations des moteurs conversationnels.
Aucune étude publiée en 2026 ne mesure les deux sur un même corpus.
Celles qui en mesurent un seul ne tranchent pas : sur 479 pages de finance citées par ChatGPT, dix fois plus de backlinks vont de pair avec environ 10 % de citations en plus, une simple corrélation selon Greenflag Digital. Sur environ 5 millions d'URL citées par quatre moteurs, l'autorité de domaine ne prédit rien, selon Surfer.
Combien de temps reste-t-on cité ?
Réponse : peu de temps
Profound a suivi 883 000 pages pendant un an sur sept moteurs : une page citée perd en médiane la moitié de sa part de citation 11 jours après son pic.
Sur quatre moteurs chinois, des chercheurs mesurent une demi-vie d'environ 39 jours pour les mots-clés très liés à l'actualité, et de 68 jours pour les autres. Une date de mise à jour récente aide une page à être citée en premier, selon une expérience de Sprinklr.
17 sujets phares de 2026 rassemblés dans un livre blanc inédit
Notre livre blanc "GEO : ce que 2026 nous a appris" rassemble les sujets qui ont fait 2026 :
L'IA fait-elle baisser le trafic des sites ?
Une marque inconnue des modèles peut-elle être citée ?
Faut-il découper ses contenus en petits blocs ?
Peut-on faire citer n'importe quoi à une IA ?
Et 13 autres sujets chauds !
A lire ici :
10 enseignements & 7 questions non tranchées
Abondance.com a condensé 47 études et 26 prises de parole d'experts. L'objectif : faire le point des infos sûres et des sujets qui font encore débat.
Pierre Sauvé distingue la « présence » d'une marque dans les poids d'un modèle, mesurée par log-probabilités sur des modèles ouverts, de sa « citabilité », qui dépend de la recherche web effectuée au moment de répondre.
Sur son panel, l'accord entre le classement des marques connues des modèles ouverts et celui des marques citées par ChatGPT et Gemini n'est que de 0,1, sur une échelle allant de 0 à 1.
À notoriété web égale, avoir une page Wikipédia ou une forte présence sur Reddit ne produit pas d'avantage mesurable sur la présence : les paires comparées se répartissent quasiment à parts égales.
Le consultant recommande des audits GEO avec passages répétés, appels dans l'interface plutôt que par l'API, socle daté et deux indicateurs distincts, présence et citation, plutôt qu'un score unique.
Trois passages dans ChatGPT donnent trois listes de marques différentes
L’étude est née d’une remarque d'un client. Pierre Sauvé raconte avoir travaillé pour une plateforme de sondage dont l’équipe, plutôt rigoureuse, constatait que les taux de visibilité IA variaient d’un outil à l’autre. Il a donc lancé trois fois la même requête dans ChatGPT (« quelle plateforme de sondage propose des quotas et redressement ? »), dans des conditions d’utilisation classiques, le même jour et à quelques heures d’intervalle. Résultat : trois listes différentes. Une seule marque, Symbial, apparaît dans deux réponses, et aucune n’apparaît dans les trois. Le consultant parle de « roulette russe ».
Il a ensuite sollicité Qwairy, outil de suivi de la visibilité dans les LLM, qui lui a fourni gracieusement des données sur un panel plus large. Les marques y sont détectées par leur nom mais aussi par leur domaine. Les résultats confirment l’instabilité :
Sur ChatGPT : 42 % des marques ne sont vues qu’une seule fois sur trois passages, et seulement 37 % apparaissent aux trois.
Sur Gemini : 55 % des marques ne sont vues qu’une seule fois sur trois passages.
Pour Pierre Sauvé, un audit GEO fondé sur un passage unique contient donc une part d’aléa importante. Il précise que ces passages ont été réalisés sur une période courte et qu’il prévoit de les renouveler dans un mois ou deux.
Présence et citabilité relèvent de deux couches distinctes
Le consultant distingue deux raisons pour lesquelles un LLM cite une marque :
La présence : ce que le modèle a en mémoire, ancré dans ses données d’entraînement. Elle est apprise à un instant donné, bouge lentement et se mesure de façon reproductible.
La citabilité : ce que l’étape de recherche (le live retrieval) place sous les yeux du modèle au moment de répondre. Elle est volatile et actionnable à court terme.
Il illustre la différence par deux cas extrêmes. Pour savoir qui présidait la France en 2003, ChatGPT n’a pas besoin de chercher sur le web : l’information est solidement ancrée dans ses données d’entraînement. Pour connaître le résultat du dernier match de l’OM, il doit effectuer une recherche. La plupart des prompts, notamment en e-commerce, se situent entre les deux : le moteur puise une partie de l’information dans sa mémoire, puis la recherche la complète, la valide ou parfois la contredit.
Ces deux axes forment une matrice à quatre cases : présente et citée (position idéale), présente mais jamais citée (problème de récupération), absente mais citée (position portée par la recherche, donc fragile), absente et silencieuse (tout est à faire). Pierre Sauvé présente cette grille comme une proposition de complément méthodologique, et non comme une vérité établie.
Le robots.txt recoupe en partie cette distinction. Chez OpenAI, GPTBot collecte pour l’entraînement (la présence), tandis qu’OAI-SearchBot alimente l’index de recherche (la citabilité). Le consultant cite plusieurs cas observés en septembre 2026, avec des taux de citation calculés sur le jeu de prompts de chaque secteur :
Moosend : GPTBot et ChatGPT-User bloqués, OAI-SearchBot autorisé. Marque citée par ChatGPT dans moins de 3 % des réponses.
Dealabs : tous les robots bloqués par défaut, sauf sur le répertoire des codes promos. Marque citée par ChatGPT dans 36 % des réponses.
Ouest-France : stratégie sélective selon les rubriques.
Pour Pierre, bloquer GPTBot n’empêche pas une marque d’apparaître dans les données d’entraînement, puisque d’autres sites parlent d’elle. Ce choix revient surtout à laisser à des tiers la manière dont la marque y est décrite, et à dépendre de la recherche pour corriger ou valider ces informations. Dealabs illustre l’inverse : selon lui, son ancrage est si fort que le blocage ne l’empêche pas d’être bien présente et bien citée. De la même façon, les LLM connaissent Ouest-France ou Le Figaro malgré la posture restrictive des médias.
La log-probabilité sert d’instrument pour mesurer la présence
Pierre Sauvé limite volontairement son étude à la présence, qu’il juge la plus mal connue et la moins vérifiée dans les audits. Il laisse la citabilité (balisage, format des réponses, fraîcheur) aux outils SaaS spécialisés, et estime que sa conférence ne couvre qu’environ la moitié du sujet. Il précise aussi qu’il mesure si le modèle connaît une marque, pas ce qu’il en pense, un second volet étant annoncé pour une « V2 ».
Son instrument est la log-probabilité (logprob). Pour rappel, un modèle de langage attribue une probabilité à chaque mot susceptible d’en suivre un autre. Dans la phrase « Paris est la capitale de la… », « France » obtient environ 90 % et « soupe » environ 0,01 %. Le consultant exprime ces valeurs en nats, une unité logarithmique : 0 nat correspond à une probabilité de 100 %, et chaque nat en moins divise la probabilité par 2,7 environ. Une marge de +0,78 nat signifie ainsi que la bonne réponse est 2,2 fois plus probable que la meilleure des mauvaises.
Le protocole repose sur quatre briques :
Le panel : 148 marques réparties sur 11 secteurs, avec une majorité de marques anglophones, un sous-groupe français et 38 marques inventées servant de témoins. Le consultant dit avoir mélangé des secteurs très présents sur le web (CRM, plugins SEO pour WordPress) et d’autres qui communiquent moins.
La notoriété : le nombre de mentions par milliard de mots dans cinq corpus ouverts de pré-entraînement (C4, DCLM-baseline, Dolma v1.7, RedPajama et The Pile), compté via l’API infini-gram de l’Allen Institute for AI.
La présence : dix modèles ouverts issus de trois familles (Qwen, Llama, Gemma), en deux tailles de 1 à 9 milliards de paramètres, complétés par des tests sur des modèles de 70 milliards.
L’appariement : plutôt que de comparer Nike à un petit fabricant local, le consultant compare des marques de notoriété équivalente.
Les vrais corpus de Qwen, Llama, Gemma et des modèles fermés ne sont pas publiés. Pierre Sauvé s’appuie sur le fait que Common Crawl est au cœur de l’entraînement de tous ces modèles, en rappelant que la seule composition publiée par OpenAI date de GPT-3 (60 % des tokens). Il raisonne aussi par différence entre corpus de composition connue, Dolma contenant Reddit et RedPajama non. Le tout a été réalisé avec des GPU loués, pour un coût global d’environ 50 dollars.
La mesure centrale est la « marge de catégorie ». Le modèle évalue la phrase associant la marque à sa vraie catégorie, puis la compare à quatre fausses catégories (café italien, poisson, village du sud, danse folklorique). La marge est l’écart, en nats, entre la bonne catégorie et la meilleure des fausses. Elle est ensuite comparée à un « plancher » : la marge obtenue par des noms inventés, générés puis vérifiés un par un sur Google pour s’assurer qu’ils n’existaient pas. Selon le consultant, une log-probabilité brute mesure la plausibilité d’une chaîne de caractères, pas la connaissance : en démonstration, la marque inventée « Mailzephor » passait devant une vraie marque avant cette correction.
Le premier enseignement concerne le nom lui-même. Un nom inventé mais « parlant », qui contient par exemple « mail » pour l’emailing, obtient une marge positive sans aucune connaissance derrière. Selon les modèles, ce bonus atteint +0,75 à +1,05 nat sur les petits modèles et +0,99 à +1,23 nat sur ceux de 7 à 9 milliards de paramètres. La part de marques réelles qui dépassent la meilleure marque inventée varie de 30 % (Qwen, petite taille) à 71 % (Gemma, grande taille). Sur les petits modèles, sept marques sur dix ne battent donc pas un nom qui n’existe pas. Les gros modèles connaissent davantage de marques, mais accordent aussi un bonus plus élevé aux noms parlants.
Mentions, Reddit, Wikipédia : trois croyances passées au crible
« Spammons de mentions, tant pis pour les liens »
Pierre Sauvé rappelle d’abord que le balisage HTML est supprimé lors de l’extraction du texte d’entraînement. Dans les corpus, « https:// » apparaît 525,7 fois par million, « href= » 16,6 fois et « rel="nofollow" » 3,7 fois. D’un lien, il ne reste que l’ancre, c’est-à-dire une mention. Le lien garde pourtant un rôle à deux niveaux. En amont, Common Crawl découvre et revisite les pages en suivant les liens, et les filtres qualité favorisent les pages connectées. En aval, ChatGPT et Gemini s’appuient sur des index où le graphe de liens sélectionne les pages proposées au modèle.
Il vise ici les plateformes qui vendent des mentions pour le GEO. Selon lui, aucune n’a démontré d’effet sur les données d’entraînement : elles partent du principe que leurs contenus seront à la fois récupérés par la recherche et intégrés aux corpus.
Ses mesures montrent un rendement décroissant. En classant les 148 marques en quatre groupes de taille égale, la part de marques réellement reconnues passe de 11 % (Botify, Oncrawl, Bricorama…) à 30 % avec six fois plus de mentions, puis à 46 % avec 33 fois plus. Elle redescend à 35 % pour les marques omniprésentes (HubSpot, IKEA, Sephora), avec 110 fois plus de mentions.
Sur Qwen 1,5B, la marge moyenne passe de +0,28 à +0,97 nat entre le premier et le deuxième quartile de mentions, puis ne gagne que +0,24 nat jusqu’au quatrième, malgré dix-neuf fois plus de mentions. Sur Qwen 7B et Llama 8B, le deuxième quartile dépasse même les suivants. Le consultant en conclut que sortir de l’invisibilité vaut l’effort, mais que saturer une marque déjà présente rapporte beaucoup moins. Pour une marque jeune ou très peu présente, il recommande au contraire de « taper un peu fort », puisqu’elle part de zéro.
« La présence Reddit pèse lourd »
Les corpus n’indiquent pas d’où vient une occurrence. Pierre Sauvé compare donc Dolma (avec Reddit) et RedPajama (sans Reddit), construits selon la même méthode. Rank Math y est 9,1 fois plus mentionné dans Dolma, Semrush 4,9 fois, Bioderma 3,3 fois, Oncrawl seulement 1,3 fois. Au-delà d’un rapport de 3,3, il considère qu’une marque doit notablement sa présence à Reddit.
Une lecture naïve semble confirmer la croyance : les 16 marques « Reddit-friendly » affichent une marge médiane de +1,39 nat contre +1,06 pour les 132 autres, avec cinq fois moins de présence web. Mais à notoriété web égale, sur 16 paires, le résultat tombe à 8 contre 8, pour un écart médian de −0,05 nat. Deux exemples l’illustrent :
AccuRanker contre Sistrix : à notoriété comparable (16 et 18 mentions par milliard), l’outil plus présent sur Reddit l’emporte de 1,67 nat.
Bioderma contre Fenty Beauty : à 351 et 344 mentions par milliard, c’est la marque peu visible sur Reddit qui l’emporte, avec 1,12 nat d’écart.
Pierre Sauvé en conclut que Reddit signale une présence sans en déterminer la valeur. Il rapporte le cas d’un client accompagné par une agence spécialisée dans Reddit : aucune différence observée, un compte signalé par la plateforme, et des critiques formulées uniquement sur Reddit qui sont ensuite remontées dans les réponses des IA. Il ajoute que les LLM cherchent souvent à présenter les points positifs et négatifs d’une marque. Interrogé sur la rentabilité de Reddit, il répond qu’elle n’est pas supérieure à celle d’un média quelconque, et conseille plutôt de travailler sur des espaces où la marque maîtrise son discours.
« Être sur Wikipédia change tout »
Même démarche pour Wikipédia, dont le statut a été vérifié via l’API de l’encyclopédie. Les 75 marques avec une page devancent les 73 autres de 0,42 nat. Elles sont aussi 11,9 fois plus mentionnées. Pour le consultant, avoir une page Wikipédia est d’abord un symptôme de notoriété.
À notoriété égale, sur 36 paires, 17 vont dans le sens de la croyance et 19 dans le sens inverse, avec un écart médian de −0,29 nat. SendGrid (avec page) devance AWeber (sans page) de 1,79 nat à notoriété quasi identique. À l’inverse, Rank Math (sans page) devance Yoast (avec page) de 1,27 nat. Pierre Sauvé avance deux explications possibles : un nom qui contient « Rank » est plus facilement associé au SEO, et Rank Math, arrivé plus tard, a suscité de nombreux contenus comparatifs.
Il reconnaît à Wikipédia un contexte encyclopédique plus informatif et plus neutre que Reddit, sans y voir pour autant de levier décisif. Il rappelle aussi qu’une page créée par un prestataire rémunéré est souvent signalée par un bandeau ou une mention de contribution rémunérée, ce qui ne sert pas l’image de la marque. Interrogé sur Wikidata, il précise ne pas l’avoir mesuré. Son hypothèse : il s’agit d’une base de données qui fournit des relations entre entités plutôt que du texte d’entraînement.
Être connu du modèle ne prédit pas la citation
Pierre Sauvé a ensuite croisé ses mesures de présence avec les données de citation fournies par Qwairy, relevées dans l’interface et non par l’API. Environ 20 prompts génériques par secteur, en français et sans nom de marque, ont été soumis trois fois à ChatGPT et Gemini, soit 1 100 réponses selon les slides. Une marque est considérée comme « citée » si elle apparaît dans au moins 5 % des réponses de son secteur, et « présente » si sa marge dépasse le plancher des noms inventés.
Les accords entre classements (de 0 pour aucun rapport à 1 pour un ordre identique) sont parlants :
ChatGPT et Gemini, sur les marques qu’ils citent : 0,89.
Les modèles ouverts, sur les marques qu’ils connaissent : 0,85.
Présence et citation entre elles : 0,1.
Chaque couche est cohérente avec elle-même, mais les deux ne se recouvrent pas, sauf pour les marques les mieux placées, comme IKEA ou HubSpot. Trois cas l’illustrent :
Adobe Marketo : marge de +1,37 nat et 2 131 occurrences par milliard de mots, mais une seule réponse ChatGPT sur 60 dans le secteur de l’emailing. Le consultant rappelle que la marque réalisait 400 millions de dollars de chiffre d’affaires en 2021.
Brevo : marge de −0,15 nat, inférieure à celle d’une marque inventée, mais citée dans 83 % des réponses ChatGPT du secteur.
Google Optimize : service arrêté en 2023, marge de +2,1 nat, 0 % de citation, comme Universal Analytics ou Klout. Selon Pierre Sauvé, les mises à jour des données d’entraînement ne font pas baisser ses occurrences, car les modèles continuent d’absorber des articles anciens. Sa formule : « Les données d’entraînement n’oublient pas, mais la recherche, oui. »
Le cas Brevo s’explique par le rebranding de Sendinblue en mai 2023. Sur les trois petits modèles, Sendinblue obtient entre +1,56 et +1,73 nat mais n’est jamais cité, tandis que Brevo oscille entre −0,44 et +1,07 nat. La mémoire retient l’ancien nom, la recherche cite le nouveau. Pour le consultant, c’est la recherche web qui corrige le tir : elle signale au modèle que Sendinblue est devenu Brevo. Il note aussi que le changement n’a pas aidé la marque côté présence, « Send » étant plus proche de l’emailing qu’un nom neutre comme Brevo. Même schéma pour Piwik devenu Matomo, cité dans 65 % des réponses alors que Piwik domine les données d’entraînement.
Sur la matrice finale, Pierre Sauvé classe 61 marques présentes et citées (HubSpot, Ahrefs, Semrush), 65 présentes mais jamais citées (Marketo, Hiscox, FullStory), 13 absentes mais citées (Brevo, MAIF, Weldom) et 17 absentes et silencieuses (Sistrix, Matmut).
Le consultant indique avoir tenté de contredire ce résultat, secteur par secteur, puis sur les articles de type « meilleurs outils de », sans changer la conclusion. Sur Llama 3.1 70B, cinquante fois plus gros, l’accord reste nul. La langue joue en partie : sur des modèles mieux entraînés en français et interrogés en français, l’ordre change. En anglais, tous les modèles placent Home Depot devant Leroy Merlin, alors qu’une sonde française sur un modèle français rétablit l’ordre. Il dit n’avoir trouvé aucun modèle majoritairement entraîné en français : Mistral, qu’il pensait plus francophone, présentait davantage de marqueurs anglais que les modèles américains.
Il insiste enfin sur un point : la présence n’est pas inutile. Elle explique environ 10 % du classement, et les marques les plus citées figurent parmi celles qui se détachent sur la présence. Selon lui, être dans les données d’entraînement permet aussi de rattacher la marque à son contexte : si le modèle ne sait pas que Brevo fait de l’emailing, le lien doit être reconstruit à chaque recherche. Pour une petite marque, il recommande d’acquérir des mentions et de s’insérer dans des comparatifs, même si le gain reste modeste.
Un standard d’audit, un kit et une méthode discutée
Ce que Pierre Sauvé demande à un audit GEO
À sa connaissance, aucun outil commercialisé ne mesure la présence dans les données d’entraînement. Il en fait la première exigence d’un audit, avant de détailler celles qui portent sur la citation :
Des passages répétés, avec une variance visible. Un passage unique relève du bruit : un client qui teste lui-même ses prompts favoris obtiendra un résultat différent.
Des appels dans le produit plutôt que par l’API, dont la couche de recherche diffère et dont les réponses sont, selon lui, moins riches.
Un socle stable (modèle, date, prompts), en ne changeant de modèle que lorsque le modèle par défaut du grand public change.
Deux indicateurs distincts, présence et citation, parce qu’ils ne bougent pas ensemble.
Il met aussi en garde contre l’usage des log-probabilités exposées par l’API d’OpenAI. On n’y choisit pas la phrase évaluée, il n’y a ni corpus ni appariement, et le modèle comme la recherche évoluent sans cesse. Selon lui, on y mesure une conversation, pas une mémoire.
Ses recommandations suivent la matrice. Pour les marques présentes mais jamais citées : « Arrêtez de payer pour entrer dans les LLM », puisque le blocage se situe dans la récupération. Pour les marques présentes et citées, il conseille d’exiger la variance des prompts et de reprendre la main sur le discours de marque. Pour les marques absentes mais citées, comme Brevo, il recommande de ne rien relâcher et de s’imposer aussi dans les données d’entraînement. Pour les marques absentes et silencieuses, il prévient que le chantier sera long et qu’il faut annoncer délai et budget dès le départ.
Un kit pour tester sa propre marque
Le 2 octobre 2026, Pierre Sauvé a publié sur GitHub un kit sous licence MIT, baptisé brand_probe, qui applique la méthode à une marque à la fois. Il fonctionne en ligne de commande, dans un notebook Colab ou via une petite interface. Le modèle par défaut, Qwen 2.5 1.5B, se télécharge (3 Go) sans compte. Llama et Gemma nécessitent un compte Hugging Face et l’acceptation de leur licence. À l’oral, le consultant a mis en garde contre une possible hausse des coûts de Hugging Face, qu’il présentait comme récemment racheté par NVIDIA.
Le kit fournit :
La présence dans chaque modèle : marge de catégorie, plancher des noms inventés et verdict (présente si la marge dépasse le plancher de plus de 0,10 nat).
Le nom parlant : la marge d’un nom inventé qui annonce la catégorie (« Rankzuri » pour le SEO, « Assurvex » pour l’assurance). Sur Qwen 1.5B en français, Assurvex obtient +0,62 nat contre +0,42 pour Groupama.
Les termes associés : les mots que le modèle rattache à la marque, corrigés de ce qu’il dirait d’un nom inventé.
La fréquence dans les corpus C4, DCLM et Dolma, et les mots qui accompagnent la marque.
Le README avertit que le kit ne mesure pas la citation. Il résume la position de l’auteur : être dans les poids est une condition d’entrée, pas une cause de citation. Une marque absente des poids n’est jamais citée sans recherche web, mais une marque présente ne l’est pas pour autant. Le document détaille aussi plusieurs pièges :
Le collage de tokens : infini-gram apparie des séquences de tokens. « Brevo » compte 3 421 occurrences dans C4, dont 98 % correspondent à « Brevoort » (un éditeur de Marvel) ou « Brevoortia » (un poisson). En mot entier, Brevo n’en compte que 53.
Les homonymes : dans les corpus anglophones, « MAIF » désigne surtout le Maryland Automobile Insurance Fund. Une requête combinée (par exemple « Orange » avec « téléphonie », cité en démonstration) déplace l’équilibre sans tout corriger.
Les corpus datés : C4 date d’avril 2019, DCLM de 2023 et Dolma de début 2024.
La taille des modèles : une marque absente à 1,5 milliard de paramètres peut être présente à 9 milliards.
Le script fixe la révision exacte de chaque modèle et refuse la quantification, qui modifierait les log-probabilités. Deux personnes doivent ainsi obtenir la même marge à la décimale près.
Une méthode discutée sur LinkedIn
Notons qu'après la publication de Pierre Sauvé sur LinkedIn, Antony Luvera, CTO chez Maples Labs a contesté le passage entre ce qui est mesuré et ce qui est conclu. Selon lui, comparer des corpus et apparier des volumes de mentions n’isole pas explicitement l’effet de Reddit ou de Wikipédia. Une association marque-catégorie n’explique pas une recommandation. Et une marque connue mais non citée a pu être trouvée, comparée puis écartée, sans qu’il s’agisse d’un problème de récupération. Il estime que la méthode ignore les sources réellement présentes dans la fenêtre de contexte, les informations reprises dans le raisonnement du modèle et les critères de comparaison activés.
Pierre Sauvé reconnaît la justesse du troisième point : sa méthode regroupe les marques « jamais récupérées » et « récupérées puis écartées ». Il précise établir seulement que le blocage ne vient pas de la présence dans les données d’entraînement. Sur Wikipédia et Reddit, il dit conclure à une absence d’effet mesurable à notoriété égale, et non à une absence totale d’effet. Il ajoute qu’observer Reddit dans la fenêtre d’une réponse citant une marque ne prouve pas que Reddit a causé la citation : pour mesurer une contribution, il faudrait retirer la source et rejouer la requête, ce qui est impossible.
Précisons que durant sa présentation au TEKnSEO, Pierre Sauvé avait présenté sa matrice comme une proposition et reconnu à plusieurs reprises les limites de ses mesures statistiques. Antony Luvera soutient par ailleurs que l’analyse fine peut être instrumentée : les modèles exposent le contenu des sources qui entrent dans la fenêtre de contexte, ce qui permet selon lui de relier les données reprises aux choix observés, une fois pondérés par les récurrences entre conversations. Il renvoie vers le livre blanc méthodologique de Maple Labs (maplelabs.fr/technologie). La question de savoir si l’on peut attribuer une citation à une source précise reste donc ouverte entre les deux approches.
Lundi matin, une boutique de 1 200 références ouvre sa Search Console : des milliers d’URLs classées « Autre page avec balise canonique appropriée ». Des /collections/robes/products/robe-lin, des ?filter.v.option.couleur=bleu, des ?variant=44718. Personne n’a rien cassé. Shopify fonctionne comme prévu. Le SEO Shopify commence là : comprendre ce que la plateforme décide à votre place, et ce qu’elle vous interdit de faire. Shopify équipe 25,3 % des sites e-commerce détectés sur mobile, deuxième plateforme derrière WooCommerce (HTTP Archive, Web Almanac 2025). Autant de boutiques qui partagent les mêmes verrous. Shopify n’est pas mauvais en SEO, il est rigide. Ses limites se contournent presque toutes, à condition de savoir lesquelles coûtent du trafic. Shopify et le SEO : solide sur les bases, verrouillé sur le reste Ce que la plateforme fait bien nativement Commençons par ce qui marche, sans app ni développeur : une balise canonical générée automatiquement sur les produits, collections et pages ; un sitemap.xml créé et mis à jour sans intervention ; un title jusqu’à 70 caractères (60 recommandés) et une meta description de 160 caractères, éditables sur chaque ressource (Shopify Help Center, 2026) ; des données structurées produit imposées aux thèmes du Theme Store (Shopify Dev Docs, 2026). Le résultat se mesure. 76 % des boutiques Shopify passent les trois Core Web Vitals sur mobile, contre 35 % pour WooCommerce et 35 % pour Magento (HTTP Archive, Web Almanac 2025). Tous sites confondus, la moyenne plafonne à 48 % sur mobile (HTTP Archive, Web Almanac 2025). Sur les fondamentaux, Shopify part devant. Le vrai problème : un CMS fermé Pas d’accès serveur. Pas de .htaccess. Pas de plugin qui réécrit les URLs. L’arborescence, les préfixes, le sitemap : tout est décidé par Shopify. Google impose, on dispose, et sur Shopify la marge de manœuvre se gagne hors des réglages. Chaque contournement passe par l’une de ces quatre portes, par ordre de préférence : le thème Liquid (code éditable, gratuit, durable) ; les metafields (champs personnalisés natifs) ; une app (rapide, mais chaque app pèse sur la vitesse) ; le headless avec Hydrogen (contrôle total, coût élevé). C’est la règle de base de tout accompagnement SEO Shopify sérieux : épuiser le Liquid avant d’empiler les apps. Les 13 limites du SEO Shopify en un tableau Limite Impact SEO Contournement URLs imposées (/products/, /collections/, /pages/, /blogs/) Aucune hiérarchie sémantique dans l’URL. Handles courts, fil d’Ariane et BreadcrumbList en JSON-LD. Doublons produit via les collections Liens internes vers des URLs non canoniques, crawl dilué. Retirer le filtre within: collection des cartes produit. Variantes en ?variant= Une seule page indexable pour toutes les couleurs. Un produit par variante à forte demande, reliés entre eux. robots.txt Aucun fichier modifiable directement. Créer le template robots.txt.liquid. Sitemap non éditable Pages inutiles soumises à Google. Métafield seo.hidden ou statut Non répertorié. Filtres et tags Explosion d’URLs paramétrées quasi identiques. Disallow ciblés et collections dédiées aux combinaisons à volume. Pagination Produits profonds peu explorés sur les gros catalogues. Liens crawlables et sous-collections. Contenu des collections Texte SEO absent ou placé au-dessus des produits. Métafield texte enrichi affiché sous la grille. Blog Pas de catégories, pages tag dupliquées. Plusieurs blogs comme catégories, noindex des tags. Données structurées Schéma Product incomplet, doublons injectés par les apps. Filtre structured_data et snippet JSON-LD sur mesure. Vitesse et apps Scripts tiers qui dégradent LCP et INP. Audit app par app, nettoyage du code résiduel. Multilingue Markets hreflang automatiques peu personnalisables. Handles traduits, pas de redirection IP forcée. Redirections 301 Impossible depuis une URL encore valide. Plan de redirection avant chaque changement de handle. Ces 13 lignes ne pèsent pas le même poids. Détail de chaque limite ci-dessous, ordre de traitement à la fin. Architecture et URLs : les limites structurelles Une structure d’URL imposée (/products/, /collections/, /pages/, /blogs/) Les préfixes Shopify ne se suppriment pas, ne se traduisent pas et ne s’imbriquent pas. Impossible d’obtenir /femme/robes/robe-lin-bleue : une sous-collection reste /collections/robes-lin, au même niveau que sa parente. Impact SEO : l’URL ne porte plus la hiérarchie du catalogue. Pas un drame : Google comprend une structure par les liens bien plus que par les dossiers. Encore faut-il lui donner ces liens. Contournement : des handles courts et ciblés (robe-lin-bleue, pas robe-en-lin-bleu-ciel-collection-ete) ; une hiérarchie portée par le menu et les liens entre collections parentes et enfants ; un fil d’Ariane visible, doublé d’un BreadcrumbList en JSON-LD. Les URLs produit dupliquées par les collections Chaque produit existe sous plusieurs formes : /products/robe-lin, mais aussi /collections/robes/products/robe-lin, et une version par collection qui le contient. Shopify place une balise canonical vers /products/robe-lin sur toutes ces versions. La plupart des guides s’arrêtent là. Le problème est ailleurs. Dans de nombreux thèmes, la carte produit de la grille construit son lien avec le filtre within: collection. Tous les liens internes depuis vos collections pointent alors vers la version non canonique. Le canonical dit « /products/ », le maillage dit l’inverse. Google crawle les deux, et le canonical n’est qu’une indication qu’il peut ignorer. Contournement : dans le snippet de carte produit (souvent card-product.liquid ou product-card.liquid), remplacer : <a href="{{ product.url | within: collection }}"> par : <a href="{{ product.url }}"> Une ligne modifiée, et le maillage s’aligne enfin sur le canonical. Plusieurs thèmes récents ont abandonné ce filtre, mais les thèmes premium et les anciennes versions le gardent souvent. Les variantes : une seule URL pour toutes les couleurs Une robe en plusieurs couleurs, c’est un seul produit et une seule URL. Chaque couleur ouvre /products/robe-lin?variant=44718, canonicalisée vers la page produit. Depuis le 15 octobre 2025, tous les marchands peuvent créer jusqu’à 2 048 variantes par produit, contre 100 auparavant (Shopify Developer Changelog, 2025). Plus de variantes possibles, toujours zéro page indexable par variante. Impact SEO : la requête « robe lin bleue » n’a pas de page dédiée. Aucun title ni H1 possible pour la couleur qui fait le volume. Contournement, au cas par cas : garder les variantes pour les tailles : personne ne cherche « robe lin taille 38 » ; créer un produit distinct pour chaque couleur à forte demande, avec son handle et son contenu ; relier ces produits : Combined Listings (app Shopify réservée aux plans Plus et enterprise) les affiche comme un seul produit avec sélecteur, sinon un metafield de type liste de produits alimente des pastilles couleur dans le thème. Vérifiez la demande avant de scinder. Sans volume, un produit par couleur multiplie les pages fines. Crawl et indexation : robots.txt, facettes, pagination, sitemap robots.txt : éditable, mais via robots.txt.liquid Le robots.txt de Shopify se modifie par une seule voie : le template robots.txt.liquid, qui remplace le fichier généré. Détail rarement mentionné : les thèmes du Theme Store n’ont pas le droit d’en embarquer un (Shopify Dev Docs, 2026). Il faut le créer soi-même, dans l’éditeur de code, via « Ajouter un modèle ». Le template manipule des objets Liquid (robots, group, rule, user_agent, sitemap). Bonne pratique : conserver les règles par défaut et n’ajouter que vos Disallow : {% for group in robots.default_groups %} {{- group.user_agent }} {%- for rule in group.rules -%} {{ rule }} {%- endfor -%} {%- if group.user_agent.value == '*' -%} {{ 'Disallow: /*collections/*?*filter.' | prepend: '\n' }} {%- endif -%} {%- if group.sitemap != blank -%} {{ group.sitemap }} {%- endif -%} {% endfor %} La règle ajoutée bloque les URLs de filtres sur /collections/ comme sur les sous-dossiers de marchés (/en/collections/). Deux précautions, détaillées dans la documentation Shopify sur la personnalisation du robots.txt : ne jamais réécrire le fichier en dur (les règles par défaut de Shopify seraient perdues), et comparer le rendu de /robots.txt au fichier d’origine avant publication, car les deux ne correspondent pas toujours. Filtres et tags : la fabrique à URLs paramétrées Les filtres natifs génèrent des paramètres au format filter.p.* et filter.v.*, par exemple /collections/all?filter.p.product_type=shoes&filter.v.option.color=red, avec 25 filtres maximum (Shopify Dev Docs, 2026). Chaque combinaison crée une URL. S’y ajoutent les anciennes URLs par tag (/collections/robes/lin), encore servies par de nombreux thèmes. Impact : Googlebot s’épuise sur des pages quasi identiques et découvre plus lentement vos nouveaux produits. Google le dit sans détour dans sa page sur la gestion de la navigation à facettes, mise à jour le 18 décembre 2025 : bloquer le crawl de ces URLs par robots.txt est la méthode recommandée, canonical et nofollow étant moins efficaces à long terme (Google Search Central, 2025). Le robots.txt par défaut de Shopify bloque déjà le tri et les combinaisons de plusieurs filtres, pas les filtres simples. Contournement en deux temps : un Disallow sur les paramètres de filtres dans robots.txt.liquid (exemple ci-dessus) ; pour chaque combinaison à vrai volume (« robe lin bleue »), une collection dédiée avec son handle, son title, son texte et un lien dans le menu. Celle-là sera indexable. Erreur fréquente : bloquer les facettes dans robots.txt ET leur ajouter un noindex. Google ne voit jamais le noindex d’une URL qu’il ne peut pas explorer. Facettes déjà indexées ? Noindex d’abord, Disallow une fois les pages sorties de l’index. Pagination : ?page= et plafond des 25 000 éléments Une collection affiche ses produits via le tag Liquid paginate : de 1 à 250 éléments par page, et aucune pagination possible au-delà du 25 000e élément (Shopify Dev Docs, 2026). Les pages suivantes prennent l’URL ?page=2, ?page=3, chacune canonicalisée vers elle-même. Impact : sur un gros catalogue, les produits en fin de pagination reçoivent peu de liens et sont explorés tard. Au-delà du plafond, la collection ne les expose plus du tout. Contournement : des liens de pagination en dur (a href), pas un bouton « Charger plus » en JavaScript sans URL ; jamais de noindex ni de canonical vers la page 1 sur les pages 2 et suivantes ; des sous-collections thématiques pour découper les gros catalogues. Sitemap automatique et non éditable Shopify génère sitemap.xml et vous ne pouvez rien y retirer directement. Produits de test, pages de remerciement, collections techniques : tout y entre. Contournement : le statut produit « Non répertorié » (Unlisted) garde un produit accessible par lien direct, hors collections, recherche interne et recommandations ; le métafield système seo.hidden (namespace seo, clé hidden, type number_integer, valeur 1) retire la ressource du sitemap et ajoute une balise noindex. Il se pose par import CSV, app de metafields ou API ; pour ajouter des sitemaps (images, vidéos, pages hors Shopify), déclarez-les dans robots.txt.liquid et dans la Search Console. Contenu : collections, blog et données structurées Collections : un seul champ description, placé en haut Une collection n’a qu’un champ description, que la plupart des thèmes affichent au-dessus de la grille. Deux mauvaises options : un texte court qui ne se positionne pas, ou un pavé qui repousse les produits et plombe la conversion. Contournement : créer un métafield de collection en texte enrichi (par exemple custom.texte_seo) ; l’afficher via une section de thème sous la grille ; garder en haut deux ou trois lignes d’introduction qui contiennent le mot-clé principal. Une collection qui vend en haut, qui se positionne en bas. Le contenu du bas sert l’acheteur (critères de choix, guide des tailles, questions fréquentes), pas Google. Un blog minimaliste Le blog Shopify fait le strict minimum. Pas de catégories. Un préfixe imposé /blogs/nom-du-blog/. Des pages /blogs/news/tagged/x générées pour chaque tag, quasi identiques entre elles. Contournement : plusieurs blogs en guise de catégories (/blogs/guides/, /blogs/entretien/) plutôt qu’un unique /blogs/news/ ; les pages tag en noindex, via une condition dans le head de theme.liquid ; un maillage manuel de chaque article vers les produits et collections : c’est là que le blog rapporte du chiffre d’affaires. {% if template contains 'blog' and current_tags %} <meta name="robots" content="noindex, follow"> {% endif %} Données structurées du thème : le minimum syndical Le thème fournit le balisage Product minimal, rarement plus. Manques fréquents : une offre par variante (prix, disponibilité, GTIN), les avis, la livraison et les retours, BreadcrumbList, Organization. Autre piège : les apps d’avis injectent souvent leur propre balisage Product. Résultat, deux entités Product sur la même page, avec des prix ou des notes discordants. Contournement : partir du filtre Liquid structured_data ({{ product | structured_data }}), qui génère un JSON-LD Product à partir des données Shopify ; compléter par un snippet JSON-LD maison (BreadcrumbList, Organization, retours) ; passer une page produit au test des résultats enrichis de Google et désactiver le balisage en doublon, celui de l’app ou celui du thème. Performance : les apps, premier ennemi des Core Web Vitals Le paradoxe tient en deux chiffres. 76 % des boutiques Shopify passent les Core Web Vitals sur mobile (HTTP Archive, Web Almanac 2025), mais leur score Lighthouse Performance médian sur mobile n’est que de 55, contre 71 sur desktop (HTTP Archive, Web Almanac 2025). C’est moins que le score moyen de 60 exigé de tout thème pour entrer au Theme Store (Shopify Dev Docs, 2026). Lecture : l’infrastructure Shopify tire les données terrain vers le haut, les ajouts du marchand tirent les mesures de laboratoire vers le bas. Le thème sort de la boîte au-dessus du seuil, la boutique en production finit en dessous. Les coupables habituels : les scripts d’apps chargés sur toutes les pages (avis, chat, upsell, pop-up, fidélité) ; le code résiduel : une app désinstallée laisse souvent ses snippets dans le thème ; les images servies sans le filtre image_url ni tailles responsives ; les polices en plusieurs graisses et les vidéos en lecture automatique en haut de page. Contournement : audit app par app : désactiver une app à la fois et mesurer LCP et INP dans PageSpeed Insights ; préférer les apps en app embeds, désactivables depuis l’éditeur de thème ; après chaque désinstallation, chercher les snippets orphelins (render ‘nom-de-l-app’) ; images via image_url avec srcset, lazy-loading sous la ligne de flottaison, jamais sur l’image LCP ; polices système, ou une seule police web préchargée. International et migrations : Markets et redirections Markets : hreflang automatiques, contrôle limité Shopify Markets gère plusieurs pays et langues sur une seule boutique, idéalement en sous-dossiers (/en/, /de/). Shopify ajoute automatiquement les hreflang au thème et les met à jour quand domaines ou langues changent. Revers : en ajouter à la main crée des annotations en doublon ou contradictoires (Shopify Dev Docs, 2026). Le contrôle fin vous échappe. Autres limites : sur les marchés secondaires, les sous-dossiers combinent langue et pays (/en-us/), et les handles restent dans la langue d’origine tant que vous ne les traduisez pas. Un /de/products/robe-lin n’aide personne à se positionner en Allemagne. Contournement : traduire les handles, titles et metas avec Translate & Adapt ou une app de traduction ; pas de redirection forcée selon l’IP : Googlebot explore surtout depuis les États-Unis et ne verrait qu’une version ; vérifier dans la Search Console que les hreflang générés pointent vers des URLs qui répondent en 200. Pour le reste, les principes sont ceux de tout projet pour référencer un site multilingue : une URL par langue, un contenu réellement traduit, des signaux cohérents. Redirections 301 natives, mais encadrées Shopify gère les 301 nativement : jusqu’à 100 000 redirections, 20 millions sur Shopify Plus (Shopify Help Center, 2026), à l’unité ou par import CSV. Trois limites à connaître : une redirection ne fonctionne que depuis une URL cassée : si l’ancienne URL charge encore une page valide, la redirection est ignorée ; impossible de rediriger depuis les URLs de collection filtrées par tag (/collections/robes/lin) ; impossible de rediriger les chemins fixes /products et /collections eux-mêmes. Contournement : un plan de redirection (ancienne URL, nouvelle URL) avant chaque refonte ou migration ; la case « Créer une redirection d’URL » cochée à chaque modification de handle ; pour un produit supprimé, une redirection vers son remplaçant ou la collection parente, jamais vers l’accueil en masse ; Shopify Flow pour automatiser les cas récurrents, comme les produits archivés. Headless et Hydrogen : quand sortir du cadre Quand le Liquid ne suffit plus, reste le headless : Shopify ne sert plus que de back-office, le front-end est séparé. La voie officielle s’appelle Hydrogen (framework React de Shopify), hébergé sur Oxygen, inclus sans surcoût sur les plans payants. Vous gagnez le contrôle total des URLs, du rendu et des facettes. Vous perdez tout ce que Shopify faisait seul. Critère Thème Liquid Headless Hydrogen Structure d’URL Préfixes imposés Libre Sitemap, canonical, hreflang Générés par Shopify À développer et maintenir Apps Installation en un clic Intégration sur mesure Coût Faible Élevé (développement et maintenance) Le headless se justifie quand plusieurs critères se cumulent : un catalogue très large, à l’arborescence profonde ; des facettes indexables à grande échelle, ingérables par collections dédiées ; une équipe tech interne ou un prestataire engagé dans la durée ; un budget de maintenance assumé. Sinon, un thème Liquid bien nettoyé fait le travail dans l’immense majorité des cas. Le headless ne corrige pas une stratégie SEO absente. Il la rend juste plus chère. SEO Shopify : par où commencer sur une boutique existante Inutile de tout traiter d’un coup. L’ordre qui rapporte le plus vite : Liens de collection vers /products/ : une ligne de Liquid, effet direct sur le crawl. robots.txt.liquid pour les facettes : fin du gaspillage de crawl sur les filtres. Audit des apps : suppression des inutiles, nettoyage du code résiduel. Contenu des collections : métafield sous la grille, d’abord sur les collections qui ont déjà des impressions. Données structurées : schéma Product complet, doublons supprimés, BreadcrumbList ajouté. Avant chaque étape, relevez les métriques de départ : pages explorées, pages indexées, impressions par collection. Plus de datas, moins de blabla : un correctif sans mesure avant et après reste une opinion. FAQ sur le SEO Shopify Shopify est-il bon pour le SEO ? Oui sur les bases (canonical, sitemap, balises, performances terrain). Non sur l’architecture : URLs, facettes, variantes et blog demandent des corrections dans le thème. Peut-on supprimer /products/ ou /collections/ des URLs ? Non, pas sur un thème Shopify classique. Seul un front-end headless (Hydrogen ou autre) libère la structure d’URL. Faut-il une app SEO sur Shopify ? Une app par besoin précis (redirections en masse, metafields, traduction), oui. Une suite tout-en-un qui injecte des scripts partout, rarement : elle alourdit la boutique pour des fonctions que le thème gère déjà. Conclusion : moins d’apps, plus de Liquid Shopify ne vous empêche pas de ranker. Il vous empêche de bricoler. Ses 13 limites sont documentées, et presque toutes se contournent dans le thème. Les boutiques qui gagnent ne sont pas celles qui installent une app de plus. Ce sont celles qui savent quels verrous sauter, et dans quel ordre. Lesquels coûtent du trafic à votre boutique ? Demandez un audit SEO de votre boutique Shopify : les 13 limites passées au crible, et des correctifs classés par impact.
Article réalisé en partenariat avec l'Afnic, qui a compilé les données de registre utilisées dans les graphiques. Ces chiffres sont publics : chaque registre les déclare à l'ICANN, qui les publie avec environ trois mois de décalage.
Ce qu'il faut retenir :
Les quatre extensions régionales françaises (.paris, .bzh, .alsace et .corsica) réunissent plus de 38 000 noms de domaine.
Les extensions liées à une région ou à une langue ont toutes gagné des noms depuis leur première année complète. Celles des grandes villes ont démarré plus vite, puis ont légèrement reculé après leur pic de lancement.
Le .bzh et le .corsica ont plus que doublé depuis leur première année complète.
Google traite ces extensions comme n'importe quelle autre : leur intérêt se joue sur l'image et l'ancrage local.
Les extensions françaises sont gérées par des collectivités ou des associations, et opérées techniquement en France par l'Afnic.
Une adresse web aux couleurs de sa région
L'extension est la fin d'une adresse web, ce qui vient après le dernier point. Tout le monde connaît le .fr ou le .com. Depuis 2014, de nouvelles extensions portent le nom d'une ville ou d'une région : .paris, .bzh pour la Bretagne, .alsace, .corsica. À l'étranger, on trouve par exemple .berlin, .london, .nyc pour New York, .scot pour l'Écosse, .eus pour le Pays basque ou .wales pour le pays de Galles.
Pour obtenir une adresse de ce type, on passe par un bureau d'enregistrement, c'est-à-dire le prestataire auprès duquel on achète son nom de domaine, comme pour un .fr. Le prix est un peu plus élevé : le registre du .alsace indique par exemple 30 à 40 euros HT par an.
Chaque extension géographique a ses propres règles. Le .bzh est ouvert à toute personne ou organisation qui manifeste un attachement à la Bretagne, qu'il soit géographique (une adresse dans l'un des cinq départements bretons, Loire-Atlantique comprise) ou immatériel (un intérêt pour la Bretagne, sa culture ou sa langue). Aucun justificatif n'est demandé à l'achat, mais l'association qui gère l'extension effectue des contrôles a posteriori. Le .corsica est ouvert aux organisations et aux résidents corses, mais aussi à la diaspora et à toute personne qui a un lien culturel, familial ou identitaire avec l'île. Pour comparer ces adresses au .fr et au .com, vous pouvez lire notre guide pour choisir l'extension de votre nom de domaine.
Les extensions régionales françaises en chiffres
Le .paris a été ouvert au public le 2 décembre 2014, suivi deux jours plus tard par le .bzh. Le .alsace est arrivé en avril 2015 et le .corsica en janvier 2016. En juin 2026, elles comptaient ensemble 38 191 noms de domaine.
Le .paris reste l'extension la plus utilisée, avec 19 376 noms. Elle a démarré très vite : 12 000 noms réservés dans les jours qui ont suivi son ouverture, dont près de 6 000 le premier jour. Ce lancement avait été préparé, avec une centaine d'ambassadeurs pionniers, une campagne d'affichage dans Paris et une phase de réservation prioritaire avant l'ouverture générale. Après avoir doucement décru à partir de 2019, comme les autres extensions de grande ville que nous avons étudiées, le .paris connaît un nouveau dynamisme de ses enregistrements depuis 2025 : il est passé de 18 800 noms fin 2025 à 19 376 en juin 2026.
Le .bzh a suivi une autre trajectoire. Parti plus bas, il progresse chaque année depuis son ouverture, et il est passé de 5 661 noms fin 2015 à 14 018 en juin 2026. Pour les dix ans de l'extension, fin 2024, une collectivité bretonne sur cinq avait un site en .bzh, et deux sur cinq dans le Finistère. Quimper, Lorient, Saint-Brieuc, le Stade Brestois ou le Festival interceltique de Lorient ont adopté l'extension.
Le .corsica a lui aussi plus que doublé, de 1 033 noms fin 2017 à 2 454 en juin 2026, avec une hausse chaque année. Le site officiel de la Collectivité de Corse est en .corsica (isula.corsica). Le .alsace est resté plus stable, entre 2 000 et 2 600 noms depuis 2016.
Ces adresses servent d'abord les organisations. D'après les informations déclarées par les titulaires, 72 % des noms en .paris, .bzh, .alsace et .corsica appartiendraient, au 1er septembre 2026, à des entreprises, des associations ou des collectivités, et 28 % à des particuliers. La part des organisations irait de 71 % pour le .paris et le .bzh à 82 % pour le .alsace.
Dix extensions de territoire comparées en Europe et à New York
Pour comparer des extensions nées à des dates différentes, nous les avons alignées sur leur date d'ouverture : l'année 0 est celle du lancement, l'année 1 la première année complète, et ainsi de suite. Chaque graphique a sa propre échelle : on y lit la forme des courbes, et les volumes sont donnés dans le texte.
Deux familles se dessinent. Les extensions de région ou de langue (.bzh, .eus, .scot, .wales, .alsace, .corsica) montent régulièrement ou se stabilisent. Celles des grandes villes (.paris, .berlin, .london, .nyc) atteignent vite un sommet, puis reculent lentement.
Ces évolutions de volume ne constituent pas, à elles seules, une mesure de la réussite des extensions : chacune poursuit des objectifs propres, avec des publics, des conditions d'accès et des stratégies de développement différents.
Les pics de certaines villes s'expliquent en partie par des promotions de lancement. En juin 2014, pour fêter ses 50 000 noms, le .berlin a lancé une semaine d'offres, et l'un des bureaux d'enregistrement a offert les noms pendant la première année. Ce bureau est passé de 7 800 à 78 500 noms en un mois. Un an plus tard, faute de renouvellement, il en a perdu près de 69 000. Le .london a connu un mouvement comparable en 2017 : une vague d'enregistrements concentrée chez un seul bureau d'enregistrement, qui ne les a pas renouvelés l'année suivante.
Ces épisodes rappellent qu'un nom réservé sans projet derrière finit souvent par être abandonné. Une étude du CENTR, l'association des registres européens, l'a mesuré sur les extensions nationales : 90 % des noms qui portent un vrai site sont renouvelés, contre 70 % de ceux qui n'affichent aucun contenu (CENTR, 2024). Les extensions de territoire s'en sortent bien sur ce point. L'Afnic mesure que les extensions géographiques gardent en moyenne 74 % de leurs noms d'une année sur l'autre, contre 39 % pour les nouvelles extensions génériques (étude Afnic sur le marché des noms de domaine dans le monde en 2024).
Le .cat, l'extension catalane qui a inspiré le .bzh
Le .cat, dédié à la langue et à la culture catalanes, a ouvert en avril 2006, huit ans avant les autres. Le .bzh s'en est d'ailleurs inspiré dès sa candidature. Son parcours donne une idée de ce qui peut se passer sur le long terme.
Le .cat a grandi pendant dix ans, jusqu'à 111 621 noms fin 2016. Depuis, il s'est toujours maintenu au-dessus de 108 000 noms, sans jamais connaître de chute brutale, et il en compte 118 275 en juin 2026. Il semble avoir trouvé sa place auprès de la communauté catalane.
Pourquoi certaines extensions progressent plus vite
Nous n'avons trouvé aucune étude qui compare les extensions de ville à celles de région ou de langue. Ce qui suit relève donc de l'observation, sur dix extensions.
La langue semble jouer un rôle important. Le .eus et le .bzh, les deux croissances les plus régulières, sont liés à une langue autant qu'à un territoire. Selon son registre, 74 % des sites en .eus ont du contenu en basque, contre 20 % de l'ensemble des sites du Pays basque. Choisir une de ces extensions revient à afficher une appartenance, ce qui donne une raison durable de la garder.
Les acteurs locaux comptent aussi. Quand une collectivité, un club de sport ou un festival connu adopte l'extension, il la rend visible pour tous les autres. En Bretagne, des villes, des entreprises, des clubs et des associations l'utilisent au quotidien.
Les registres développent aussi des services pour accompagner les usages de leur extension. Celui du .eus propose par exemple une messagerie gratuite en basque et un programme d'aide à la numérisation des commerces de proximité, ce qui donne à l'extension une utilité concrète.
Pour les grandes villes, l'appartenance est peut-être plus diffuse. Une ville attire beaucoup d'entreprises au moment du lancement, mais l'attachement à une ville se transmet sans doute moins facilement qu'une langue ou une culture régionale. Ces extensions restent pour autant parmi les plus importantes : le .nyc compte plus de 60 000 noms et le .paris plus de 19 000.
L'animation de la communauté dans la durée pourrait aussi jouer un rôle. Au-delà du lancement, valoriser les titulaires et les accompagner entretient l'envie de choisir l'extension, puis de la conserver. Le nouveau site bienvenue.paris va dans ce sens, avec des témoignages d'entrepreneurs, des guides pratiques et une newsletter. Selon l'Afnic, le .paris est d'ailleurs reparti à la hausse depuis plusieurs mois.
Un enjeu de souveraineté numérique
Chaque extension est gérée par un registre, qui fixe les règles d'attribution et perçoit une partie du prix de chaque nom vendu.
Les quatre extensions françaises sont gérées par des acteurs publics ou associatifs. Le .paris appartient à la Ville de Paris, le .corsica à la Collectivité de Corse et le .alsace à la Région Grand Est, qui l'a obtenu en 2014. Le .bzh est porté par l'association www.bzh, à but non lucratif, qui s'est fixé pour objectif de réinvestir ses bénéfices dans les usages numériques en Bretagne. L'Afnic, l'association qui gère le .fr, en est l'opérateur technique : elle assure chaque jour leur fonctionnement, leur stabilité et leur sécurité.
Leurs règles sont donc décidées localement, par des acteurs qui rendent des comptes aux habitants ou à leurs adhérents, et la part du prix qui revient au registre reste en France, au service d'une collectivité ou d'une association.
Le .com fonctionne autrement. Son registre, Verisign, est une entreprise privée américaine cotée en Bourse : les recettes de chaque nom vendu reviennent à ses actionnaires. Le .com relève ainsi d'un enjeu capitalistique, les extensions françaises d'un enjeu de souveraineté. Pour une entreprise française, choisir une extension régionale revient à confier son adresse sur internet à des organisations françaises plutôt qu'à une société étrangère.
Une extension régionale aide-t-elle le référencement ?
Beaucoup se demandent si un .paris aide à remonter sur Google pour des recherches parisiennes. Google a répondu dès 2015 : « Même si elles semblent propres à une région, nous les traiterons comme des gTLD », c'est-à-dire comme des extensions génériques, au même titre que le .com (Google Search Central, juillet 2015). Sa documentation actuelle suit la même règle : seules les extensions nationales comme le .fr sont associées à un pays. Nous l'avions d'ailleurs relayé à l'époque.
Une extension régionale n'est donc pas un levier de classement en soi. Elle peut en revanche devenir un atout indirect. Dans une page de résultats, une adresse en .bzh ou en .paris signale tout de suite un acteur local, ce qui peut inciter les internautes de la région à cliquer davantage sur ce résultat. Un site clairement ancré dans son territoire obtient aussi plus facilement des liens de la presse, des collectivités et des associations locales. Pour le reste, votre référencement local dépendra de votre contenu, de votre fiche d'établissement Google et de vos liens, comme avec n'importe quelle autre adresse.
Leur intérêt tient à ce que voit la personne qui lit l'adresse. Une adresse en .bzh ou en .corsica dit immédiatement d'où vient l'entreprise. Elle se retient facilement, et un nom court a beaucoup plus de chances d'y être disponible que dans une extension où des millions de noms sont déjà pris.
Qui a intérêt à choisir une extension régionale ?
Une extension de territoire a tout son sens si vous êtes dans l'une de ces situations :
Votre activité est ancrée localement. Un artisan, un commerce, un restaurant ou un cabinet qui travaille avec une clientèle de proximité affiche son origine dès l'adresse.
Votre identité régionale fait partie de votre marque. Un producteur, une marque de vêtements ou une brasserie qui revendique son territoire le prolonge sur le web.
Vous lancez un projet local. Un festival, un club, une association ou une campagne municipale trouve plus facilement un nom court et parlant.
Vous êtes une collectivité. Une commune ou une intercommunalité montre son attachement au territoire et donne l'exemple aux acteurs locaux.
Les bonnes pratiques pour se lancer
Vérifiez les conditions d'accès. Chaque extension a ses règles, publiées sur le site de son registre (par exemple pik.bzh pour le .bzh ou puntu.corsica pour le .corsica).
Gardez votre .fr ou votre .com. Conserver l'ancienne adresse évite qu'un tiers la récupère et permet de rediriger vers la nouvelle.
Traitez un changement d'adresse comme une migration. Si votre site existe déjà, redirigez chaque page vers son équivalent (redirections 301), utilisez l'outil de changement d'adresse de la Search Console, mettez à jour vos liens et votre fiche Google, puis surveillez votre trafic pendant les semaines suivantes. Sur un nouveau projet, la question ne se pose pas.
Donnez vie à l'adresse. Un nom réservé sans site finit souvent par être abandonné, comme le montrent les courbes plus haut. Un site actif, même simple, justifie la dépense année après année.
Quinze extensions géographiques demandées à l'ICANN
L'ICANN, l'organisme qui coordonne les extensions d'internet, a ouvert en 2026 un nouvel appel à candidatures, le premier depuis 2012. Le 7 octobre 2026, elle a publié la liste des 1 615 candidatures reçues (ICANN, 7 octobre 2026). Quinze se déclarent géographiques. On y trouve des villes et des régions européennes, comme le .roma, le .vienna, le .budapest, le .bremen, le .salzburg ou le .campania pour la région italienne de Campanie, ainsi que le .québec, avec son accent, demandé par le registre du .quebec.
Aucune ne porte le nom d'une ville ou d'une région française. La liste n'est pas encore définitive : les candidats peuvent modifier l'extension demandée jusqu'au 21 octobre, et l'ICANN publiera la liste arrêtée le 17 novembre 2026.
En début d'année, un internaute a changé le nom et le domaine de son site web. Après avoir configuré les redirections et la fonction « Changement d'adresse » (Change of Address) dans la Google Search Console (GSC), le trafic avait rapidement récupéré autour d'avril.
Quatre mois plus tard (fin juillet), Google a brusquement réindexé l'ancien domaine, tandis que plus de 5 000 pages du nouveau domaine sont passées au statut « Explorée, actuellement non indexée » et que le nouveau domaine a perdu presque tout son trafic direct. Les internautes trouvent les contenus sur Google via l'ancien domaine, puis sont redirigés vers le nouveau, mais absolument rien de ce qui a été publié en 2026 sous le nouveau domaine n'est indexé.
Dans la discussion, John Mueller rappelle que, de manière générale, certains processus de migration et de traitement par Google peuvent prendre un temps particulièrement long. Il souligne un point important découvert et ajusté dans la documentation officielle de Google : pour qu'une migration de domaine se déroule et se finalise correctement via l'outil « Changement d'adresse » de la Search Console, il est nécessaire de bien configurer la procédure pour les deux variantes (avec www et sans www).
Le brevet US 12,717,798 B2, déposé par Microsoft le 28 février 2025 et accordé le 25 août 2026, décrit la génération d'une réponse IA de type AI Overview au sein des résultats de recherche.
Le système calcule un score de complexité pour chaque requête : une recherche simple comme « youtube » ne déclenche pas de document génératif, réservé aux questions qui demandent une synthèse de plusieurs sources.
La requête est déclinée en recherches alternatives (query fan-out), dont les résultats sont notés par un petit modèle d'IA qui ne conserve que les liens les mieux classés pour rédiger la réponse.
Pour les professionnels, la sélection se joue au niveau du lien et des sous-requêtes, et une réponse déjà générée peut être réutilisée tant que les résultats web ne changent pas au-delà d'un certain seuil.
Un brevet Microsoft accordé fin août et repéré par Ian Sorin
Le 12 octobre 2026, Ian Sorin a attiré l’attention sur LinkedIn sur un brevet publié cet été par Microsoft, qui explique selon lui le fonctionnement de « l’AI Overview » de Bing. Il estime que, dans les grandes lignes, le système diffère peu de celui décrit dans le brevet équivalent de Google, mais relève plusieurs points notables.
Le document en question porte le numéro US 12,717,798 B2. Il s’intitule « Generative search results documents based on enhanced search results using generative artificial intelligence (AI) models » et a été attribué à Microsoft Technology Licensing. Quelques repères chronologiques :
Demande provisoire : déposée le 31 décembre 2024.
Dépôt de la demande : 28 février 2025.
Publication de la demande : 2 juillet 2026 (US 2026/0187080 A1).
Délivrance du brevet : 25 août 2026, avec 20 revendications et 13 planches de dessins.
Le brevet ne parle jamais d’« AI Overview », qui est le nom du dispositif de Google. Il décrit un « generative search results document », un document généré par IA qui combine une réponse directe, des sections thématiques et des citations vers les pages sources. Les maquettes d’interface jointes montrent un bouton « Deep search » à côté du champ de recherche, sur l’exemple de la requête « How long do elephants live ».
Pour rappel, Microsoft déploie depuis plusieurs années des fonctions de recherche générative dans Bing. Comme tout brevet, ce texte décrit un système possible : il ne prouve pas que chaque mécanisme est utilisé tel quel dans le moteur.
Bing ne génère pas de réponse IA pour toutes les requêtes
Premier point relevé par Ian Sorin : Bing évalue la complexité de la requête avant de décider si une réponse générative en vaut la peine. Le brevet confirme ce filtre, présenté comme un « seuil de document génératif ».
Concrètement, le système calcule un score de complexité à partir de la requête, des premiers résultats et de l’intention de recherche détectée. Ce score mesure la difficulté à fournir une réponse satisfaisante, ce que le brevet appelle l’« answerability ». Les exemples donnés sont explicites :
Score faible : « solve 2+2 » ou « youtube », qui peuvent recevoir une réponse directe.
Score élevé : « analyze the impact of climate change on global agriculture », qui suppose de croiser plusieurs sources.
Si le score atteint le seuil, le document génératif est créé. Sinon, l’utilisateur reçoit des résultats classiques, éventuellement enrichis, ou une réponse directe. Le brevet mentionne deux façons de calculer ce score : un modèle de machine learning dédié ou un cadre heuristique, c’est-à-dire un ensemble de règles fixes.
Microsoft justifie ce filtre par l’économie de ressources : inutile de mobiliser plusieurs modèles d’IA pour une requête de navigation.
Illustration du principe général, réponse générée vs. réponse directe - Source : Microsoft Bing
Query fan-out et petits modèles : la chaîne qui produit la réponse
Le cœur du brevet repose sur des « small generative AI models », de petits modèles d’IA spécialisés chacun dans une tâche. Le texte cite l’exemple d’un modèle de 1,5 milliard de paramètres, contre 7 milliards pour un « grand » modèle. Ces petits modèles seraient obtenus par transfert d’apprentissage à partir d’un modèle plus grand, puis affinés sur une tâche précise.
L’intention de recherche identifiée en premier
Une fois la requête reçue, le système interroge l’index web pour obtenir une première série de liens. Un modèle dédié à l’intention analyse ensuite la requête et ces résultats pour dégager une ou plusieurs intentions, classées par ordre de probabilité. Selon le brevet, les premiers résultats et l’intention sont obtenus en 1,5 seconde environ.
Des sous-requêtes pour élargir le corpus
Comme l’a noté Ian Sorin, le query fan-out (c'est-à-dire la décomposition d’une requête en plusieurs recherches connexes) fait partie du processus. Un modèle spécialisé génère des requêtes alternatives à partir de la requête initiale, de l’intention et des premiers liens. Le brevet prend l’exemple de « best time to visit Hawaii », qui donne lieu à des recherches sur la période la moins chère, celle où la météo est la plus favorable ou celle des principaux événements. Ces sous-requêtes sont produites en 1,8 seconde environ.
Google a lui aussi décrit publiquement ce mécanisme pour son AI Mode en 2025, ce qui conforte le constat sur la proximité des deux approches.
Un tri par un modèle de classement
Les sous-requêtes sont envoyées à l’index, souvent en parallèle. Dans l’exemple du brevet, 5 requêtes alternatives renvoient chacune 50 liens, soit 250 résultats supplémentaires (300 avec les 50 résultats initiaux). Un modèle de classement note ensuite chaque lien selon sa correspondance avec la requête et l’intention, puis ne retient que les 5, 10 ou n meilleurs. Ce sont ces « enhanced search link results » qui servent de base à la rédaction. Cette étape prend environ 6 secondes.
Une réponse courte produite en parallèle
Pendant ce temps, un autre petit modèle rédige la « directed answer », une réponse d’une ou deux phrases à partir de la requête, de l’intention et des premiers résultats. Elle est générée en moins de 3 secondes. Dans la maquette du brevet, elle apparaît en titre : « Up to 70 years in the wild and 88 years in captivity ».
Le parallélisme est central dans la démonstration de Microsoft. Selon le brevet, enchaîner ces opérations l’une après l’autre prendrait plus d’une minute, alors que le document complet doit être livré en moins de 10 secondes. Cette limite figure d’ailleurs dans la revendication 19.
Des sections générées puis filtrées par des modèles de contrôle
À partir des liens retenus, le système détermine les thèmes à couvrir, puis un modèle rédige chaque section. Plusieurs instances de ce modèle peuvent tourner simultanément, une par section. Chaque section comprend un titre, une phrase d’accroche et un développement, avec des citations liées aux pages sources. Le modèle choisit le format le plus adapté : paragraphe, liste à puces, tableau, image ou vidéo.
Ces sections passent ensuite par des « lightweight quality check models », des modèles légers de contrôle qualité. Le brevet en cite quatre rôles :
Déduplication : suppression des contenus répétés d’une section à l’autre.
IA responsable : application des règles de sécurité et des politiques internes.
Contenus inexacts : un modèle de détection des hallucinations repère et retire les passages erronés.
Liens d’images défectueux : suppression des images cassées.
Le brevet décrit une exclusion des contenus inexacts que leur réécriture.
La revendication 12 précise aussi que la déduplication s’appuie sur les liens cités dans les sections. Autrement dit, la source attribuée à un passage sert de repère pour identifier les doublons.
Un modèle d’interface assemble texte, tableaux et cartes de réponse
Dernière étape : la mise en forme. Un modèle de correspondance associe à chaque section des « answer cards », des cartes qui donnent une réponse rapide à une question ou à une sous-question. Ces cartes peuvent contenir du texte, des images, de l’audio, de la vidéo ou des animations, et embarquent des métadonnées pour que le modèle comprenne leur contexte.
Un « generative UI layout model » détermine ensuite la disposition de l’ensemble : ordre des sections, emplacement des éléments, styles. Selon les revendications, ce modèle fonctionne sur une base heuristique, à partir des caractéristiques du contenu.
Les maquettes du brevet donnent une idée du rendu final :
Une table des matières : à gauche, avec les sections du document.
La réponse directe en titre : suivie d’un texte, d’une image et d’un tableau.
Une mention des sources : « Based on 2 sources », avec les liens correspondants.
Un panneau « Deep Search » : il affiche l’intention retenue, les thèmes connexes et les liens consultés.
Pendant la génération, un indicateur montre les étapes en cours (« Understanding query », « Searching selected items », « Ranking by understanding ») et annonce une attente d’environ 10 secondes.
Des réponses mises en cache tant que les résultats ne bougent pas trop
Le dernier point relevé par Ian Sorin concerne la réutilisation des réponses. Le brevet indique que, lorsqu’une requête identique ou proche produit le même ensemble de liens, le système peut resservir le document génératif déjà créé sans rappeler les modèles d’IA. Le document n’est mis à jour que lorsque l’ensemble des résultats diffère au-delà d’un seuil.
Pour les professionnels, ce mécanisme a une conséquence concrète : une page qui entre dans les résultats sélectionnés ne serait pas forcément prise en compte immédiatement, tant que la liste globale des liens reste proche de la précédente. À l’inverse, une réponse déjà en cache peut continuer à citer une source pendant un certain temps.
Ce passage figure toutefois dans la description du brevet et non dans ses revendications, qui définissent ce que Microsoft protège juridiquement. Le texte ne précise pas non plus la valeur du seuil de changement, ni la durée de conservation des réponses en cache. Reste donc à savoir dans quelle mesure Bing applique réellement cette logique de réutilisation, et à quel rythme ses réponses génératives sont recalculées.
Google recrute un « Principal, UX, Search Discover » de niveau directeur, basé à Mountain View ou New York, pour transformer Discover en flux proactif et hyper-personnalisé, selon une offre repérée par Damien Andell.
L'offre décrit Discover comme un assistant personnel qui aide les utilisateurs à progresser vers leurs objectifs et à passer de l'inspiration à l'action, grâce à des formats générés par l'IA déployés à grande échelle.
Le poste implique YouTube, Shopping, Chrome et Android, et le profil recherché doit savoir unifier les cadres de personnalisation de plusieurs produits et définir une stratégie pour les jeunes publics.
Google affirme vouloir centrer le flux sur les voix et sources humaines et cherche quelqu'un capable de construire un échange de valeur avec les créateurs et éditeurs, sans préciser sa forme.
Google recrute un directeur UX pour réinventer Discover
Pour rappel, Google Discover est le flux de contenus recommandés affiché dans l’application Google et sur la page d’accueil mobile de Google. Il propose des articles et des vidéos selon les centres d’intérêt de l’utilisateur, sans qu’aucune requête soit tapée.
Selon l’offre, la personne recrutée pilotera la stratégie et l’exécution UX (expérience utilisateur) pour faire de Discover un flux proactif et hyper-personnalisé. Elle dirigera les projets de design destinés à redéfinir les interactions du flux, les formats de contenus et les expériences d’exploration fondées sur l’IA. Le poste est rémunéré entre 275 000 et 382 000 dollars par an aux États-Unis, auxquels s’ajoutent un bonus cible de 30 % et des actions. Le profil exigé est expérimenté : 15 ans de management d’équipes UX dans des groupes technologiques mondiaux, et une expérience de la conception de flux grand public.
Discover pourrait devenir un assistant hyper-personnalisé
La première responsabilité listée résume l’ambition. Le futur responsable devra porter la vision qui doit faire de Discover une expérience de « concierge » proactive et hyper-personnalisée. Le terme est à prendre au sens hôtelier : un service qui anticipe les besoins et agit pour l’utilisateur, proche d’un assistant personnel. Cet assistant doit aider les utilisateurs à progresser dans leurs objectifs.
Une autre responsabilité prolonge cette idée. Discover doit servir une base d’utilisateurs très large tout en permettant aux utilisateurs existants d’aller plus loin, en passant sans rupture de l’inspiration à l’action. Jusqu’ici, Discover servait surtout à proposer des lectures. L’offre décrit désormais un outil qui accompagne l’utilisateur jusqu’à un résultat concret. Elle ne précise pas quelles « actions » sont visées.
Les formats IA vont s’étendre, avec une place revendiquée pour les « voix humaines »
Pour les formats, l’offre fixe une feuille de route claire : déployer à grande échelle les formats générés par l’IA, concevoir de nouveaux mécanismes d’engagement et donner plus de place aux voix et aux points de vue humains dans le flux. Une phrase précise l’équilibre recherché : tirer parti des capacités de l’IA tout en plaçant au centre les voix et les sources humaines.
Le recrutement lui-même reflète cette orientation IA. Parmi les qualifications souhaitées figure l’expérience de la promotion d’outils de design « nativement IA » et de prototypage rapide. L’offre cite AI Studio (la plateforme de Google pour prototyper avec ses modèles Gemini) et le « vibe coding », c’est-à-dire le fait de produire du code en décrivant ce qu’on veut à une IA plutôt qu’en l’écrivant ligne à ligne. Google y décrit Discover comme un espace de design « AI-native » complexe.
YouTube, Shopping, Chrome et Android associés à une expérience unifiée
Le poste implique une collaboration étroite avec les directions Produit, Ingénierie, Data Science et Recherche UX, mais aussi avec plusieurs autres entités de Google : YouTube, Shopping, Chrome et Android. Objectif affiché : proposer une expérience unifiée.
Les qualifications souhaitées vont dans le même sens. Google recherche quelqu’un qui a déjà mené des projets transverses à plusieurs produits et unifié des cadres de personnalisation. Les signaux d’intérêt collectés sur YouTube, Chrome ou Android pourraient doncpeser davantage dans les recommandations de Discover. La présence de Shopping, associée à l’idée de passer « de l’inspiration à l’action », suggère aussi qu’une partie de ces actions pourrait être commerciale. L’offre ne donne toutefois aucun exemple qui permette de le confirmer.
Jeunes publics et éditeurs : deux cibles citées sans précision
Deux autres qualifications souhaitées en disent long sur les priorités de Google. La première porte sur la capacité à définir une stratégie produit pour les jeunes publics et à trouver l’adéquation entre produit et marché (le « product-market fit ») dans des environnements de contenus concurrentiels. L’offre ne nomme aucun concurrent, mais les flux de recommandation qui captent l’attention des plus jeunes sont aujourd’hui ceux de TikTok ou d’Instagram.
La seconde concerne directement les éditeurs : Google cherche un profil ayant déjà construit des « échanges de valeur » avec les créateurs et les éditeurs. C’est la seule mention, dans l’offre, de la contrepartie que pourraient obtenir ceux qui alimentent le flux. Sa nature reste inconnue : trafic, visibilité de marque ou autre forme de rétribution. L’offre ne dit pas non plus si ce futur Discover sera déployé hors des États-Unis, ni à quelle échéance.
Le parasite SEO (malin pour les uns, black hat pour les autres) consiste à publier un contenu sur un site tiers qui a la confiance de Google, pour profiter de son autorité. On s'en sert pour faire ranker la page elle-même sur des requêtes que son propre site n'atteindrait jamais, ou pour obtenir un backlink depuis un domaine prestigieux. Les supports habituels sont les grands médias qui vendent des articles sponsorisés, les plateformes de publication ouvertes à tous, les forums et les pages de profil.
Comment Outlook India a vécu du parasite SEO
Le cas le plus connu reste celui d'Outlook India, un magazine d'actualité indien. En septembre 2023, un fil très partagé sur X montrait comment sa rubrique d'articles sponsorisés dominait Google sur les rencontres, les compléments alimentaires ou les casinos. Les affiliés y achetaient un article pour 150 à 175 dollars, et la rubrique comptait plus de 18 000 pages. Le fil en déduisait près de 2,7 millions de dollars de revenus pour le média. Google a depuis visé ce genre de pratique avec sa règle sur l'abus de réputation de site, appliquée depuis mai 2024 et durcie en novembre 2024.
Comment fonctionnait l'astuce des Bases de l'ANCT ?
Les Bases du numérique d'intérêt général est une plateforme de l'Agence nationale de la cohésion des territoires (ANCT), où médiateurs, associations et collectivités partagent des ressources pour accompagner le public dans ses usages du numérique. Il suffit d'une adresse e-mail pour y créer un compte et publier.
L'astuce était simple : on publiait une ressource avec un lien vers son site, et on obtenait un backlink dofollow gratuit sur un domaine en .gouv.fr. D'après l'équipe de la plateforme, la page était indexée en moins de 24 heures. Le spot circulait depuis un moment chez les SEO, et les ressources du type « les meilleurs consultants SEO en France » ou « simulateur PEA gratuit » s'y multipliaient.
Le 30 septembre, une vidéo publiée sur X (près de 10 000 vues) le présentait comme un « backlink DF puissant ». Le 4 octobre, une capture partagée dans la discussion montrait une ressource des Bases, « Les 7 meilleures banques en ligne en 2026 », en premier résultat naturel sur « meilleure banque en ligne », deux jours après sa publication. « C'est le parasite le plus puissant que je connaisse », commentait un SEO.
Tous les liens des utilisateurs passent en nofollow ugc
Le lendemain, le 5 octobre, l'équipe a intégré un correctif, documenté publiquement dans le code source de la plateforme. Tous les liens saisis par les utilisateurs portent désormais l'attribut rel="nofollow ugc", y compris dans les ressources publiées avant. Les outils de backlinks peuvent encore les afficher en dofollow tant qu'ils n'ont pas réexploré les pages.
Un spot refermé en quelques jours
La modération a suivi. Plusieurs ressources consacrées au SEO renvoient désormais une erreur 404 : un audit SEO gratuit, une présentation des trois types de SEO, un comparatif des meilleurs outils SEO de 2026. Le 6 octobre, un SEO racontait sur X que sa ressource, publiée sans lien ni promotion, avait été supprimée tout de suite.
Google, lui, n'a pas encore fait le ménage. Le 10 octobre, la ressource « Meilleur outil SEO 2026 », publiée une semaine plus tôt et passée depuis en 404, était toujours 3e sur « meilleur outil seo ». Elle arrivait juste sous notre sélection d'outils SEO, toujours en ligne pour ceux qui cherchaient un comparatif
Recherche « meilleur outil seo » sur Google, le 10 octobre 2026. La page des Bases renvoie une erreur 404 mais reste indexée en troisième position.
Un petit mot pour l'équipe des Bases, si vous passez par ici Au moment où nous écrivons ces lignes, votre fichier robots.txt affiche Disallow: /. C'est peut-être voulu, mais en attendant, Google ne peut plus explorer aucune page du site, les bonnes ressources comprises. Ce serait dommage de les priver de lecteurs
Faut-il se lancer dans le parasite SEO ?
Des spots comme celui des Bases, il en existe des centaines, et le parasite SEO fonctionne plutôt bien. Ces liens ont de la puissance, les pages se positionnent vite sur presque n'importe quel mot-clé et apportent de la visibilité à des sites ou à des marques. Pour ranker vite sur une courte durée, la méthode est simple et efficace, et il faut une bonne dose de créativité pour dénicher ces spots.
Pour un site qui veut durer, nous y voyons quatre problèmes :
Des règles enfreintes : Google range ces pratiques dans le spam de liens et l'abus de réputation de site, et la plupart des plateformes les interdisent dans leur charte.
Un résultat qui dépend des autres : la page vit sur le site d'un tiers, qui peut la supprimer ou passer ses liens en nofollow du jour au lendemain, comme ici.
Un risque pour le site qui reçoit les liens : une accumulation de liens artificiels peut valoir une action manuelle de Google.
Un risque d'image pour les marques installées : les captures d'écran circulent vite, et une marque connue n'a rien à gagner à être citée dans une discussion sur le spam d'une plateforme publique.
Nous ne recommandons donc pas cette pratique, aussi maline soit-elle. Sur Les Bases, il y avait pourtant mieux à faire : un guide pour repérer une arnaque ou vérifier la fiabilité d'un site aurait eu sa place sur la plateforme, et il y serait sans doute encore.
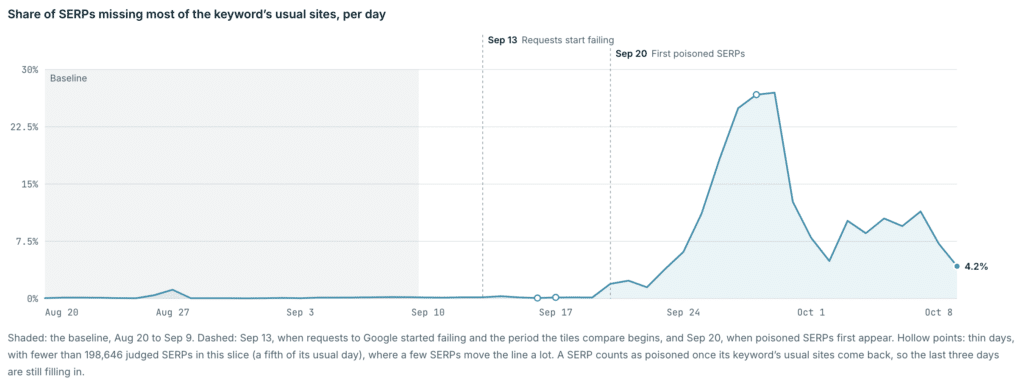


 Au moment où nous écrivons ces lignes, votre fichier
